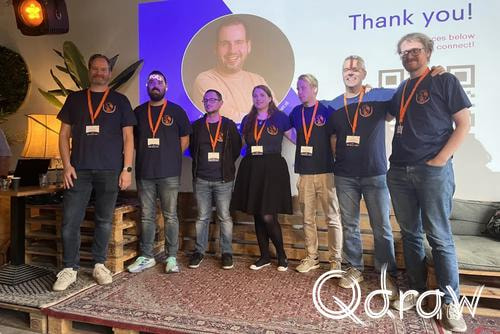
Tijdens de eerste editie van het Dutch Umbraco Alliance Festival namen Lottie en Sebastian van Umbraco HQ de zaal mee door een jaar vol ontwikkelingen bij Umbraco. De rode draad van de sessie: bijna alles wat er dit jaar is gebouwd, is direct terug te voeren op feedback en initiatieven vanuit de community. Hieronder een overzicht van de belangrijkste updates. Deze blog is geschreven voor IT professionals. In dit blog bespreken we enkele hoogtepunten. In deze blog geef ik een samenvatting van de verschillende sessies:
Updates vanuit Umbraco HQ
Waar staan we nu?
Umbraco 17 is nog altijd de actuele LTS-versie en blijft ondersteund tot december 2029. Umbraco 18 is de huidige STS-release. STS is een versie met een kortere tijd dat die ondersteund wordt. Wie nog op Umbraco versie 13 draait, moet nu echt actie ondernemen: die versie bereikt binnenkort end-of-life, tenzij je kiest voor een extended support contract. Naast de CMS-core is de productlijn dit jaar uitgebreid met twee nieuwe open source add-ons: Umbraco AI en Umbraco Automate. Het team benadrukt nadrukkelijk dat dit geen los zand is, maar een samenhangend portfolio dat echte, dagelijkse problemen van bureaus oplost.
Umbraco AI: AI op jouw voorwaarden
Umbraco AI is een optionele add-on bovenop Umbraco en is dit jaar flink doorontwikkeld: betere prompts, permissie- en contextbewuste tools en een stevigere basis voor testen en evalueren. Er zijn ook nieuwe providers toegevoegd, waaronder Alibaba. De grootste toevoeging is Umbraco Copilot Workspace, momenteel als release candidate beschikbaar. Waar het bestaande AI-paneel alleen kan werken op de pagina die je op dat moment open hebt staan, biedt Workspace een volwaardige sectie met projecten, chats en resources, met een interface die opvallend veel weg heeft van Claude's eigen werkomgeving. Je kunt er meerdere content- en media-items aan toevoegen en er bijvoorbeeld de kwartaalcijfers aan diverse artikelen mee vernieuwen. Er zit ook bescherming ingebouwd voor redacteuren: eenvoudige acties zoals het aanmaken van een pagina vragen alleen een goedkeuring, maar bij het verwijderen of depubliceren van content moet je expliciet een bevestigingswoord intypen. Deze functionaliteit is mede tot stand gekomen dankzij de Umbraco AI advisory board. Een mooi voorbeeld: community-lid Kenneth werkt samen met het team aan beeldgeneratie waarbij de image cropper niet alleen kan uitsnijden, maar ook content kan aanvullen, bijvoorbeeld een boom die "doorloopt" buiten de originele foto. Deze functie zit nog achter een feature flag.
Umbraco in AI: MCP-servers en agent skills
Naast AI ín Umbraco werkt het team ook aan Umbraco vindbaar maken vóór AI-tools. Er is inmiddels een (bèta) editor MCP-server, een SDK en vooral Create Umbraco MCP Server: een CLI-tool die pakketontwikkelaars stap voor stap helpt een volledige MCP-server te genereren voor hun eigen implementatie. Op het gebied van agent skills zijn nu de Umbraco backoffice skills beschikbaar, met documentatie en skills die continu synchroon worden gehouden. Cloud skills volgen later. Ook komt er binnenkort hosted MCP in Umbraco Cloud, zodat je geen lokale MCP-server meer hoeft op te zetten en voor niet-cloud sites is er een open source variant. Community-bijdragen die hierbij hielpen: Dean Lee bouwde het package UpDoc (documenten importeren als nodes) en stresstestte de MCP-servers grondig, waarbij hij waardevolle bugs vond. Matt Weiss, een van de oorspronkelijke auteurs van de Umbraco MCP-server, werkt aan een self-hosted variant via een Cloudflare worker én kreeg MCP werkend als CLI.
Umbraco Forms: het belang van issues melden
Een mooi eerbetoon ging naar Bjarne, die dit jaar 85 bugs meldde op de publieke issue tracker van Umbraco Forms, waarvan de meeste inmiddels zijn opgelost, plus 48 suggesties op de discussieborden. Als MVP kreeg hij toegang tot de broncode van de commerciële producten en diende hij vier pull requests in. De boodschap is duidelijk: alle commerciële Umbraco-producten hebben publieke issue trackers, dus houd feedback niet voor jezelf.
Umbraco Automate: community bouwt door
Sinds de release van Umbraco Automate zijn er nieuwe triggers bijgekomen vanuit Umbraco Forms, Umbraco Engage (A/B-testen, persona's) en Umbraco Commerce. Community-leden gingen er meteen mee aan de slag:
Owain koppelde zijn blog automatisch aan LinkedIn, Bluesky en Mastodon.
Paul Wright bouwde tijdregistratie, notificaties, QR-codegeneratie en zelfs een weer- en Lego-integratie.
Erik Jan maakte generieke acties en een Cloudflare-integratie
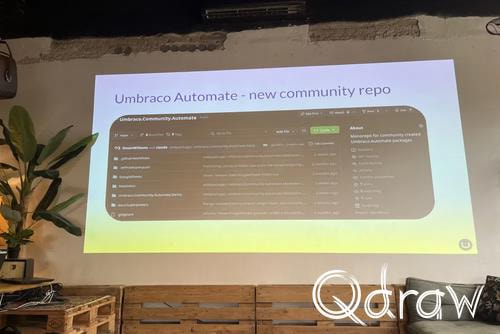
Warren bouwde een volledige Google Sheets-integratie. Deze losse extensies worden nu gebundeld in een gezamenlijke community-repository, zodat iedereen er makkelijker gebruik van kan maken.
Umbraco Cloud: blokkades weggenomen
Een Zweeds bureau, Toxic Interactive, gaf via de nieuwe "cloud success team sessions" ongezouten feedback op Umbraco Cloud, met name over de navigatie in het cloudportaal. Dat leidt tot concrete verbeteringen:
Scheduled upgrades: de backend hiervoor (in Umbraco cloud) ging vandaag live, zodat je straks zelf kunt kiezen wanneer je site gepatcht wordt.
Alerts en notificaties: instelbaar op organisatie- en projectniveau, voor zaken als DDoS-aanvallen en deployment-fouten.
Aanbevelingen/health checks: Umbraco Cloud gaat straks signaleren als je bijvoorbeeld betaalt voor iets dat je niet gebruikt, zonder dat automatisch aan te passen, wel om je bewust te maken.
Artifact deployments & rolling updates (Q4): de langverwachte mogelijkheid om je eigen CI/CD-pipeline te gebruiken en naar Cloud te deployen zoals bij elke andere hosting provider. Dit staat al sinds 2019 op het verlanglijstje van community-lid Lennard en is nu eindelijk mogelijk. Early access is beschikbaar via aanmelding.
Umbraco 19: search en herbruikbare content
De bèta van Umbraco 19 komt in oktober, met twee grote nieuwe features: Umbraco Search wordt geïntegreerd in de CMS-core (bovenop Examine/Lucene.net) en maakt het mogelijk om eenvoudig te wisselen van search-engine, voorbeelden zijn al gebouwd voor Elasticsearch en Typesense. Nieuw zijn ingebouwde segmentatie, automatisch afgeschermde content, betere meertaligheid en zero-downtime index rebuilding: de nieuwe index wordt eerst volledig opgebouwd en getest en pas daarna live geschakeld. Community-input speelde hier een grote rol: De bouwer van Examine dacht mee over de vervanging, Acadius zorgde dat zero-downtime rebuilds uitschakelbaar zijn en Fernando overtuigde het team om documenten en media toch gescheiden te houden (met optie om te combineren). De tweede grote feature heet uiteindelijk "Reusable Content of Blocks" (na wat interne verwarring over de naam). Je kunt blocks nu kiezen uit een centrale elementenbibliotheek: gerefereerde (globale) blocks zijn paars met een link-icoon, lokale blocks blijven blauw. Je kunt een lokaal block naar de bibliotheek overzetten (globaal maken) of juist loskoppelen (een lokale kopie maken zonder het globale element te wijzigen). Dit werkt in alle vier de block-editors: block grid, block list, de losse block editor en de rich text editor. Belangrijk: instellingen (zoals een achtergrondkleur) blijven altijd lokaal, alleen de content zelf is globaal. Ook hier weer community-vingerafdrukken: Miguel en Ravi stelden de naam "reusable blocks/content" voor, Lee Keller bedacht de term "library" (in plaats van "repository"), Robert vroeg om scoping per site zodat instellingen niet gaan "lekken" en Espen zorgde ervoor dat lokale overrides nooit automatisch globaal worden.
Packages en de kracht van bijdragen
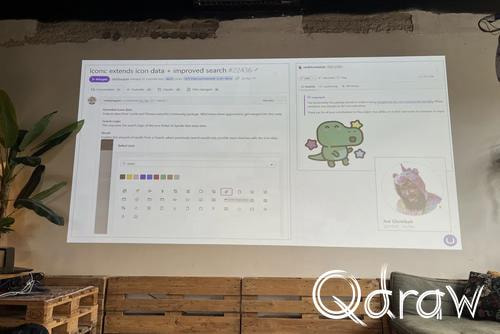
Ook op pakketniveau blijft de community het CMS verrijken. Joe Glombek bouwde Umbicosaurus, een pakket met vriendelijke aliassen voor iconen (zoek op "paper" in plaats van "attachment"). Met zijn toestemming is dit sinds versie 17.4 in de core opgenomen, inclusief fuzzy search. Luuk Peters bouwde een package voor geavanceerde permissies en ontdekte daarbij inconsistenties tussen API en UI die vervolgens zijn opgelost en won bovendien de TikTok-competitie van het festival.
Tot slot
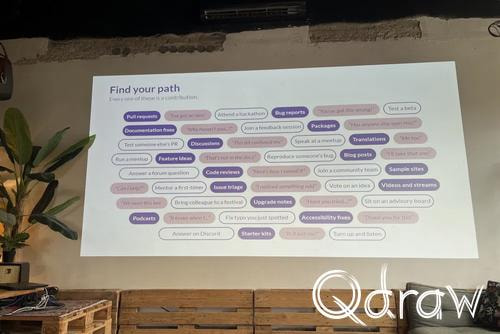
De kernboodschap van de sessie was minstens zo belangrijk als de featurelijst zelf: bijna elke verbetering die vandaag werd getoond, is voortgekomen uit een community-lid dat een issue meldde, een package bouwde, of gewoon hardop zei "dit klopt niet". Het team lanceert nu ook een nieuw initiatief genaamd "From Lurker to Leader": elke paar weken een inspirerend verhaal over iemands eerste stappen als contributor, bedoeld om mensen (met expliciete aandacht voor meer diversiteit) te stimuleren zelf ook bij te dragen.
Van AI-scepticus naar AI-advocaat: Luuk Peters over zijn workflow bij Proud Nerds
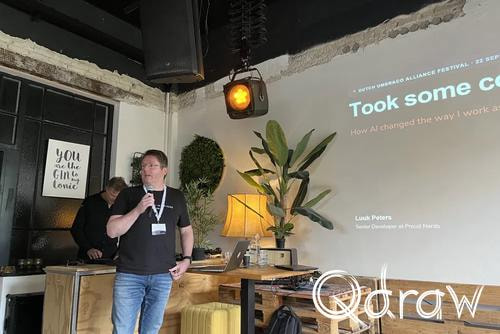
Tijdens het Dutch Umbraco Alliance Festival nam Luuk Peters, senior developer bij Proud Nerds in Nijmegen en oprichter van onder andere Advanced Permissions en Umbra Desktop, de zaal mee in zijn persoonlijke reis: van uitgesproken AI-scepticus naar iemand die nauwelijks nog zelf code schrijft. Een eerlijk en praktisch verhaal over wat er precies veranderde en hoe hij AI nu inzet, zowel individueel als binnen een heel bureau.
De scepticus
Luuk trapt af met een geruststellende zelfkarakterisering: hij houdt niet van verandering. Als bewijs voert hij zijn CV op, 21 jaar bij hetzelfde bedrijf (ondanks een fusie), begonnen met Visual Studio 2003 en nog altijd Visual Studio gebruikend en actief in Umbraco sinds versie 4, inmiddels toe aan versie 18. Hij omschrijft zichzelf als iemand die zijn manier van werken tot in de puntjes heeft geperfectioneerd: perfecte inspringing, XML-documentatie, het liefst geen pull request zonder inline documentatie. Zijn eerste kennismaking met AI, via GitHub Copilot op het werk, was dan ook een moeizame. Hij vertrouwde de suggesties niet, de Umbraco-broncode was simpelweg te groot en te complex voor de tool om goed te begrijpen en hij voelde zich voortdurend tegen de AI aan het vechten in plaats van ermee samen te werken. Toen Anthropic's CEO in maart 2025 voorspelde dat AI binnen twaalf maanden het merendeel van de code zou schrijven, geloofde Luuk er geen woord van.
Wat er veranderde
En toch: inmiddels schrijft hij nauwelijks nog zelf code en het kan hem niet eens meer schelen hoe die code er op microniveau uitziet. De omslag kwam er niet door een simpele conclusie, maar door een besef: hij houdt niet zozeer van code schrijven, hij houdt van het opleveren van coole features. Code schrijven was daarbij soms eerder een last dan een doel. Met Claude en specifiek Claude Desktop, zijn dagelijkse IDE naast Visual Studio, veranderde dat. Hij noemt drie concrete voordelen:
Sparren en itereren: features brainstormen en makkelijk aanpassen ("verplaats die knop en pas alle bijbehorende code aan") zonder dat het de moeite niet meer waard voelt.
Parallel werken: meerdere prompts tegelijk laten draaien, ook tijdens een meeting, met als enige minpunt de vijf-uurs sessielimiet van Claude, die je soms zomaar kunt verspillen.
Grondiger onderzoek dankzij grotere context: hierdoor kan hij extensiepunten in Umbraco vinden zonder bestaande functionaliteit opnieuw te bouwen.
Dat laatste punt bracht hem letterlijk tot een nieuwe Umbraco plugin: Advanced Permissions. Een feature die al jaren op de roadmap stond maar er nooit kwam, omdat het permissiesysteem van Umbraco in complexe scenario's tekortschiet. Dankzij AI kon hij de broncode grondig genoeg doorgronden om het alsnog te bouwen en ontdekte hij er meteen een paar bugs in.
Hoe hij nu werkt
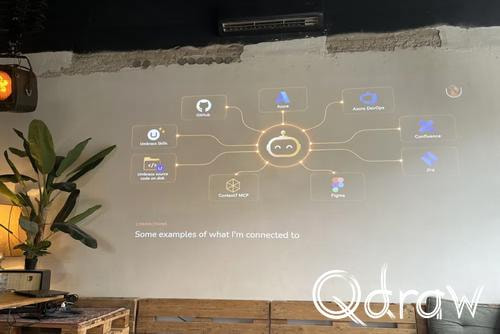
Luuk deelt een gedetailleerde blik in zijn workflow, met de kanttekening dat dit is wat voor hém werkt, niet een dwingend advies. Context is koning. Hij verbindt Claude aan MCP-servers (GitHub, Azure DevOps, Azure, Confluence, Jira, Figma, Context7), maar waarschuwt dat elke actieve MCP tokens kost, ook ongebruikt. Verder werkt hij graag met lokale bestanden: de Umbraco-broncode staat lokaal op zijn machine, wat sneller doorzoekbaar is dan via GitHub. Umbraco skills noemt hij essentieel voor wie extensies bouwt. Security serieus nemen. Omdat een AI-agent lokaal commando's kan uitvoeren, zeker in "autopilot"-modus, pleit hij voor het standaard beperken van toegangsrechten. Bij Proud Nerds is bijvoorbeeld expliciet geregeld dat een Azure-koppeling nooit een productiedatabase kan verwijderen: wat jij kunt, kan je AI-agent namelijk ook. Plan, itereer, begrijp. Hij gebruikt de skillset Superpowers, die een gestructureerde workflow afdwingt: eerst een plan maken (als markdown-bestand), dat plan grondig doornemen en vooral, echt begrijpen wat er gebouwd gaat worden. Zijn devies: behandel de AI-agent als een collega. Vraag door als het een bepaalde tool of aanpak voorstelt ("waarom deze tool, waarom niet die drie andere?"), zodat de AI gedwongen wordt zijn keuzes te onderbouwen. Het plan opslaan op schijf (niet alleen in de sessie) is daarbij cruciaal, zodat kennis niet verloren gaat als een sessie wordt gearchiveerd. Bouwen met een review-loop. De AI extensie Superpowers werkt met sub-agents die elk hun eigen, onbevooroordeelde context krijgen voor een specifieke taak, gevolgd door een review-agent en een orchestrator die alles overziet. Test-driven development is daarbij een vast onderdeel: eerst een falende test schrijven, dan pas implementeren, slaagt de test meteen, dan is er vermoedelijk iets mis met de test zelf. Pull requests door een andere bril. Luuk laat PR's het liefst beoordelen door een ander model of een verse sessie, onbevooroordeeld door eerdere context. Hij bouwde er zelfs een eigen skill voor, die op basis van de complexiteit en het risico van een PR bepaalt hoe diepgaand gecontroleerd moet worden, bij de hoogste controle-diepte wordt de hele repository gebouwd en getest. De menselijke check blijft volgens hem onmisbaar, niet om elke regel code te controleren, maar om overkoepelende architectuurkeuzes te toetsen en te herkennen wanneer AI iets herbouwt dat al bestaat als package of helper.
Opschalen naar bureauniveau
Bij agencyprojecten met meerdere developers komt er een extra laag bij: iedereen werkt anders, heeft een ander ervaringsniveau en kennisoverdracht is essentieel. Proud Nerds bouwt daarom een eigen skillset die bepaalt hoe user stories, checklists, PR-richtlijnen en codestandaarden eruit moeten zien, bijvoorbeeld de eis dat acceptatiecriteria altijd functioneel (niet technisch) worden geformuleerd en volledig herleidbaar zijn uit de beschrijving. Bij een groter, modulair klantproject (met meerdere pricing tiers) begon het allemaal met Architecture Decision Records (ADR's) als allereerste commit in de repository, nog vóór er een regel code was geschreven. Deze vastgelegde keuzes, plannen en user stories geven de AI vervolgens het grotere plaatje mee bij elke volgende taak, waardoor het zelfs kan signaleren wanneer nieuw werk niet meer overeenkomt met een bestaande user story.
Neemt AI je baan over?
Luuks antwoord: nee, niet op dit moment, met een sterretje. Hij vergelijkt de omslag met eerdere technologische sprongen: van assembly naar hogere programmeertalen, het vertrouwen dat we inmiddels in compilers hebben, de komst van Photoshop. AI is een tool, geen vervanging van het vak. Softwareontwikkeling ging volgens hem nooit alleen over code, maar over het begrijpen van de vraag van de klant, het kiezen van het juiste gereedschap voor de klus en gevoel voor UX. Als voorbeeld noemt hij Umbra Desktop: een volledig met AI gebouwd package waarvan hij zelf geen regel code schreef, maar waarbij al het UX-denken en de designkeuzes wél van hem kwamen. Zijn advies aan de zaal: ken de tool, gebruik de tool en bepaal zelf bewust waar en hoe je AI wilt inzetten in je werk, wie dat nú niet doet, loopt op termijn wél risico.
Microsoft Aspire: hoe je local development weer leuk maakt
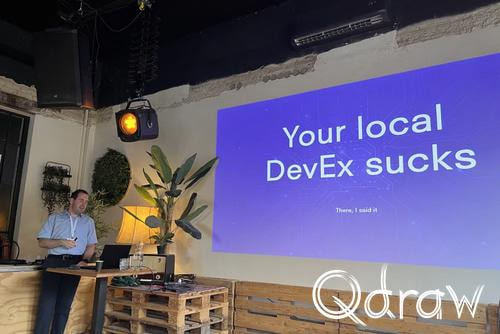
Thimo Koolen, .NET software consultant en regelmatig spreker op dit soort events, nam de zaal tijdens het festival mee in de wereld van Microsoft Aspire. Zijn boodschap: de meeste software is complex en dat begint al bij het simpelweg opstarten van een project op je eigen laptop.
De pijn die iedereen herkent
Thimo opent met een herkenbaar scenario: je sluit aan bij een nieuw team of project, krijgt een laptop en account (met een beetje geluk werkt alles al op dag één), kloont de repository, opent je IDE naar keuze en dan zoek je naar het README-bestand. Soms is dat compleet, vaak is het verouderd, mist er iets, of is er gewoon geen README.md. Onboarding kan hierdoor letterlijk weken kosten. Thimo vertelt over een oud, complex legacy content framework waarbij het alleen al meer dan een week kostte om lokaal aan de praat te krijgen. En het stopt niet bij onboarding. Werk je aan een applicatie met acht services, dan heb je al snel acht terminals open staan. De API crasht omdat de database nog niet is opgestart. Poorten zijn al in gebruik en moeten handmatig beheerd worden. Je docker-compose bestand groeit uit tot een onleesbaar YAML-monster. Connection strings staan hardcoded en verspreid door de codebase. En dan is er nog wat Thimo treffend "service hiding" noemt: service A heeft service B nodig, maar op welke poort draait die ook alweer? Debuggen over meerdere services heen wordt al snel een crime.
Wat is Aspire eigenlijk?
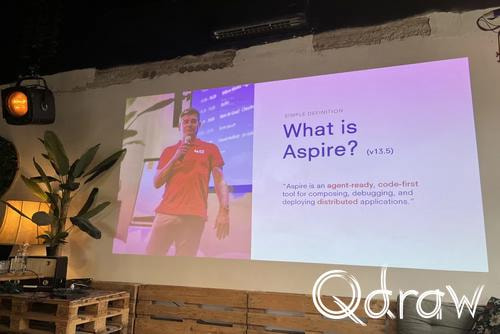
Thimo's definitie: Aspire is een polyglot orchestration tool waarmee je applicaties lokaal kunt definiëren, draaien en distribueren met één enkel commando.
Polyglot betekent dat .NET, Python, JavaScript, TypeScript, Rust en containers naadloos samenwerken, sinds Aspire 13 (uitgebracht afgelopen november, gelijktijdig met .NET 10) nog gemakkelijker dan voorheen.
Orchestratie houdt in dat alle services in de juiste volgorde opstarten, rekening houdend met onderlinge afhankelijkheden en dat ze elkaar automatisch kunnen vinden.
Lokaal betekent: op je eigen laptop.
Eén commando is letterlijk dotnet run of aspire start.
Interessant genoeg had het Aspire-team, toen ze twee jaar geleden begonnen, al vroeg gekozen voor een CLI, nog voordat MCP en AI-agents echt op de kaart stonden. Die vooruitziende blik betaalt zich nu uit: sinds versie 13.5 luidt de definitie dan ook "agent-ready, code-first tool for composing, debugging and deploying distributed applications." Agent-ready wil zeggen dat Aspire een MCP-server en skills aanbiedt waarmee AI-agents er goed mee overweg kunnen. Code-first betekent: geen YAML meer, alles in C# (of sinds kort ook TypeScript).
De bouwstenen van Aspire
Thimo verdeelt de out-of-the-box onderdelen in twee blokken: Dashboard & observability, gebaseerd op OpenTelemetry, de open standaard die door vrijwel elk modern observability-platform (zoals Application Insights) wordt ondersteund. Het dashboard fungeert als centrale UI voor logs, traces, health status en meer. CLI & tooling, de Aspire CLI werkt met Visual Studio, Rider, VS Code, of eigenlijk elke omgeving die .NET draait. Daarnaast zijn er service defaults: een .NET-project met verstandige standaardinstellingen voor health checks, resilience en service discovery. En centraal staat de app host: het orchestratieproject dat de architectuur van je applicatie beschrijft, welke services er zijn en hoe ze samenhangen. Verder biedt Aspire kant-en-klare integraties voor populaire diensten zoals SQL Server, Redis en RabbitMQ, deze NuGet-packages spinnen automatisch de bijbehorende container op. Er zijn ook community-integraties beschikbaar en je kunt er zelf een bouwen als iets niet bestaat.
Wat Aspire niet is
Thimo is duidelijk over de grenzen van de tool:
Geen vervanging voor Kubernetes. Aspire richt zich vooral op lokale ontwikkeling; deployment is mogelijk naar meerdere targets (waaronder Kubernetes en, als standaard, Azure Container Apps), maar dat is niet de kern.
Niet alleen voor .NET. De app host is nog wel C# of TypeScript, maar de services zelf kunnen in vrijwel elke taal geschreven zijn.
Geen fancy docker-compose. Het is echte code, met strong typing en het maakt gewoon onderdeel uit van je normale code review-proces.
Niet voor productiemonitoring. Het dashboard bewaart alles in-memory. Voor productie gebruik je iets als Grafana of Application Insights.
Geen alles-of-niets-verhaal. Je kunt met één service beginnen en incrementeel uitbreiden, of stoppen als het niet past.
Zo werkt het onder de motorkap
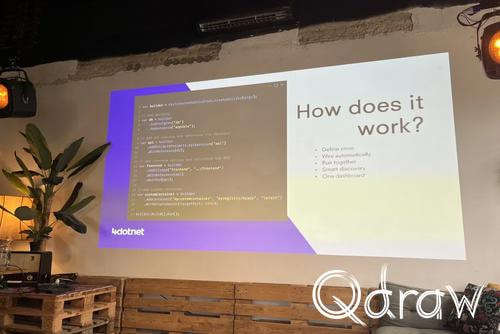
In een voorbeeld-app host laat hij zien hoe je met een DistributedApplicationBuilder een Postgres-database, een API en een Vite-frontend aan elkaar knoopt. Een referentie tussen services regelt automatisch de service discovery: de API "weet" van de database en krijgt er een connection string voor en de frontend wacht (WaitFor) tot de API healthy is voordat hij zelf opstart. Dit werkt allemaal via environment variables die de app settings overschrijven. De app host start bijvoorbeeld eerst SQL Server op, genereert daarna een connection string en injecteert die automatisch in de juiste service. Kortom: je app host is een blauwdruk van je distributed application, leesbaar in plain C#, zodat iedereen in het team precies ziet hoe alles samenhangt.
Waar Aspire uitblinkt (en waar niet)
Sterke punten:
Lokale ontwikkeling en onboarding worden drastisch eenvoudiger, clone, open, druk op F5 (in Visual Studio).
Polyglotte teams (bijvoorbeeld Python-backend, JavaScript-frontend, .NET-API) werken naadloos samen dankzij ingebouwde service discovery.
Cross-service debugging, vooral met de Aspire-plugin in VS Code.
Uitstekend voor wie microservices wil leren, het werkt bijna als een sandbox.
Sterke lokale Azure-integraties (denk aan de Azure Storage-emulator).
Zorgt voor teamalignment: iedereen kijkt naar dezelfde blueprint.
Minder geschikt voor:
Een simpele monoliet, dan is Aspire waarschijnlijk overkill.
Niet-gecontaineriseerde afhankelijkheden zoals lokale bestandssystemen of native tools.
Teams die niet primair met C# of TypeScript werken.
Productiemonitoring.
Legacy .NET Framework-toepassingen (Aspire draait op Kestrel, dus alles wat alleen via IIS werkt, valt af).
Zeer aangepaste of dichtgetimmerde infrastructuur.
Zoals Thimo het samenvat: Aspire kan een force multiplier zijn, maar dan moet je wel met meer dan één vermenigvuldigen.
De demo: een pretparkwebsite
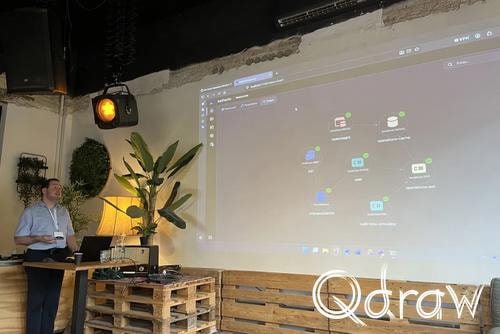
Om alles concreet te maken bouwde hij live een demo rond een fictief pretpark ("Artheua Resort"). In het dashboard zijn alle resources zichtbaar: een SQL Server-database (met een wachtwoord-parameter die veilig in user secrets wordt opgeslagen en een volume voor persistent data zodat de container niet steeds opnieuw hoeft op te starten), een Redis-cache voor operationele data, een .NET API en een Umbraco-frontend. In Umbraco maakte hij twee document types: een homepage en een "attraction" content type met onder meer een minimumlengte en angstniveau (van de attractie). De attractiepagina haalt data op van zowel Umbraco als de losse operations-API, waarbij wachttijden voor attracties live worden bijgewerkt via een custom command in het dashboard. Het echte hoogtepunt was de OpenTelemetry-integration: in het dashboard zag je precies hoe een request door de verschillende services liep, inclusief exacte doorlooptijden (23 milliseconden, tot hij voor demo-doeleinden bewust 2 seconden vertraging toevoegde). Met een zelfgebouwde "simulator" liet hij wachttijden voor attracties realistisch fluctueren, van een rustige ochtend tot een drukke piekdag, zichtbaar via custom metrics en traces, inclusief attractie-ID en scenario-informatie die rechtstreeks in de telemetrie werd meegegeven. Technisch gezien draait dit alles op de standaard service defaults (OpenTelemetry, health checks, service discovery, resilience via HTTP client defaults) gecombineerd met een strongly-typed HTTP-client die dankzij de http+https-notatie automatisch de juiste beschikbare verbinding kiest.
De belangrijkste lessen
Hij sluit af met drie kernpunten:
Aspire is code-first orchestratie, het is de blauwdruk van je systeem: kijk ernaar en je begrijpt meteen hoe alles samenhangt.
Aspire lost pijnpunten op van setup tot debuggen en service discovery, vooral voor lokale ontwikkeling.
Het is optioneel, begin met één service en bouw incrementeel uit, of laat het gewoon links liggen als het niet bij je team past. Aspire maakt microservices niet simpel, die complexiteit blijft bestaan, maar het organiseert die complexiteit wél, waardoor onboarding sneller gaat en debuggen effectiever wordt. Meer informatie is te vinden op aspire.dev, de source code staat volledig open source op github.com/microsoft/aspire (recent verhuisd naar de Microsoft-organisatie) en er is een actieve Discord-community waar ook het Aspire-team zelf aanwezig is.
Conclusie
Wat deze conferentie vooral duidelijk maakte, is dat de drie verhalen eigenlijk één en hetzelfde verhaal vertellen vanuit verschillende invalshoeken: AI en goede tooling verlagen de drempel om te bouwen, te experimenteren en bij te dragen, maar de mens blijft daarbij onmisbaar. Umbraco HQ liet zien hoe community-feedback het product jaar na jaar vormgeeft, Luuk Peters bewees dat AI geen bedreiging is maar een versneller wanneer je het kritisch en doordacht inzet, en Thimo Koolen toonde met Aspire hoe goede tooling complexiteit niet wegneemt maar wél beheersbaar maakt. De rode draad is duidelijk: technologie wordt pas echt waardevol wanneer een betrokken community en scherp nadenkende developers er hun stempel op drukken, of het nu gaat om een CMS, een AI-workflow of een orchestratietool.
Dutch Umbraco Alliance Festival | foto 1Dutch Umbraco Alliance Festival | foto 2Dutch Umbraco Alliance Festival | foto 3Dutch Umbraco Alliance Festival | foto 4Tiktok – Dutch Umbraco Alliance Festival | foto 5AI – Dutch Umbraco Alliance Festival | foto 6Aspire – Dutch Umbraco Alliance Festival | foto 7Aspire – Dutch Umbraco Alliance Festival | foto 8Aspire – Dutch Umbraco Alliance Festival | foto 9Aspire – Dutch Umbraco Alliance Festival | foto 10Aspire – Dutch Umbraco Alliance Festival | foto 11Aspire – Dutch Umbraco Alliance Festival | foto 12Organisatie | foto 13Dutch Umbraco Alliance Festival | foto 14
Op Techorama 2025 werden inzichten gedeeld over actuele thema’s binnen de IT en softwareontwikkeling. Deze blog is geschreven voor IT professionals. In dit blog bespreken we enkele hoogtepunten.
In deze blog geef ik een samenvatting van de verschillende sessies:
The Past, Present, and Future of AI for Application Developers — Steve Sanderson
Steve Sanderson begon zijn sessie met een simpele constatering: “AI makes work better.” En dat is nauwelijks overdreven. Twee jaar geleden gebruikte nog vrijwel niemand AI tijdens het ontwikkelen, nu ligt dat gebruik al rond de vijftig procent. De vraag is niet langer of we AI gaan gebruiken, maar hoe we ermee beginnen. Om die vraag te beantwoorden, nam Steve het publiek mee op een reis door de tijd — terug naar het begin van het begrip “kunstmatige intelligentie”.
Van Turing tot Eliza
In 1950 stelde Alan Turing zijn beroemde vraag: “Can machines think?” Hij bedacht de zogenaamde imitation game, later bekend geworden als de Turingtest — een manier om te bepalen of een machine menselijk genoeg kan converseren. In de jaren zestig ontstonden de eerste chatbots. Steve toonde live een klassieker: Eliza , een programma dat met simpele stringvervanging reageerde op wat je zei. Als je iets intypte, herhaalde Eliza het gewoon in de vorm van een vraag. Het werkte niet echt, maar het was een fascinerende illusie. Steve lachte: “People process it as intelligence — but it’s just string replacement.”
De fundamenten van voorspellende tekst
Daarna ging hij nog verder terug. In 1913 beschreef Andrey Markov de kans dat een volgende letter of woord afhangt van de vorige — de basis voor wat we nu Markov chains noemen. En in 1948 legde Claude Shannon met zijn informatietheorie de basis voor moderne taalmodellen. Hij liet zien hoe je op basis van letterfrequenties een tekst kunt laten “gokken” wat erna komt.
“Pro tip,” grapte Steve. “Everything is legitimate for AI.” En inderdaad: zelfs iets eenvoudigs als een letterrooster kan de kiem zijn van een taalmodel.
De doorbraak: Transformers
Pas in 2017 kwam de echte revolutie: de Transformer-architectuur. Die maakte het mogelijk om context op veel grotere schaal te begrijpen. Sindsdien is de groei van AI-modellen explosief. Steve toonde een overzicht van bekende modellen — van GPT-1 met 117 miljoen parameters tot GPT-4 , waarvan naar schatting 1,7 biljoen parameters onder de motorkap zitten. Daar tegenover staan open modellen als LLaMA en DeepSeek R1 , die ook snel aan terrein winnen.
Hoe een taalmodel leert
Om te laten zien hoe AI leert, trainde Steve live een kleine versie van GPT-2. Na één iteratie was de output pure chaos. Na honderd iteraties begon het model taalpatronen te herkennen. Na vijfhonderd iteraties produceerde het zinnen die grammaticaal klopten.
“It’s just predicting the next token,” zei Steve. “Chat completion is simply token prediction shaped into something we want to hear.”
Function calling en echte intelligentie
Maar moderne AI gaat verder dan tekstvoorspelling. Met function calling kan een model nu echte methodes aanroepen of data uit de echte wereld ophalen. Zo ontstaat een brug tussen tekstbegrip en praktische actie. Hij liet zien hoe dat werkt in toepassingen als:
Chat-interfaces
RAG (Retrieval-Augmented Generation)
Virtuele assistenten
C# in actie
Vervolgens stapte hij over naar de praktijk: AI integreren in .NET. Met Microsoft.Extensions.AI en IChatClient demonstreerde hij hoe je een AI-model eenvoudig laat samenvatten, vertalen of classificeren. Een voorbeeld met een vastgoedapplicatie liet zien hoe een AI automatisch eigenschappen uit een beschrijving kon extraheren en in JSON kon teruggeven.
Vision en reasoning
Steve liet ook multimodale toepassingen zien — modellen die niet alleen tekst, maar ook beelden begrijpen. Met GPT-4o-mini en lokale modellen via Hugging Face (een site waar veel AI modellen op staan) demonstreerde hij beeldclassificatie, zelfs draaiend in WebAssembly. Daarna ging het over reasoning models: AI die niet alleen voorspelt, maar nadenkt — patronen herkent, context begrijpt en keuzes maakt. Hij liet praktische voorbeelden zien:
Formulieren automatisch invullen op basis van clipboarddata
Slimme autocomplete
Semantische zoekfuncties
Spraakinterfaces, zoals in een auto-advertentie met voice-input
Tot slot
Aan het einde van zijn sessie benadrukte Steve dat de toekomst van AI niet alleen draait om grotere modellen, maar om betere modellen — systemen die begrijpen wat ze doen. AI wordt niet meer alleen een tool die code aanvult of tekst genereert, maar een integraal onderdeel van hoe we software bouwen. De lijn tussen mens en machine vervaagt en voor ontwikkelaars ligt daar niet een bedreiging, maar een kans: om slimmer, sneller en creatiever te bouwen dan ooit tevoren.
Agents of Change: Building AI Agents that Work (and Think) for Us – Jeff Prosise
Jeff Prosise stapte het podium op met een energieke glimlach en de belofte van “lots of demos.” Hij hield woord. Het volgende uur stond in het teken van een nieuwe golf binnen AI: autonome agents — systemen die niet alleen reageren, maar ook samenwerken, plannen en handelen.
“Think of them as microservices for AI,” zei Jeff. “Each agent does one thing extraordinarily well. Together, they can solve problems far more complex than any single model could.”
Wat zijn AI-agents eigenlijk?
Een AI-agent is in de basis een wrapper rondom een LLM (Large Language Model). Maar in plaats van simpelweg tekst te genereren, krijgt de agent autonomie en tools om specifieke taken uit te voeren: data ophalen, bestanden doorzoeken, berekeningen uitvoeren of zelfs API’s aanroepen. Jeff legde het uit als een soort bouwteam: jij levert de bouwstenen, AI zorgt voor de workflow en het framework biedt de infrastructuur voor communicatie tussen de agents.
Agentic frameworks: de bouwstenen van deze nieuwe golf
Hij liet vier populaire frameworks zien die deze manier van werken mogelijk maken:
Agents SDK / AutoGen – Een open-source framework van Microsoft voor het coördineren van meerdere agents. Ondersteunt RAG (Retrieval-Augmented Generation), verschillende conversatiepatronen en werkt met Python en .NET.
CrewAI – Een Python-framework waarin groepen (“crews”) van agents samenwerken. Rijke ondersteuning voor geheugen en toolgebruik.
Agno – Een open-source, LLM-agnostisch framework dat toolgebruik, persistentie en RAG ondersteunt, met een ingebouwde playground om workflows te testen.
OpenAI’s Agents SDK – Een meer Python-first benadering met ondersteuning voor geheugen, audio, tool use en web search.
De praktijk: agents die denken, plannen en samenwerken
Om te laten zien wat dat betekent, bouwde Jeff live een prototype. Op het scherm verscheen een fictieve vacature voor een CEO. Een agent analyseerde cv’s, beoordeelde kandidaten en gaf scores tussen 1 en 10 — allemaal in natuurlijke taal.
“One agent reads the resumes, another compares them to the job description, a third composes the response,” legde hij uit. “They pass information dynamically — one by one — like a team.”
De workflow verscheen als een soort chatinterface waarin agents met elkaar communiceerden. Jeff vroeg de AI zelfs om een rejection letter in the style of Dr. Seuss — en het werkte.
Hoe werkt dat technisch?
Achter de schermen gebeurt er veel. LLM’s zijn stateless, dus een agent-framework moet zelf geheugen bijhouden. Jeff liet zien hoe dat werkt met een eenvoudige in-memory database of met SQLite of MongoDB. Hij demonstreerde Agno, waarin agents eenvoudig worden gedefinieerd met een paar regels Python-code. Een agent heeft:
een instructieprompt,
een session ID,
en een streaming-output om tussentijdse resultaten te tonen.
Agno bevat ingebouwde tools voor o.a. samenvatten, rekenen, het ophalen van data (zoals via yfinance) en zelfs het genereren van afbeeldingen. Alles via function calling — waarbij de LLM een JSON-beschrijving van de gewenste functie opstelt, die vervolgens echt wordt uitgevoerd.
MCP – de nieuwe standaard voor agentcommunicatie
Daarna ging het over MCP (Model Context Protocol), een nieuwe standaard die LLM’s in staat stelt om functies en API’s te importeren alsof het lokale tools zijn. Bedrijven zijn druk bezig hun diensten via MCP beschikbaar te maken — van PayPal tot Salesforce. De voordelen:
Agno heeft zijn eigen MCP-server en ondersteunt multi-agent orchestration met vector databases en deelbare context.
Multi-agent samenwerking in actie
Tot slot liet Jeff een indrukwekkende demo zien van meerdere agents die samenwerkten aan een data-analyse. Een Database Agent haalde gegevens op, een Quant Agent verwerkte ze en een Visualization Agent genereerde de grafiek — alles binnen een teamstructuur, aangestuurd door een Team Lead Agent. In Python definieerde hij een Team-klasse met een members-property. Door share_member_interactions=True te zetten, konden de agents onderling informatie delen. Het resultaat verscheen als een live gegenereerde plot op het scherm.
De toekomst van agentic AI
Jeff sloot af met een vooruitblik: AI-agents zullen binnenkort samenwerken zoals menselijke teams dat doen — met rollen, taken en context. De ontwikkelaar definieert het speelveld, maar de agents bepalen de uitvoering.
“We’re entering the era of AI orchestration,” zei hij. “Where you don’t just build models — you build teams.”
Understanding Model Context Protocol (MCP) — Roelant Dieben
De sessie begon rustig, met een simpele titel op het scherm: “Understanding MCP.” Maar al snel werd duidelijk dat dit niet zomaar een technische uitleg zou worden — dit was een kijkje in wat velen de nieuwe ruggengraat van AI-integratie noemen.
De opkomst van MCP
Roelant trapte af met een glimlach: “MCP is nog geen jaar oud, maar het zorgt nu al voor flink wat buzz.” Zijn agenda was overzichtelijk:
Introductie
Wat is MCP en waarom de ophef
De fundamenten
Zelf een MCP-server bouwen
Belangrijkste inzichten
Hij grapte over de USB-analogie — “I hate this analogy, it had nine connectors” — maar gebruikte het toch om te illustreren wat MCP wil zijn: één universele standaard voor hoe taalmodellen met externe systemen praten.
Waarom MCP nodig is
LLM’s, legde Roelant uit, kennen jouw wereld niet. Ze hebben geen toegang tot je documenten, API’s of databases. Ze genereren tekst, maar zonder context weten ze niet wat relevant of actueel is.
“Context is everything to the model,” zei hij. “Good context makes agents smarter — and safer.”
MCP (Model Context Protocol) is ontworpen om dat probleem op te lossen. Het combineert memory, state en access — zodat een model kan werken met externe informatie op een veilige, gestandaardiseerde manier.
Wat is MCP?
MCP werd geïntroduceerd in november 2024 en is een open-source standaard die sterk doet denken aan bestaande protocollen als REST, LSP (Language Server Protocol) en JSON-RPC. Het is flexibel, webgebaseerd en bedoeld om de interactie tussen LLM’s, applicaties en tools te standaardiseren.
Demo: MCP in actie
Tijdens de demo opende hij Visual Studio Code en liet hij zien hoe GitHub Copilot, via MCP, kon communiceren met externe services. Hij vroeg: “Are there new papers on Hugging Face?” Copilot stuurde de vraag via een MCP server , die op zijn beurt de informatie ophaalde. Geen custom plugin meer nodig, geen API-sleutels overal verstopt — gewoon één gestandaardiseerde interface.
“Every LLM used to need its own interface,” zei Roelant. “MCP replaces all of that.”
Hij toonde een GitHub MCP registry , waar al honderden servers beschikbaar zijn — van Playwright tot Hugging Face.
Hoe MCP werkt
MCP draait om drie kerncomponenten:
Tools – functies of API-calls die een model kan gebruiken.
Resources – leesbare datasets, bestanden of endpoints.
Prompts – vooraf gedefinieerde templates voor AI-interacties.
Een MCP client roept tools aan of vult prompts in, terwijl een MCP server die tools en bronnen beschikbaar stelt. De communicatie verloopt via JSON-RPC , met endpoints zoals /tools/list en /tools/invoke. Roelant liet met de MCP Explorer zien hoe je de beschikbare tools kunt inspecteren, tokens kunt toevoegen en direct met servers kunt praten.
Lokale vs. externe MCP communicatie
Hij onderscheidde twee typen verbindingen:
STDIO – lokaal, bidirectioneel en met lage latency (bijvoorbeeld binnen je eigen machine of editor).
Streamable HTTP – voor externe, netwerkgebaseerde communicatie met authenticatie en streaming-ondersteuning.
STDIO is snel en betrouwbaar voor lokale agents; HTTP is ideaal voor cloudgebaseerde of remote toepassingen.
Pokémon: een verrassende analogie
De eerste slide was al in Pokemon stijl.
“It will make sense later,” had hij aan het begin gezegd — en dat deed het.
Hij legde de analogie uit:
Pokédex → MCP Registry
Pokémon → MCP Servers
Pokémon Skills → Tools
Pokémon Cards → Resources
Pokéball → Client
Trainer → Host
Battle → Task
Een speelse, maar effectieve manier om te laten zien hoe MCP een ecosysteem vormt waarin clients, servers en tools samenwerken.
Beveiliging en authenticatie
Omdat MCP toegang kan krijgen tot gevoelige data, is veiligheid cruciaal. Het protocol gebruikt OAuth 2.1 en OpenID Connect , met nadruk op “least privilege” en tokenvalidatie. Roelant legde uit dat OAuth 2.1 inmiddels veiliger en consistenter is dan zijn voorganger en dat Microsoft werkt aan Entra Agent ID als mogelijke uitbreiding voor agentic identity management.
“MCP is only as secure as you make it,” zei hij. “Keep it updated, and follow best practices.”
Zelf een MCP-server bouwen
Tot slot liet hij zien hoe eenvoudig het is om een eigen MCP-server te bouwen. In Visual Studio voegde hij via NuGet het ModelContextProtocol-pakket toe. Met slechts zes regels code registreerde hij een HTTP-client naar de PokéAPI — en maakte zo een simpele, werkende MCP-server met een eigen tool.
“Just HTTP,” benadrukte hij. “No magic.”
Key takeaways
MCP maakt AI écht contextbewust.
Het standaardiseert de manier waarop LLM’s tools, data en geheugen gebruiken.
Het is open, uitbreidbaar en al breed geadopteerd.
Beveiliging is geïntegreerd, maar blijft je eigen verantwoordelijkheid.
Context engineering — het bewust ontwerpen van de informatie die je AI krijgt — wordt een nieuw specialisme.
VAR, AI Referees, and the Future of Code Reviews – Amber Vanderburg
Amber opent met een voetbalclip — een bal die nét over de doellijn gaat. De zaal reageert meteen: herkenning, frustratie, discussie. Ze glimlacht: “Outrage in football. What do we do in situations like this?”
Amber is voormalig sportcoach en nu actief in tech leadership. Ze neemt het publiek mee door de geschiedenis van technologie in de sport — en wat we daarvan kunnen leren als softwareontwikkelaars.
In 1731 verscheen de eerste stopwatch. Daarna kwam de elektronische klok, de ‘photo finish’ en automatische scorebepaling bij bowlen. In 1995 deed video-refereeing zijn intrede en in 2001 kwam AI de sport binnen via cricket — het beroemde Hawk-Eye systeem dat met zes tot tien camera’s de balbeweging volgt.
De technologie verbeterde de kijkervaring , maar bracht ook vragen over eerlijkheid en vertrouwen. Tennis volgde in 2006 met real call video assistance. In 2010 zagen we het bekende WK-moment tussen Engeland en Duitsland: een doelpunt dat niet werd toegekend. Twee jaar later voerde de FIFA doeltechnologie in en in 2018 werden videoreferees officieel gebruikt tijdens het WK. Volgens FIFA lag de nauwkeurigheid toen op 99,3%.
In 2022 kwam daar semi-automatische buitenspeltechnologie bij: twaalf camera’s, twintig datapunten per speler. Amber stelt de vraag: “Do we even need human referees anymore?”
Maar: zonder context is er geen vertrouwen. Het publiek accepteert een menselijke fout nog eerder dan een kil technisch besluit van een systeem. Daarna maakt Amber de overstap naar software: de toekomst van code reviews.
Ze laat een reeks beelden zien van gebeurtenissen waar technologie “technisch correct” handelde, maar menselijk gezien faalde — van persoonlijke tragedies tot Dieselgate bij Volkswagen. Een “defeat device” liet auto’s anders presteren tijdens tests, waardoor ze voldeden aan regels, maar de werkelijkheid maskeerden. De les: context en intentie doen ertoe.
Amber benadrukt dat goede code reviews — net als goede arbitrage — niet alleen gaan over correctheid , maar over kritisch denken , empathie en communicatie. Ze zegt: “The questions you ask reveal your values.”
Ze illustreert dit met voorbeelden uit het onderwijs en uit het dagelijks leven.
Wie bij een auto-ongeluk eerst vraagt “hoe erg is de schade?” in plaats van “ben je oké?”, laat zien welke waarde prioriteit krijgt. Hetzelfde geldt bij code reviews: de vragen die we stellen sturen het gedrag van een team.
Amber vertelt over haar ervaring in India, waar ze een voetbalacademie leidde. De spelers waren taakgericht: ze wachtten op instructies en feedback, zonder het grotere spel te zien. Ze leerden een vaardigheid, maar misten context en creativiteit. Na jaren training begreep ze dat haar taak niet was om hen nóg beter te laten uitvoeren, maar om hen te leren denken in systemen — de bigger picture te zien. Tot slot maakt ze de sprong naar AI in coaching en code reviews.
AI kan ons helpen, maar zonder context mist het systeem menselijkheid. Ze toont beelden van vertrouwen en samenwerking en stelt de vraag: “How are you building trust — with your team, your tools, your AI?” Vertrouwen, zegt ze, bestaat uit competence, character en communication. Je kunt iemand vertrouwen met een geheim, maar niet met je auto — omdat vertrouwen domeinspecifiek is.
Goede code reviews, net als goede scheidsrechters, vragen om datzelfde evenwicht tussen correctheid en context. Het is niet genoeg dat iets werkt — het moet kloppen binnen de waarden van het team en de gebruikers.
Amber eindigt met een persoonlijke anekdote: een jonge speler die “pass!” riep, maar niet wist waarom. Pas toen ze samen de bedoeling achter de actie begrepen, ontstond er echt spelinzicht. “Reviewing code,” zegt ze, “isn’t about shouting instructions — it’s about helping others see the field.”
The Next Decade of Software Development – Richard Campbell
Richard Campbell, bekend van DotNetRocks en RunAs Radio (samen goed voor bijna tweeduizend afleveringen), nam het publiek mee op een reis door de tijd — van de begindagen van de cloud tot aan de toekomst van softwareontwikkeling in het komend decennium.
Het einde van Moore’s Law
Richard dook vervolgens de geschiedenis van hardware in: van Fairchild Semiconductor in 1960 tot Intel’s vroege RAM-chips. Moore’s Law — de observatie dat het aantal transistors op een chip ongeveer elke twee jaar verdubbelt — heeft decennialang onze vooruitgang gedragen. Maar, zei hij: “We’re at the end of that curve.” De afstanden tussen transistors worden nu gemeten in nanometers en zelfs picometers. Chips worden 3D en fabrikanten als Intel en TSMC werken aan 2nm-processors. Ondertussen komen ARM-processors op in de cloud, terwijl Apple’s M5-chips met 16 cores en neurale netwerken krachtige lokale AI-taken draaien. Zijn punt: hardwareontwikkeling verandert niet alleen in tempo, maar ook in karakter. De toekomst ligt in specialisatie — quantum, neuromorfisch, edge — in plaats van simpelweg sneller en kleiner.
De evolutie van software
Richard liet een lijst van talen en tools zien die developers de afgelopen decennia hebben gebruikt: Python, Java, C#, JavaScript, Swift, Go, Kotlin, Rust, TypeScript. “None of them are perfect,” zei hij. “They’re just the current answers.” Hij besprak de verschuiving van client naar cloud, van Windows naar Linux en van traditionele apps naar browsers en PWAs. “.NET is 20 years old,” herinnerde hij het publiek, “and .NET 10 is around the corner.” Er volgde een snelle tour door de wereld van low-code tools — Power BI, Power Apps, Power Automate, Power Virtual Agents — en de manier waarop ze traditionele ontwikkelcycli versnellen. Toch, benadrukte hij, blijft de kern hetzelfde: “Good software is still about solving real problems.”
AI: het slechtste goed bedachte woord
Richard noemde “AI” het slechtste marketingwoord ooit. Hij lachte: “If it doesn’t work, we call it AI. Once it works, we rename it.” Hij verwees naar HAL 9000 uit 2001: A Space Odyssey, naar de angst voor machines die ons vervangen — en naar de ironie dat moderne AI vooral ons werk makkelijker maakt. Hij beschreef de opkomst van OpenAI, Google Brain, de ruzies over financiering en de samenwerking tussen Microsoft en OpenAI die leidde tot ChatGPT en GitHub Copilot. Toch waarschuwde hij: “Copilot is your copilot — but if the plane crashes, it’s still your fault.” AI kan code genereren, workflows versnellen en documentatie doorspitten, maar het neemt geen verantwoordelijkheid over.
Technologiehypes en wat blijft
Op het scherm verscheen de Gartner Hype Cycle. Richard vergeleek de huidige AI-golf met de dotcom-bubbel van de jaren negentig. Toen ook kwam er een stortvloed aan investeringen en hoewel veel bedrijven verdwenen, bleef de infrastructuur: de netwerken, servers, browsers en standaarden waarop het internet vandaag nog steeds draait. “Bubbles come and go,” zei hij, “but the foundations remain.” Hij noemde zeven grote bedrijven die nu de wereld van AI en cloud domineren en sprak over de groeiende energiebehoefte van datacenters, de verschuiving van banen en het ontstaan van nieuwe rollen rondom AI-veiligheid, ethiek en auditing.
Verder dan generatieve AI
Richard ging daarna dieper in op generatieve AI buiten tekst en code. Hij noemde AlphaFold 3 — dat eiwitstructuren voorspelt — als voorbeeld van AI die wetenschappelijke vooruitgang versnelt. Hij sprak over batterijen waarvan we nog niet precies begrijpen waarom ze werken, over landbouw waar sensoren en drones bemesting optimaliseren en over de manier waarop machine learning ons helpt zulke complexe systemen te modelleren. Hij benadrukte dat innovatie niet altijd zichtbaar is. “Phones haven’t changed much,” zei hij, “but what happens behind the glass is revolutionary.” Hij noemde Apple Vision Pro en Meta’s nieuwe brillen als stappen in de richting van “see-through computing” — maar gaf toe dat we de echte killer use-case voor kenniswerkers nog moeten vinden.
Quantum en de grenzen van kennis
Tot slot nam Richard het publiek mee naar de wereld van quantum computing. Hij sprak over IBM’s Quantum Eagle, Microsoft’s Majorana-processor en de bizarre omstandigheden waarin deze machines functioneren — gekoeld met helium, zwevend in vacuüm, trillingsvrij tot op atomaire schaal. Hij vergeleek de huidige fase van quantum computing met de begindagen van de transistor. “Back then,” zei hij, “we didn’t even know what digital meant yet. Now we’re staring at the next revolution — and just like then, the unreliable will eventually make the reliable.” Hij eindigde met een optimistische blik:
“We’re in the big time now. We get to make the future.”
Relate. Reflect. Respond. – Alice Meredith
Alice Meredith, met dertig jaar ervaring in leiderschap en verandermanagement, bracht in haar sessie een frisse, menselijke kijk op werk, communicatie en verandering. Haar carrière begon ooit bij Blockbuster Video , daarna werkte ze in HR-leiderschap bij Best Buy en ging daarna trainingen geven bij Pluralsight, waar ze inmiddels meer dan dertig leiderschapscursussen ontwikkelde. Haar missie: mensen helpen de menselijke kant van werk te beheersen — om niet alleen functioneel aanwezig te zijn, maar ook echt verbinding te maken, te reflecteren en bewust te reageren.
“Soft skills aren’t soft,” zei ze. “They’re the hard stuff that makes the hard skills matter.”
De menselijke kant van werk
Om effectiever te zijn in ons werk, moeten we eerst begrijpen hoe we zelf ‘geprogrammeerd’ zijn — ons menselijk besturingssysteem , zoals zij het noemde: een verzameling van levenservaringen, overtuigingen en automatische patronen die we soms zelf hebben gekozen, maar vaak gewoon hebben overgenomen. We draaien allemaal met een eigen set ‘apps’: persoonlijkheidstypologieën zoals DISC, MBTI, Big Five enneagram en Gallup Strengths. Geen enkele is perfect, maar samen geven ze inzicht in onze kern. Volgens Alice bestaat die kern uit vier fundamentele drijfveren:
Macht (Power) – Ze hebben de wens om dingen te laten gebeuren.
Loyaliteit (Loyalty) – Gedreven door loyaliteit, relaties en waarden.
Plezier (Fun) Gedreven door plezier. Hebben veel energie.
Vrede (Peace) – Creëren rust, stabiliteit en veiligheid.
Ze vergeleek onze sterke kanten met een huis met een balkon en een kelder:
“Op het balkon schitteren je kwaliteiten; in de kelder schieten ze door en worden ze je valkuil.”
Het doel is om jezelf in realtime te herkennen en terug naar het balkon te bewegen — naar balans.
Relate: de kracht van echt zien
In het deel Relate vertelde ze een verhaal over een 14-jarige jongen die ze ooit ontmoette aan het strand van Venice Beach. Hij deed stunts op zijn skateboard, terwijl dat daar eigenlijk niet mocht. Toen ze hem aankeek en simpelweg zei: “I see you”, veranderde zijn houding compleet.
“Being seen makes people feel they matter.”
In organisaties werkt het net zo. Mensen willen zich gezien en gehoord voelen. Kleine gebaren kunnen daar groot verschil in maken. Ze gaf een voorbeeld van haar tijd bij Best Buy, waar ze een interne HR-e-mail herschreef die aanvankelijk formeel en afstandelijk was. In twintig seconden maakte ze de boodschap warmer, persoonlijker, menselijker — “You matter” in plaats van “You must.”
Reflect: het bouwen van verbindingen
Alice moedigde leiders aan om “connection bombs” te planten — spontane, menselijke interacties op de werkvloer die relaties versterken. Ze vertelde hoe ze ooit, tijdens een lunchwandeling, een toevallige ontmoeting had over een Journey-concert. Dat leidde tot een halfuur gesprek, nieuwe inzichten en een langdurige samenwerking.
“Every small conversation expands your network and builds trust.”
Verbinding ontstaat niet in vergaderingen of KPI’s, maar in de tussenruimte — de momenten waarin mensen zichzelf mogen zijn.
Respond: omgaan met conflicten en verandering
Het derde onderdeel draaide om responsiviteit — hoe we reageren in situaties van spanning of feedback. Alice haalde het Thomas-Kilmann-conflictmodel aan, met vijf stijlen:
Competing (win-verlies)
Avoiding (verlies-verlies)
Accommodating (verlies-winst)
Compromising (klein win-klein verlies)
Collaborating (win-win)
Ze benadrukte dat conflictstijlen niet statisch zijn: we kunnen leren om flexibel te schakelen, afhankelijk van de context.
Rommelig einde
Zo eindigde de sessie zonder duidelijke conclusie met veel persoonlijke anektotes.
What’s new in C# 13, 14, and beyond – Bart de Smet
Bart de Smet, Principal Software Engineer bij Microsoft en bekend gezichten binnen de .NET-community, nam het publiek mee in een snelle maar diepgaande tour door de nieuwste features van C# 13 , de aankomende verbeteringen in C# 14 en zelfs een voorproefje van wat daarna nog in de pijplijn zit. Zoals altijd deed hij dat met zijn kenmerkende combinatie van precisie, snelheid en diepgang.
Params reimagined
C# 13 breidt de bekende params-functionaliteit eindelijk uit. Waar params sinds de begintijd alleen arrays accepteerde, kunnen ze nu ook werken met andere collection types — denk aan IEnumerable<T>, IList<T>, ImmutableArray<T>, of zelfs custom types die IEnumerable implementeren.
Locking: eenvoudiger en veiliger
Een van de meest zichtbare verbeteringen is de nieuwe lock syntax. In plaats van expliciet te werken met Monitor.Enter en Monitor.Exit, introduceert C# 13 een veiligere, moderne variant
Escape sequences: een kleine maar fijne update
Console-API’s ondersteunen nu de Unicode escape \e (in plaats van het oude \x1B), wat code leesbaarder maakt bij het werken met ANSI-color output of terminal-besturing.
Kleine verbeteringen, groot gemak — “less hexadecimal guessing,” aldus Bart.
Ref en unsafe in iterators
Een meer geavanceerde toevoeging: iterators (yield return) kunnen nu werken met ref en unsafe contexten , zonder onnodige heap-allocaties. Hierdoor worden iterators efficiënter bij performancekritische code, bijvoorbeeld bij Span<T>-operaties. ref struct types blijven wel beperkt tot de stack — ze kunnen dus niet naar de heap of interfaces worden gecast — maar dankzij nieuwe compilerondersteuning kun je ze nu combineren met IDisposable via het allow ref structs-attribuut.
Partial members en de field keyword
C# 13 breidt partial classes verder uit met partial members — niet alleen methodes, maar ook indexers, properties en constructors kunnen nu als partial worden gedefinieerd. De nieuwe field keyword maakt het bovendien eenvoudiger om in properties expliciet naar het backing field te verwijzen: Een elegante oplossing voor wie vaak boilerplate in properties moest schrijven.
Overload resolution attributes
Een subtiele maar belangrijke verandering: C# 13 introduceert een nieuw [OverloadResolutionPriority] attribuut, waarmee library-ontwikkelaars de prioriteit van overloads kunnen sturen — zonder binary-breaking changes. Vooral nuttig bij API’s die ReadOnlySpan<T> ondersteunen.
C# 14 – de volgende stap
Extension members
De grootste verandering die eraan komt, zijn extension members — niet alleen methodes, maar ook properties, indexers en zelfs operators kunnen worden uitgebreid. Dat betekent dat je bijvoorbeeld dit kunt doen:
extension StringExtensions onstring
{
int WordCount => this.Split(' ').Length;
}
De feature wordt nog verder uitgewerkt, maar de potentie is groot — zeker voor domeinspecifieke API’s.
User-defined compound assignment
C# 14 introduceert ook custom compound assignments zoals += of ++ in structs. Zo kun je zelf bepalen hoe samengestelde bewerkingen zich gedragen — een krachtig hulpmiddel voor bijvoorbeeld numerieke types of matrixklassen.
Null-conditional assignment
De welbekende ?. operator krijgt een zusje: de null-conditional assignment. Waar je vroeger alleen kon lezen met ?., kun je nu ook veilig toewijzen:
person?.Address ??= new Address();
Beyond: de horizon van C
Tot slot gaf Bart een vooruitblik op toekomstige concepten — zoals unbound generic names, lambda-parameters met modifiers en verdere uitbreiding van partial members. De focus blijft volgens hem op type safety, performance en expressiviteit — drie pijlers waar C# al twintig jaar om bekendstaat.
“We’re not done evolving,” sloot Bart af. “C# keeps growing with the developers who use it.”
Practical tips for keeping your C# code base clean – Dennis Doomen
Dennis Doomen — bekend van zijn Fluent Assertions-library en zijn expertise in clean architecture — deelde in deze sessie zijn meest beproefde adviezen voor het onderhouden van een gezonde, schaalbare en begrijpelijke C#-codebase. Zijn boodschap was duidelijk: “Clean code isn’t about writing less code — it’s about writing code that everyone wants to work with.”
Keep it simple: fight unnecessary complexity
Hij begon met een observatie over hoe veel teams onnodig complexe architecturen creëren. Niet elke toepassing heeft microservices nodig, benadrukte hij:
“If you don’t need independent scaling, merge those microservices back into a modular monolith.”
Het is volgens hem beter om eerst te kijken waar je daadwerkelijk moet schalen — en pas daarna de architectuur daarop aan te passen. Microservices zijn een middel, geen doel. De Gartner Hype Cycle kwam voorbij: technologieën worden vaak te vroeg geadopteerd. Dennis moedigde aan om pragmatisch te blijven — eenvoud boven hype.
Organiseer de codebase logisch
Een terugkerend thema: structuur. De mapstructuur van je project moet de architectuur weerspiegelen, niet de technologie. Geen “Controllers”-, “Services”- en “Repositories”-mappen, maar verticale slices zoals Orders, Payments, Users.
“The folder structure should explain your architecture at a glance.”
Daarnaast: hou concrete implementaties intern (internal) en exposeer alleen interfaces waar nodig. Door conventie en tooling kun je afdwingen dat interne onderdelen niet per ongeluk publiek worden.
Gebruik tooling om consistent te blijven
Automatisering is essentieel om kwaliteit te bewaken. Dennis liet zien hoe EditorConfig , Prettier en .NET analyzers kunnen helpen bij consistente formatting en statische code-analyse. Ook JetBrains Inspect, SonarQube en Roslyn analyzers noemde hij als hulpmiddelen om vroegtijdig problemen te detecteren.
“Let tools do the boring work so you can focus on design.”
Zelfs AI kan hierbij helpen — hij noemde Copilot en Sonnet als voorbeelden van assistenten die mee kunnen denken bij refactoring, zolang je hun output nog steeds als je eigen code beschouwt.
Document the why, not the how
Veel documentatie schiet tekort omdat ze uitlegt wat de code doet, niet waarom ze zo is opgebouwd. Dennis pleitte voor korte, doelgerichte commentaren die context toevoegen:
“Explain the purpose, not the procedure.”
Gebruik beschrijvende titels en laat de code zelf het werk doen. Tools zoals GhostDoc kunnen helpen bij basisdocumentatie, maar het echte werk zit in de intentie.
Slimme commit- en branchstrategieën
Versiebeheer is volgens hem een onderschat onderdeel van clean code. Kies één bekende branchstrategie — zoals GitHub Flow of GitFlow — en houd je eraan. Belangrijker nog:
Splits refactoring commits van functionele wijzigingen.
Houd PR’s klein en gericht.
Gebruik fix-up commits en interactive rebases om je geschiedenis schoon te houden.
“A clean commit history is a clean story of your code.”
Hij toonde voorbeelden in GitKraken hoe kleine, goed getitelde commits het reviewproces aanzienlijk verbeteren.
Reduce dependencies and coupling
Een schoon systeem is een los systeem. Gebruik Central Package Management om versies te beheren en afhankelijkheden te minimaliseren. Wanneer code herbruikbaar moet zijn, publiceer het als een NuGet-pakket in plaats van losse binaries. Verder:
Vermijd mocks of mocks door interfaces bewust te ontwerpen.
Gebruik adapters om afhankelijkheden te isoleren.
Overweeg een omgekeerde afhankelijkheidsrichting wanneer een module te veel weet van een ander.
“Every dependency is a liability — treat it like one.”
Dupliceer liever dan te vroeg te abstraheren
Een opvallend advies dat vaak tot discussie leidt:
“Duplicate before you abstract.”
Dennis legde uit dat je pas moet abstraheren wanneer je dezelfde code minstens drie keer nodig hebt. Te vroege generieke oplossingen leiden tot onnodige complexiteit en onbegrijpelijke code.
“If it’s too complicated to reuse, maybe it’s not worth reusing.”
Hij verwees naar het principe van de “Rule of Three” en de YAGNI-filosofie (You Ain’t Gonna Need It).
Refactoring and scouting rule
Refactoring hoort een natuurlijke gewoonte te zijn, geen project op zich. Kleine verbeteringen mogen continu gebeuren, mits goed afgescheiden in commits. Dennis sloot af met het “Scouting Rule”-principe:
“Always leave the code cleaner than you found it.”
Samenvattend
De sessie was een praktische gids vol nuchtere adviezen:
Gebruik minder patronen en meer gezond verstand.
Automatiseer consistentie.
Schoon commitgedrag is net zo belangrijk als schone code.
En abstraheer pas als het écht nodig is.
Of zoals Dennis het zelf zei:
“Clean code isn’t a style — it’s a culture. Build it, live it, and your future self will thank you.”
Building the Ultimate Safety Net with Integration Tests — Jimmy Bogard
Het was best druk toen Jimmy Bogard begon aan zijn talk. Z'n presentatie was: demo-heavy, geen theoretisch verhaal. Hij startte met een herkenbaar beeld — een project zonder tests, tot de eerste bug opdook. En dan de pijnlijke realiteit: hoe later je een bug ontdekt, hoe duurder het wordt. Toch blijven veel teams hangen bij unit tests of, erger nog, helemaal geen automatische tests. Bogard haalde de testing pyramid erbij om dat punt te illustreren. Unit tests zijn snel en goedkoop, maar vaak te ver verwijderd van het echte proces. UI-tests zijn daarentegen traag en breekbaar. Integration tests — die het geheel samenbrengen — zijn trager dan unit tests, maar leveren wél de meeste waarde op, juist omdat ze de echte componenten gebruiken. Hij liet een eenvoudig voorbeeld zien met een applicatie die queries uitvoert, business-logica afhandelt en data opslaat. In de praktijk zijn de meeste systemen complexer: veel interacties met de database, mocks die verouderen en test suites die vooral vertrouwen vernietigen in plaats van opbouwen. Zijn boodschap was duidelijk: “Mocks can lie. Integration tests don’t.” Unit tests kunnen je een vals gevoel van veiligheid geven. Ze zijn vaak te sterk gekoppeld aan implementatiedetails, breken bij refactoring en vangen zelden echte regressies. Bogard pleitte ervoor om minder te “mocken” en meer te testen met echte afhankelijkheden — zonder externe tools, tenzij het echt niet anders kan. Daarna kwam de live demo. Hij gebruikte een Microsoft.AspNetCore.Mvc.Testing library en WebApplicationFactory met xUnit. Een simpele HTTP-client maakte in-process calls naar de applicatie, controleerde responses en voerde assertions uit. De test draaide in slechts 282 ms — volledig end-to-end, zonder mocks. De volgende stap: integratie met een echte database. Met FastEndpoints en Testcontainers liet hij zien hoe je PostgreSQL in Docker kunt starten voor elke test, onafhankelijk en schoon. Database-seeding, migraties en configuratie gebeurden automatisch. Door in-memory configuraties te gebruiken in plaats van appsettings.json, bleven de tests licht en flexibel. Hij liet zien hoe belangrijk het is om logs direct in de testoutput te tonen, zodat fouten beter traceerbaar zijn. Daarna ging hij verder met meer geavanceerde scenario’s: authenticatie en externe API-calls. In plaats van auth uit te schakelen, introduceerde hij een TestJWT provider voor gecontroleerde tokens. Voor externe API’s gebruikte hij fakes — eenvoudige singleton-klassen die de complexiteit laag houden maar de logica realistisch nabootsen. Zelfs Razor Pages kwamen voorbij: een test die de HTML-output controleert om te verifiëren dat de juiste data wordt weergegeven. De kern van zijn verhaal bleef overeind: test het systeem zoals het echt draait. Aan het einde sloot hij af met een duidelijke boodschap:
“Stop aiming for the testing diamond — embrace integration tests. They’re slower, yes, but they give you confidence that your system actually works.”
Debugging Like a Coach: Fixing Team Bugs Before They Crash the Game — Amber Vanderburg
Amber Vanderburg opende haar sessie niet met code, maar met mensen. Haar stelling: de moeilijkste bugs in een organisatie zitten niet in de software — ze zitten in de teams. En zoals elke goede coach weet, los je die niet op met een snelle fix, maar met dialoog, reflectie en vertrouwen. Ze gebruikte het beeld van debugging teams like code: analyseren, begrijpen, verbeteren. Haar structuur was eenvoudig maar krachtig: Fix. Improve. New. Niet alles hoeft direct opgelost, maar elk gesprek kan leiden tot verbetering. De kern van haar verhaal kwam voort uit The Five Dysfunctions of a Team van Patrick Lencioni — met vertrouwen als absolute basis. Zonder vertrouwen beweegt niets. Ze gaf een grappig voorbeeld: “If I say I trust Amber to be late, that’s not trust — that’s experience.” Vertrouwen gaat over voorspelbaarheid, openheid en het nakomen van beloften. In internationale of silo-gedreven teams is dat vaak een uitdaging. Eén persoon met vertrouwenissues kan al frictie veroorzaken. Amber liet zien hoe je dat kunt “mappen”: wie vertrouwt wie en waar stokt de samenwerking? Ze verwees naar het boek The Speed of Trust — hoe meer vertrouwen, hoe sneller teams leren en presteren. Daarna introduceerde ze het What–Why–Alternative–Follow-up-model voor gesprekken. Richt je niet op wat iemand fout deed, maar waarom dat gedrag ontstaat, wat het effect is en welke alternatieven beter werken. Cruciaal: plan altijd een follow-up. Zonder consistentie vervliegt verandering. Wanneer iets niet werkt, zei ze, flip the script. Stel andere vragen. Vraag niet: “Waarom ben je niet meer als Henry?”, maar: “Help me begrijpen waarom je deze keuze maakt.” Goede vragen nodigen uit tot reflectie — slechte vragen sluiten de deur. Amber benadrukte ook de fear of conflict — een klassieke valkuil. Teams die conflicten vermijden, verliezen innovatie. Ze benoemde verschillende reacties: ontkennen, klagen, of de schuld bij een ander leggen. Maar echte groei vraagt candor — openheid met empathie. “Speak with courage, but also with care.” Ze liet zien hoe je gesprekken kunt “debuggen”: kijk naar je sociale scripts. Als iemand zegt: “I’m fine,” vraag door. Misschien betekent dat eigenlijk: “I don’t feel supported.” Combineer de persoonlijke behoefte met de praktische noodzaak. Een belangrijk punt ging over de kracht van pauze. “Don’t erase the empathy statement. Wait for it.” Een korte stilte van twee seconden na “I understand you” maakt ruimte voor echtheid. Ze noemde dit de power in pause. In het tweede deel ging ze dieper in op leiderschap. “What would a good developer do? What would a good leader do?” — dat zijn de vragen die teams zichzelf dagelijks moeten stellen. Vermijd generieke vragen; luister om te begrijpen, niet om te antwoorden. Ze sprak ook over process trust: het verschil tussen frustratie en overweldiging. Teams die vier processen gebruiken voor één verandering verliezen vertrouwen. Combineer feiten met gevoelens, want beide sturen gedrag. Tenslotte: flipping the script op teamniveau. Mensen met sterke meningen die niet durven spreken, teams die politiek zijn geworden — je kunt ze helpen door ruimte te maken, bijvoorbeeld via anonieme feedback of timeboxed discussies. Amber sloot af met een persoonlijk inzicht: grote teams werken alleen als mensen zichzelf overstijgen. “The greatest teams are made of people who build something bigger than themselves.”
React: The Most Common State Mistakes in 2025 — Cory House
Cory House begon zijn sessie met een quote van schrijver William Gibson: “The future is already here — it’s just not evenly distributed.” Dat gold volgens hem ook voor React. Terwijl sommige teams al met React 19, Server Components en lokale databases werken, worstelen anderen nog met dezelfde stateproblemen als in 2015. Zijn talk was een reis door tien jaar React-state management — van de eerste componentDidMount() tot de nieuwste server features — met één duidelijke boodschap: de meeste fouten komen niet door de tools, maar door verkeerde keuzes in waar je state beheert.
Van componentDidMount tot React Query
Cory liet zien hoe data fetching in React zich heeft ontwikkeld.
2014: Alles gebeurde in componentDidMount().
2019: Met hooks verplaatsten we logica naar useEffect(), maar daarmee kwamen ook veel nieuwe problemen: over-fetching, dubbele requests en te veel boilerplate.
2020: Custom hooks brachten herbruikbaarheid — useFetch, useUser enz. — maar nog steeds was er veel code nodig.
2021: Enter React Query (nu TanStack Query). Een derde van de projecten gebruikt het inmiddels. Het introduceerde query keys, caching en mutations — allemaal gericht op minder boilerplate en betere performance.
Hij legde het principe stale-while-revalidate uit: data wordt eerst uit cache getoond en daarna ververst — een balans tussen snelheid en actualiteit.
React verandert de regels
Vanaf React 18 en 19 werd de manier waarop we state en data beheren opnieuw uitgevonden:
2022: useErrorBoundary — fouten worden automatisch afgehandeld.
2023: useSuspense voor data fetching — minder handmatige loading– en errorstates nodig.
2024: React Server Components — server-side rendering zonder extra fetch-calls aan de clientkant. Data wordt gestreamd als HTML en libraries als Moment.js blijven op de server.
Cory’s advies: “Try it when you can — it’s not the future, it’s already usable.”
2025 en verder: Local-first apps
De nieuwste trend volgens hem is local-first computing. Met tools als TanStack DB draait je database deels in de browser, in een aparte thread. Daardoor blijft je app bruikbaar bij trage of wegvallende verbindingen. “Every app is a conflict resolution problem,” zei Cory — en lokale databases lossen dat op door synchronisatie en caching slim te combineren.
De 30 manieren om state te beheren
Cory toonde een dia met de titel: “There are 30 ways to handle state in React.” Dat klinkt als een grap, maar het punt was serieus: er zijn véél lagen van state en de meeste fouten ontstaan doordat ze door elkaar worden gehaald. Hij onderscheidde onder andere:
URL state: zoals filters of sortering — deelbaar via link.
Web storage: localStorage, sessionStorage, of IndexedDB.
Local state: enkel binnen een component.
Lifted state: gedeeld tussen componenten via een common parent.
Derived state: berekende waarden, zoals fullName uit firstName + lastName.
Refs: handig voor undo-functionaliteit of imperatieve logica.
Context: voor globale settings zoals taal of dark mode.
Remote state: data van een server, vaak met React Query of SWR.
Zijn advies: “Pick the lowest level that works. Don’t lift state unless you have to.”
Veelgemaakte fouten
Een paar veelvoorkomende problemen die hij noemde:
Prop drilling: data die te diep doorgegeven wordt.
Derived state in useState: dubbele bronnen van waarheid.
Niet valideren van API-data: gebruik tools als Zod voor runtime-validatie.
Overmatig global state management: niet alles hoort in Redux, Context of Zustand.
React 19 en de toekomst
Tot slot gaf Cory een vooruitblik op React 19 en wat hij “the good enough mindset” noemde: gebruik de nieuwste tools waar ze waarde toevoegen, maar vermijd shiny-object-syndroom. React 19 introduceert o.a. Action State voor formulieren — een manier om pending states, optimistic UI’s en fouten af te handelen zonder extra libraries. Zijn voorbeeld: bij het verzenden van een formulier kun je direct een optimistic update tonen — alsof de actie geslaagd is — en pas terugrollen als er een fout optreedt. “Great UX assumes success, but gracefully handles failure.”
Conclusie
Cory sloot af met de boodschap dat state management in React minder gaat om syntax en meer om mentaal model. Begrijp wáár je state hoort, hoe je het deelt en hoe je het valideert — dan maakt het niet uit of je Redux, React Query of een simpele hook gebruikt. Of zoals hij het samenvatte:
“Managing state is like managing people — if you keep it local when you can, everything runs smoother.”
Fortifying your Workflows: Battle-Tested Security Strategies for Hardening GitHub Actions – Josh Johanning
Josh opende met een simpele maar ontnuchterende constatering: CI/CD workflows zijn nu een van de favoriete aanvalsvectors van kwaadwillenden — en GitHub Actions staat middenin het strijdtoneel. Zijn sessie was praktisch, direct en zat vol voorbeelden uit echte incidenten en best practices die je morgen kunt invoeren.
Waarom GitHub Actions hardenen / versterken?
Met meer dan 29.000 open-source Actions in de marketplace en workflows die arbitrary code uitvoeren, ontstaan er veel risico’s: onbedoelde privilege-escalatie, gelekte secrets, of build-servers die als springplank gebruikt worden voor grotere aanvallen. Josh verwees naar bekende supply-chain incidents, waaronder:
tj-actions/changed-files (2025) – gehackte Action via malicious commit en re-tagging, die secrets stal via pull_request_target.
Nx “s1ngularity” Attack (2025) – npm-token lek leidde tot besmette packages die crypto-wallets stalen.
Shai-Hulud Worm (2025) – zelfreplicerend npm-worm die GitHub en npm tokens misbruikte.
SolarWinds (2020) – buildserver-compromis met gesigneerde malware.
De zwakste schakel is niet je code, maar je supply chain. Vertrouwen en automatisering verhogen risico’s — en met AI-promptinjection komen daar nieuwe dreigingen bij.
Begin met minimale rechten: permissions & tokens
Vanaf februari 2023 heeft GitHub de default repository-permissies verlaagd naar read-only voor nieuwe orgs en enterprises, maar oudere repos behouden nog steeds read/write! Josh benadrukte dat je permissies per job moet specificeren, niet op workflow-niveau, zodat alleen noodzakelijke stappen schrijfrechten krijgen.
Secrets en authenticatie
Er zijn drie strategieën:
GitHub secrets store – makkelijk, maar minder schaalbaar.
Extern (Azure Key Vault / HashiCorp Vault) – veiliger en beter auditbaar via OIDC (OpenID Connect).
Hybride aanpak – centrale Vault als bron, met geautomatiseerde sync naar repo-secrets.
Belangrijke tips:
Gebruik geen gestructureerde data (zoals JSON) als secret.
Mask dynamisch aangemaakte secrets in logs.
Automatiseer rotatie en gebruik least-privilege credentials.
OIDC in plaats van long-lived tokens
Met OIDC kan je cloudtoegang regelen zonder tokens op te slaan of te roteren — authenticatie wordt door het externe platform afgehandeld. Josh demonstreerde dit met Azure AD federated credentials en liet zien hoe je zelfs kunt afdwingen dat alleen goedgekeurde reusable workflows toegang krijgen tot productieomgevingen. Ook npm schakelt over: klassieke long-lived tokens zijn uitgefaseerd, standaard expiratietijd is teruggebracht naar 7 dagen. Gebruik OIDC + 2FA voor npm-publicaties om supply-chain risico’s te verkleinen.
Bouwketen integriteit: tags, SHAs en signing
GitHub Actions worden meestal gepubliceerd via Git-tags — en tags zijn mutable. Daardoor kon de tj-actions/changed-files hack duizenden repositories treffen. Josh benadrukte:
Pin altijd op commit SHA.
Gebruik dependabot.yml om automatisch updates te blijven ontvangen.
Sinds augustus 2025 kun je zelfs SHA-pinning afdwingen als enterprise policy.
Immutable releases
In private preview (aug 2025) introduceerde GitHub Immutable Releases, waarmee assets, tags en attestaties cryptografisch worden vastgezet.
Immutable assets kunnen niet meer aangepast of verwijderd worden.
Tags zijn beschermd tegen force pushes.
Releases worden automatisch ondertekend (attestation signing).
Josh toonde live dat force pushing of tag deletion wordt geblokkeerd zodra immutable releases aanstaan.
Script injection & OSS-beveiliging
Net als bij SQL-injectie geldt: gebruikersinput is onbetrouwbaar. Issue-titels, branch-namen of comments kunnen misbruikt worden in inline scripts. Mitigaties:
Gebruik Actions met input-parameters in plaats van inline run: scripts.
Zet userinput eerst in environment-variabelen (env:).
Beperk token-permissies strikt.
Algemene aanbevelingen
Gebruik CODEOWNERS of rulesets voor workflowwijzigingen.
Zet OpenSSF Scorecard Action in om supply-chain hygiene te meten.
Vermijd pull_request_target — vooral in publieke repos.
Stel een allow-list in van goedgekeurde Actions (liefst “as code” met automatische validatie).
Gebruik aparte workflows voor PR-validatie versus productie-CD.
Josh liet zien hoe CodeQL + Copilot Autofix kwetsbaarheden automatisch detecteren én suggesties geven, zoals:
Ontbrekende permissions-blokken.
Ongepinde tags.
Kwetsbare versies van Actions.
Script injection via gebruikersinput.
CodeQL is gratis voor openbare repos en je kunt security findings organiseren via security campaigns — waarbij Copilot Autofix automatisch patches voorstelt. Dependabot Security Alerts is ook gratis en detecteert kwetsbare Actions via de GitHub Advisory Database.
Attestations: bewijs van herkomst
Attestations zijn het moderne alternatief voor traditionele code signing. Ze registreren cryptografisch waar en door wie een artefact is gebouwd en worden automatisch vastgelegd in GitHub Actions via OIDC-signing. Zo kan downstream-softwareverificatie plaatsvinden zonder extra tooling.
Beheer zelf-gehoste runners verstandig
Josh benadrukte opnieuw het SolarWinds-voorbeeld: treat build servers as production. Gebruik GitHub-hosted runners als veilige default — die zijn:
Ephemeral (nieuw image per job)
Network-isolated
Volledig vernietigd na afloop van de job
Voor self-hosted runners:
Gebruik Actions Runner Controller (ARC) of Terraform-templates om ephemeral gedrag na te bootsen.
Scheid build- en release-runners.
Geef nooit productie-netwerktoegang.
Disable repo-level runners om exfiltratie te voorkomen.
Cache enkel tools, geen gevoelige data.
Praktische checklist
Zet default repository permissions op minimaal (read-only).
Pin alle 3rd-party Actions op commit SHA.
Gebruik OIDC in plaats van long-lived secrets.
Forceer commit signing en gebruik immutable releases.
Josh sloot af met een realistische maar optimistische boodschap:
“De dreiging is reëel, maar de meeste mitigaties zijn laagdrempelig. Met een paar aanpassingen aan permissies, secrets en scans kun je je CI/CD-pijplijn aanzienlijk weerbaarder maken.”
Trusted. Respected. Heard. – Alice Meredith
Alice begon haar sessie met een glimlach en een waarschuwing: “Invloed begint niet bij je functietitel, maar bij je gedrag.” Ze maakt Pluralsight traningen en reist de wereld rond met haar Human Firewall Tour — waarin ze mensen leert om sterk, eerlijk en empathisch te communiceren binnen organisaties.
De essentie: invloed is gedrag, niet positie
Alice stelde een simpele vraag:
“Wie heeft hier invloed?” Iedereen keek naar de leidinggevenden — maar volgens haar hebben ook juniors, stagiairs en specialisten invloed. Niet omdat ze macht hebben, maar omdat ze vertrouwen, respect en geloofwaardigheid opbouwen door hun gedrag.
Ze gebruikte het model A-B-C+:
Authority – formele macht,
Behaviour – hoe je handelt,
Consequences – de resultaten die je gedrag oplevert,
Invloed is dus geen status, maar een reeks keuzes die je dagelijks maakt.
Word een persoon van eer (honor)
Echte invloed begint bij integriteit.
“Eén oneervolle actie kan jaren van vertrouwen vernietigen.”
Alice deelde haar persoonlijke “Honor Code” — vijf gedragingen die het fundament vormen voor geloofwaardigheid:
Speak the truth , zelfs als het ongemakkelijk is.
Act with follow-through – laat je daden overeenkomen met je woorden.
Avoid gossip , want roddel ondermijnt vertrouwen.
Give credit , want het verheffen van anderen vergroot je eigen invloed.
Stand firm , blijf trouw aan je waarden, ook onder druk.
Ze vertelde over teams die uit elkaar vielen door kleine, herhaalde overtredingen van deze ongeschreven regels — en over hoe herstel begint bij eerlijkheid.
Bouw diep vertrouwen – ga van “shallow” naar “deep water”
De meeste werkrelaties blijven aan de oppervlakte: vriendelijk, maar oppervlakkig.
“Shallow water feels safe. Deep water feels risky. But that’s where real connection lives.”
Echte invloed vraagt om kwetsbaarheid. Alice moedigde het publiek aan om de eerste stap te zetten: – deel je fouten, – vraag actief naar ervaringen van anderen, – en wees nieuwsgierig in plaats van oordeelend. Ze gebruikte de metafoor van het private pool vs open ocean:
In je private pool voel je je comfortabel met bekenden.
In de open oceaan ontmoet je nieuwe mensen, ideeën, perspectieven — daar groeit invloed.
Tijdens rondetafels en meetings, zei ze, moeten we bewust “deep water” betreden: anderen uitnodigen die anders denken, niet alleen wie we al vertrouwen.
Emotionele intelligentie is belangrijker dan cv’s
Alice verwees naar onderzoek bij CEO’s: bij sollicitaties draait het zelden om technische skills, maar om emotionele intelligentie. Wie zichzelf én anderen begrijpt, beïnvloedt effectiever. Ze onderscheidde:
Private awareness – weten wat er in jou omgaat.
Public awareness – bewust zijn van wat anderen zien en voelen.
Wanneer die twee in balans zijn, word je betrouwbaar én menselijk. Een voorbeeld: iemand die na een stressvol gesprek zegt “Geef me even tijd om te ontladen” toont bewustzijn — en voorkomt dat emoties onbedoeld richting anderen overslaan.
Inclusie als moreel kompas
“Be the one.” De ene persoon die groet in de lift. Die zegt: “Hé Tom, ik heb je al een tijdje niet gehoord.” Die een stil persoon uitnodigt om iets te delen.
In een drukke corporate wereld waarin mensen vaak “te druk” zijn voor echte verbinding, is bewust inclusief gedrag revolutionair. Alice noemde inclusie “the reset button for humanity”. Ze moedigde aan om actief uit je bubbel te stappen: praat met mensen die anders denken, andere rollen of achtergronden hebben.
Feedback en herframing
Het laatste stuk ging het over feedbackcultuur. Negatieve feedback roept vaak defensie op — maar door reframing kun je dezelfde boodschap constructiever brengen. In plaats van: “Je luistert nooit”, zeg:
“Ik merk dat ik moeite heb om mijn punt te maken. Kunnen we even stilstaan bij hoe we dit gesprek voeren?”
Ze noemde dit “Flipping the script” — de vaardigheid om feedback te geven met empathie, waardoor de ander open blijft.
Kernboodschap
Echte invloed begint niet bij positie , maar bij eer, vertrouwen, authenticiteit en inclusie.
“You don’t need a title to lead. You just need the courage to be trusted, respected, and heard.”
Lessons from the Fast Lane – Robert Doornbos
De closing keynote van de conferentie werd gegeven door niemand minder dan Robert Doornbos , oud-Formule 1-coureur en tegenwoordig analist en ondernemer. Zijn verhaal was niet zomaar een verzameling anekdotes uit de racewereld — het was een kijkje achter de schermen van een hypercompetitieve sport waarin samenwerking, data en innovatie het verschil maken tussen winnen en uitvallen.
F1 is de ultieme teamsport
Hoewel veel mensen Formule 1 zien als een individuele sport, benadrukte Doornbos dat een F1-team draait op teamwork. Een modern Red Bull-team bestaat uit ruim 600 mensen , waarvan 120 meereizen naar de 24 races per jaar — verspreid over de hele wereld, goed voor meer dan 1500 reiskilometers per seizoen.
“Een coureur staat op het podium, maar zonder het team is hij nergens.”
Van de monteurs tot de data-analisten, iedereen werkt synchroon samen om één doel te bereiken: de snelste zijn. Elke fractie van een seconde telt.
Innovatie en data: het hart van de snelheid
Formule 1 is net zo goed technologie als sport. Elke auto is uitgerust met meer dan 300 sensoren die continu data verzamelen: temperatuur, bandenslijtage, brandstofverbruik, aerodynamica enzovoort. Die data stroomt naar gigantische IT-hubs op het circuit én naar het hoofdkwartier van het team. De communicatie moet realtime zijn, want elke vertraging in dataverkeer kan miljoenen kosten.
“Het is een partnerschap van data. Zonder meten geen winnen.”
Simulaties en windtunnels
Hij vertelde hoe belangrijk simulaties tegenwoordig zijn in F1. Coureurs rijden duizenden virtuele kilometers per week in een simulator van 12 miljoen euro — maar, voegde hij met een glimlach toe, “je kunt het gevoel van G-krachten nooit simuleren.” Ook windtunnels spelen nog steeds een sleutelrol. Al sinds de jaren dertig wordt aerodynamica getest in windtunnels — eerst voor vliegtuigen, later voor racewagens.
“Waar vliegtuigen lift creëren, creëren wij downforce — genoeg om een auto ondersteboven tegen het plafond te laten rijden.”
De kunst van de pitstop
Doornbos noemde de pitstop het perfecte voorbeeld van menselijke efficiëntie onder extreme druk. Een compleet bandenwissel — door een team van twintig mensen — gebeurt in gemiddeld 1,8 seconden.
“Dat is pure choreografie. Elk teamlid weet exact wat zijn taak is, geen twijfel, geen ego, alleen perfectie.”
Hij gebruikte het als metafoor voor organisaties:
“In een goed team weet iedereen zijn rol en vertrouwt men elkaar blind. Dat is hoe je onder druk presteert.”
De toekomst: elektrificatie en veiligheid
Formule 1 is constant in beweging. Waar vroeger de V10- en V8-motoren domineerden, zijn moderne wagens hybride power units: een samenspel van verbrandingsmotor en elektrische systemen. Ook veiligheid is enorm verbeterd — dankzij jarenlange innovaties die later hun weg vinden naar gewone wegauto’s.
“Alles wat we in F1 leren over veiligheid, vindt uiteindelijk z’n weg naar de straat.”
Lessen uit de racebaan
Doornbos sloot af met een krachtige boodschap die net zo goed geldt voor technologie, business en persoonlijke groei:
“Als alles onder controle lijkt, ga je niet snel genoeg.”
Hij bedoelde daarmee dat echte vooruitgang ontstaat aan de rand van comfort — waar risico, lef en teamwork samenkomen. Fouten horen erbij, maar zonder ambitie, experiment en durf komt niemand op pole position.
Takeaways uit de Fast Lane
Data is pas waardevol als je er actie op onderneemt.
Snelheid komt van vertrouwen, niet van chaos.
Simuleren is goed, maar echte ervaring blijft onmisbaar.
Perfectie is teamwork – niet ego.
Durf gas te geven, ook als je het nog niet volledig onder controle hebt.
Conclusie — Techorama 2025
Techorama 2025 bewees opnieuw waarom het een van de meest toonaangevende techconferenties van de Benelux is. Drie dagen lang stond innovatie centraal: van diepgaande sessies over AI-integratie en cloud-native architecturen tot inspirerende keynotes over leiderschap, creativiteit en de toekomst van softwareontwikkeling.
Wat vooral opviel, was de balans tussen technologie en menselijkheid. Sprekers benadrukten niet alleen de kracht van nieuwe tools en frameworks, maar ook het belang van samenwerking, ethiek en een gezonde techcultuur. De rode draad? Technologie ontwikkelt zich razendsnel, maar de kern blijft: mensen die met passie bouwen, leren en delen.
Of je nu kwam voor de nieuwste inzichten in .NET, DevOps, data, of design systems — Techorama 2025 bood iets voor iedereen. En terwijl we naar huis gingen met volle notitieboeken en nog vollere hoofden, bleef één gedachte hangen: de toekomst van technologie is niet iets dat ons overkomt, maar iets wat we samen vormgeven.
Tot volgend jaar — waar we elkaar opnieuw uitdagen, inspireren en verbinden.
Op 8 oktober 2025 bezocht ik de Frontmania in Utrecht: een dag vol inspiratie, kennisdeling en technische diepgang. Deze blogpost is geschreven voor een technisch publiek, maar iedereen is welkom om het te lezen. Frontmania 2025 stond opnieuw in het teken van alles wat het front-end landschap beweegt. Van innovatieve frameworks tot diepgaande inzichten in performance, debugging en schaalbaarheid — de conferentie bracht een diverse groep developers samen die hun passie voor moderne webtechnologie delen. De dag zat vol energie: sprekers van onder andere Google, Delivery Hero en RTL deelden hun kennis over de nieuwste tools, architecturen en best practices. Hoewel sommige talks bol stonden van de technische details en anderen juist meer op inspiratie mikten, was de rode draad duidelijk: de front-endwereld evolueert snel richting meer automatisering, slimme observability en robuuste user experiences. Frontmania 2025 liet zien dat front-end development niet langer alleen over interfaces gaat, maar over het bouwen van betrouwbare, schaalbare en slimme digitale ervaringen.
Why Reactive Functional Is My Paradigm of Choice – Bart Kuijper
De eerste talk van de dag zette meteen de toon. De spreker nam ons mee in zijn persoonlijke reis door de wereld van Reactive Functional Programming (RFP) — een paradigm dat volgens hem te vaak als academisch wordt weggezet, maar juist verrassend natuurlijk aanvoelt als je er eenmaal in duikt. Zijn missie was duidelijk: laten zien waarom RFP niet alleen een technische aanpak is, maar een manier van denken die dichter bij de natuur ligt dan we ons beseffen.
Hij begon met een intrigerende vraag: waarom is RFP zo populair in het onderwijs, maar wordt nog steeds niet breed omarmd in de praktijk? Vervolgens bouwde hij zijn verhaal op aan de hand van metaforen, die zowel filosofisch als praktisch vlaktes raakten. Een observable vergeleek hij met een waterstroom: een bron die continu nieuwe waarden uitzendt, waarop andere delen van het systeem kunnen reageren. Zoals rivieren samenvloeien, zo kunnen streams in RxJS met functies – als merge, expand en scan – samenkomen en nieuwe patronen vormen.
Wat me vooral bijbleef, was de manier waarop hij de concepten van push-based en pull-based systemen koppelde aan natuurlijke processen. In de natuur ontstaat informatie niet doordat we erom vragen — ze wordt uitgezonden, gedeeld, verspreid. Zoals een boom reageert op licht, past een ecosysteem zich aan de veranderingen in temperatuur. Het is allemaal een reactive proces.
Zijn voorbeelden waren even poëtisch als technisch. Van een amandelboom die blikseminslag overleeft terwijl zijn omgeving afbrandt, tot genetische veranderingen bij kuikens — telkens keerde hij terug naar hetzelfde idee: systemen die reageren, evolueren en zich aanpassen zijn sterker. En precies dat probeert een RFP te vangen in code.
Hij liet met de front-end libary genaamd RxJS zien hoe we deze natuurlijke dynamiek kunnen modelleren in software. Data als een keten van gebeurtenissen, waarin alles met elkaar verbonden is. Het voelde bijna alsof hij een brug sloeg tussen mechanische en natuurlijke engineering: niet langer rigide objecten (zoals in OOP), maar stromen die bewegen, veranderen en samen nieuwe vormen aannemen.
De talk eindigde met een krachtige boodschap: RFP is niet alleen efficiënter of eleganter — het voelt gewoon goed. Natuurlijk, vloeiend en in lijn met hoe de wereld zelf werkt. En misschien is dat wel de reden waarom het tijd is om ons reactive functional-spel écht op te pakken.
The Web Components Compass – Tom Herni
Web Components blijven een van de meest polariserende onderwerpen in front-end development. Sommige ontwikkelaars prijzen ze als de toekomst van framework-onafhankelijke UI’s, terwijl anderen ze zien als omslachtig en beperkt. Tijdens zijn talk “The Web Components Compass” nam Tom Herni van Rabobank ons mee in een nuchtere en praktische verkenning van deze technologie: wat web components precies zijn, wanneer ze werken en wanneer je ze beter kunt vermijden.
Hij begon met een herkenbare constatering: de webplatformen blijven evolueren. Nieuwe features – zoals lazy loading, de Intersection Observer API en het steeds breder wordende scala aan Web API’s – tonen hoe de browser zelf een steeds volwaardiger applicatieplatform wordt. In dat licht passen Web Components perfect — ze zijn immers gebaseerd op open standaarden en draaien rechtstreeks in de browser, zonder afhankelijkheid van frameworks als React of Angular.
Tom structureerde zijn talk rond drie pijlers: Custom Elements, Shadow DOM en HTML Templates.
Custom Elements
Met Custom Elements kun je je eigen HTML-tags definiëren compleet met eigen gedrag en lifecycle-methoden zoals connectedCallback() en disconnectedCallback(). In plaats van een <div> of <button> kun je dus iets als <my-button> maken, met interne logica en styling die je zelf beheert. Dat klinkt klein, maar het is precies wat nodig is voor het bouwen van een duurzaam design system. Rabobank gebruikt dit principe voor componenten zoals datepickers, knoppen en invoervelden — allemaal met unieke prefixen om naamconflicten te voorkomen.
Shadow DOM
Vervolgens dook hij in het Shadow DOM, het onderdeel dat zorgt voor echte encapsulatie van markup en styles. Het creëert een eigen DOM-subtree binnen een component, waardoor CSS en scripts niet onbedoeld naar buiten lekken (of van buitenaf worden beïnvloed). Die isolatie is krachtig, maar brengt ook uitdagingen met zich mee. Bepaalde CSS-properties — zoals font-families en variabelen — worden wél geërfd, maar selectors kunnen niets “zien” binnen het Shadow DOM. Daardoor moet je soms creatief omgaan met styling en communicatie tussen componenten.
Toegankelijkheid en forms zijn een ander pijnpunt. Inputs binnen een Shadow DOM gedragen zich niet automatisch als standaard form controls, waardoor integratie met formulieren of ARIA-attributen extra aandacht vraagt. Rabobank gebruikt hier form-associated custom elements voor een nog relatief nieuwe, maar veelbelovende oplossing.
HTML Templates
Het derde onderdeel waren HTML templates: <template>-elementen die vooraf gedefinieerde markup bevatten en met JavaScript kunnen worden gekloond. Samen met Shadow DOM vormt dit de basis voor het bouwen van herbruikbare UI’s zonder externe libraries.
Praktijk: Rabobank’s Design System
Tom deelde hoe Rabobank inmiddels meer dan 150 UI-componenten onderhoudt, gebouwd als Web Components. Omdat het bedrijf teams heeft die werken met Angular, React en zelfs Svelte, zijn Web Components daar een ideale verbindende laag. De interoperabiliteit tussen frameworks maakt het mogelijk om één gedeeld design system te onderhouden, terwijl elke afdeling zijn eigen frontend-stack kan kiezen. Dat betekent niet dat alles vlekkeloos verloopt. Auto-completion in editors, tag-herkenning in Angular en wrapper-componenten blijven bronnen van frictie. Toch wegen de voordelen van herbruikbaarheid en onafhankelijkheid zwaar genoeg.
Conclusie
Tom’s conclusie was realistisch: Web Components zijn niet voor elk project de heilige graal. Ze vragen om zorgvuldige afweging, vooral bij complexe styling of form-integratie. Maar voor organisaties met meerdere frameworks en een gedeelde design language — zoals Rabobank — kunnen ze een enorme meerwaarde bieden. Of zoals Tom het samenvatte: “If interoperability matters more than convenience then Web Components are worth the effort.”
Pixels, Tokens and Prompts: The Evolution of Design Systems – Dražen Janković
Met zijn talk “Pixels, Tokens and Prompts” nam Dražen Janković ons mee op een reis door de geschiedenis van design systems, van de eerste papieren styleguides tot de opkomst van AI-gestuurde ontwerptalen. Het was niet alleen een technisch overzicht, maar ook een reflectie op hoe ontwerp, ontwikkeling en intelligentie steeds meer met elkaar versmelten.
Van Styleguides tot Living Systems
Janković begon bij de oorsprong: de eerste styleguide van IBM in de jaren ’60. Strikte visuele standaarden die zorgden voor consistentie in drukwerk en marketing, maar nog niets van doen hadden met digitale interfaces. In 1978 volgde Apple met zijn Human Interface Guidelines — de eerste poging om niet alleen de look, maar ook het gedrag van interfaces vast te leggen.
Vanaf daar ging het snel: de opkomst van HTML in 1991, CSS in 1994 en JavaScript-frameworks vanaf 2006 brachten steeds meer dynamiek. Yahoo’s Design Pattern Library (2006) en Twitter’s Bootstrap (2011) legden de basis voor moderne design systems. In 2014 zette Google’s Material Design daar een laag bovenop: een levend systeem dat gedrag, animatie en betekenis combineerde. Salesforce kwam in dezelfde tijd met het Lightning Design System.
Shelves, Guides, and Systems
Op een van zijn slides liet Janković een helder overzicht zien van deze evolutie — van Component Shelves naar Styleguides en uiteindelijk Design Systems. Elke stap voegt meer context, tooling en samenwerking toe:
Component Shelf: hergebruik van UI-elementen, vaak puur in code. Styleguide: zorgt voor visuele consistentie, maar blijft statisch. Design System: brengt tokens, componenten, documentatie en tooling samen — een continu evoluerend ecosysteem dat gedrag, toegankelijkheid en gebruik omvat.
Zijn metafoor was treffend: elk niveau voegt meer duidelijkheid, consistentie en schaalbaarheid toe — als een doos LEGO die zich blijft uitbreiden.
The Rise of Tokens
Daarna doken we dieper in design tokens. Dit zijn herbruikbare en benoemde variabelen die visuele waarden vastleggen, zoals: kleuren, typografie, spacing, animatie en de motion of elevation. Tokens maken ontwerp schaalbaar en consistent over platformen heen. Janković liet zien hoe design tools, zoals Figma deze tokens nu kunnen exporteren als JSON, waardoor ze direct bruikbaar zijn in code of zelfs als input voor AI-systemen. Waar ontwerpers vroeger handmatig waarden moesten bijhouden, vormen tokens nu een single source of truth die ontwerp en ontwikkeling verbindt.
Governance in a System World
Met groei komt ook structuur. Een goed design system heeft governance nodig: versiebeheer, documentatie, tooling en analytics. In een enterprise-achtige schaal vraagt dit om data-gedreven onderhoud — een levend ecosysteem dat zichzelf bijwerkt en leert van gebruik.
Prompts and AI: The New Interface Layer
Het laatste deel van zijn talk richtte zich op de toekomst: prompts als nieuwe interface-laag. Waar tokens de woorden vormen en componenten de grammatica, maken prompts volledige zinnen mogelijk. AI-modellen kunnen leren “design systems te spreken”, mits ze goed getraind worden. Janković noemde dit een bilingual conversation tussen mens en machine:
Pixels zijn de visuele atomen.
Tokens vormen de woordenschat.
Components bepalen de syntaxis.
Prompts worden de volzinnen waarmee we communiceren met AI-designers of copilots.
AI vervangt de mens niet, benadrukte hij, maar kan wél fungeren als een nieuwe collega — een junior die je traint met documentatie, voorbeelden en goed beschreven componenten. Quote: “Train your design system en je traint je AI-teamgenoot tegelijk.”
Van LEGO naar Leven
De talk eindigde met een blik op de toekomst: design systems die niet alleen reageren op tokens, maar ook leren van gebruik: een ecosysteem waarin designers, developers, AI-agents en tools in één taal samenwerken.
It’s the End of the Front as We Know It (I Feel Fine) – Nir Kaufman
Nir Kaufman begon zijn talk met een prikkelende vraag: wat betekent de titel “front-end developer” anno 2025 nog? Volgens hem staat die term op het punt zijn betekenis te verliezen. Niet omdat gebruikersinterfaces verdwijnen, maar omdat de grens tussen client, server en AI steeds meer vervaagt. De rol van de front-ender verschuift van het schrijven van UI-code naar het begrijpen van architectuur, gedrag en samenwerking met slimme tools.
Hij verdeelde die evolutie in drie bedrijven.
In Act I, de server-era van 1996 tot 2015, draaide alles om pagina’s die volledig door de server werden gegenereerd. Denk aan PHP of HTML die rechtstreeks uit templates kwam. Daarna kwam de Flash-periode, waarin interfaces vooral bestonden uit pixels in plaats van DOM-elementen. Vervolgens de Ajax-tijd: dynamische data “sprinkles” die websites wat interactiviteit gaven. De jaren 2010 brachten de SPA’s, single-page apps waarin de client de koning was: één keer laden en daarna alles lokaal afhandelen.
In Act II kwam de ommekeer. Met de opkomst van APIs, server-side rendering en React Server Components keerden veel verantwoordelijkheden terug naar de server. Ontwikkelaars begonnen na te denken over de balans tussen client en server, performance en streaming. Kaufman vatte het mooi samen: “We optimized where to render for a decade. Now we optimize what to render.” Niet langer de locatie van de render is de belangrijkste keuze, maar de vraag welke content en componenten überhaupt getoond moeten worden en wie dat bepaalt.
Act III bracht de grote plotwending: AI. Tools kunnen vandaag complete interfaces genereren vanuit Figma-bestanden, kleurpaletten aanpassen op commando of componenten toevoegen via een gesprek in natuurlijke taal. Kaufman liet een live demo zien waarin een chatinterface een kleurpicker genereerde en direct geïntegreerd in een bestaande UI. De grens tussen mens – machine en design – implementatie is dunner dan ooit.
Toch waarschuwde hij voor een verkeerde conclusie. Het is niet het einde van de front-end of van grafische interfaces. Mensen blijven nodig voor micro-interacties, toegankelijkheid en gevoel voor context. De kern van het vak verandert: front-end is niet langer een aparte specialisatie, maar een deel van volwaardige software-engineering. Wie de fundamenten van webarchitectuur begrijpt, — netwerk, performance, beveiliging, state management — zal zich blijven onderscheiden.
Kaufman eindigde met een optimistische noot: “Dit is niet het einde van front-end development, maar een nieuw begin”. De toekomst is aan ontwikkelaars die verder kijken dan frameworks, die design systems begrijpen en weten hoe AI hun werk kan versnellen zonder hun rol over te nemen. Wie zich aanpast aan die bredere manier van denken, staat sterker dan ooit.
The Real Cost of React Re-renders in 2025 – Emīls Pļavenieks
Emīls Pļavenieks, een ontwikkelaar uit Letland met een passie voor performance en side-projects, gaf een scherpe en diepgaande talk over iets wat veel React-ontwikkelaars kennen, maar zelden écht begrijpt: re-renders. Zijn sessie “The real cost of React re-renders in 2025” liet zien hoe moderne React-apps vaak performant lijken, maar onder de oppervlakte vol verborgen vertragingen zitten — van subtiele CPU-belastingen tot hydration mismatches die pas opvallen wanneer je app draait op tragere devices of instabiele netwerken.
Pļavenieks begon met de basis: waarom rendert React eigenlijk opnieuw? Elke verandering in state, context of props kan een her-render veroorzaken, maar lang niet altijd om de juiste redenen. Vooral complexe hooks, contextgebruik en foutief gememoiseerde functies zorgen ervoor dat componenten vaker renderen dan nodig. “Most re-renders are cheap,” benadrukte hij, “but some are very expensive — especially when they trigger heavy computation or block the main thread.”
Hij nam het publiek stap voor stap mee door het proces dat elke React-component doorloopt. Eerst is er de render phase, waarin React de virtuele DOM opbouwt. Daarna volgt de commit phase, waarin de daadwerkelijke wijzigingen worden toegepast op de browser-DOM. Pas daar vinden de echte en kostbare operaties plaats: layout thrashing, appendChild-acties en herberekeningen van de UI. In veel projecten ligt hier het ongemerkte performanceprobleem.
Tijdens zijn live demo liet Pļavenieks zien hoe je zulke bottlenecks kunt blootleggen met moderne tooling. In Chrome’s Performance-tab en de React DevTools Profiler toonde hij flamegraphs van een component dat bij het scrollen of typen meerdere keren onnodig opnieuw renderde. Door de CPU te throttlen werd duidelijk zichtbaar hoeveel tijd elke render kostte — soms vier keer meer dan verwacht. Zijn boodschap was helder: optimaliseer eerst de renders zelf, voordat je probeert re-renders te voorkomen.
Daarna verdiepte hij zich in wat React de afgelopen jaren veranderd heeft. React 18 introduceerde concurrent rendering, waarbij React z’n “fibers” kan pauzeren en prioriteit kan geven aan belangrijkere taken. Dat maakt de interface vloeiender, maar kan ook nieuwe valkuilen opleveren als transitions verkeerd worden gebruikt. In React 19, dat hij beschreef als “compiler-backed React”, komt daar nog een revolutionaire stap bij: React Forget. Deze nieuwe compiler maakt memoization grotendeels automatisch. Waar we vroeger zelf moesten nadenken over useMemo en useCallback, zal React zelf bepalen wat onthouden moet worden. Dat moet niet alleen her-renders verminderen, maar ook inconsistenties tussen renders en commits voorkomen.
Pļavenieks toonde hoe React 19 dankzij “partial signals” en een slimmer diff-algoritme alleen datgene her-rendert wat écht nodig is. Toch waarschuwde hij dat geen enkele tool de verantwoordelijkheid van ontwikkelaars overneemt: “There’s no single performance metric that tells the full story. Smoothness is what users feel — not what you measure.”
Hij sloot af met een belangrijke boodschap voor teams: performance is niet iets dat je aan het eind van een sprint test. Het moet een structureel onderdeel zijn van het ontwikkelproces. Gebruik flamegraphs, meet core web vitals zoals INP en/of TBT en leer de commit phase begrijpen — want dáár ligt de echte kost van re-renders.
Debug Like a Pro: Unlocking Hidden Power in the Latest Chrome DevTools – Talia Asghar
Ik denk dat iedere ontwikkelaar wel eens vastzit. Je zit urenlang te staren naar je scherm, breakpoints gezet, logs gecheckt, maar het probleem blijft zich verstoppen. Debuggen kan frustrerend zijn — en zoals Kerninghan’s Law zegt: “Debugging is twice as hard as writing the code in the first place.”
Tijdens de sessie van Talia Asghar, Developer bij Delivery Hero en Google Developer Expert, ontdekte ik dat Chrome DevTools veel krachtiger is dan ik dacht. Het gaat verder dan inspecteren en breakpoints zetten. Er schuilen verborgen tools die je debugging-game volledig kunnen veranderen.
Een nieuwe kijk op DevTools
De sessie begon met een vraag: “Welke Chrome DevTools heb je nog nooit gebruikt?” De resultaten waren verrassend. Meer dan de helft van de aanwezigen had nog nooit van Sensors of AI Assistance gehoord. Dat zette me aan het denken: hoeveel verborgen parels liggen er nog in onze tools die we simpelweg niet gebruiken? Talia nam ons mee langs tien functies die niet alleen tijd besparen, maar ook je manier van werken verandert.
De magie van Sensors
Eén demo die bleef hangen, was Sensors. Met een paar klikken emuleerde Talia een apparaat in een andere tijdzone, veranderde de locatie en schakelde naar een andere taal. Plots zag ik hoe makkelijk het is om te testen voor internationale gebruikers zonder een fysiek device aan te sluiten. Voor iemand die werkt aan apps met meerdere talen of locatie-afhankelijke features, is dit echt heel waardevol.
CSS Overview: schoon schip maken
Tijdens de CSS Overview demo ontdekte ik hoe eenvoudig het is om inconsistenties in je design system te vinden. Contrastproblemen voor toegankelijkheid? Check. Ongebruikte CSS-regels? Check-check. Inconsistent gebruik van knoppen of kleuren? Ook check. Deze tool voelde als een extra paar ogen die je project kritisch doorlicht.
Local Overrides: vrijheid in debuggen
Een van mijn favoriete momenten was de demo over Local Overrides. Stel je voor: je front-end hangt vast, omdat het back-end nog niet klaar is. Normaal zou je moeten wachten, maar met local overrides kun je content, API-responses of zelfs scripts lokaal aanpassen en testen alsof het live is. Niet wachten, geen frustratie — gewoon doorwerken.
Autofill en performance monitoring
De demo over Autofill Debugging liet zien hoe je formulieren test met verschillende adressen en landen. Voor developers die werken aan internationale formulieren is dit heel waardevol. En dan was er nog de Performance Monitor, waarmee je realtime CPU en geheugenverbruik ziet. Samen met de Coverage tool die ongebruikte code aan het licht brengt, voelt dit als een toolbox voor optimale performance.
AI Assistance: debuggen met een assistent
Er zit ook een AI-assistent in DevTools. Je stelt vragen over je pagina of een API-call en krijgt direct inzichten, zonder dat je hoeft te wisselen tussen tools.
The Tech Behind Buienradar: How Technology Keeps You Ahead of the Weather — Neel Bhatt
De talk van Neel Bhatt, software engineer bij RTL Nieuws (eigenaar van Buienradar), bood een zeldzaam kijkje achter de schermen van Nederlands populairste weerplatform. Hij begon met een eenvoudige observatie: “In Nederland is regen niet zomaar weer — het is cultuur.” Buienradar is met 93,5 miljoen pageviews per dag en 7,5 miljoen unieke gebruikers per maand het drukst bezochte weerplatform van het land. Wat velen echter niet weten, is dat dit alles wordt onderhouden door een team van slechts zeven ontwikkelaars. Iedere vijf minuten worden nieuwe radarbeelden verwerkt, afkomstig van meer dan tachtig radars en tien waarschuwingssystemen, goed voor miljoenen alerts per dag.
Van stormachtige monoliet naar schaalbare microservices
Bhatt schetste hoe Buienradar jarenlang draaide op een monolithische architectuur die regelmatig bezweek onder zijn eigen succes. Eén bug kon het hele systeem platleggen, releases veroorzaakten nachtelijke stress en trage pagina’s misten soms letterlijk de regen waarvoor ze bedoeld waren. Slechte observability maakte het bovendien lastig om problemen te lokaliseren en op social media kon één foutieve voorspelling een storm aan kritiek veroorzaken. In plaats van meer hardware toe te voegen of de schuld bij upstream-providers te leggen, besloot het team tot een fundamentele herziening. Het motto werd: “True scalability is culture plus code moving faster than the storm.” Ze kozen voor een DevOps-mentaliteit waarin elasticiteit, resilience, observability, automatisering en prestatieoptimalisatie centraal staan.
Turning the tide
De nieuwe infrastructuur draait op Kubernetes, met ArgoCD en GitOps als basis voor volledig geautomatiseerde en versiebeheerde deployments. De overgang van een monoliet naar microservices bracht flexibiliteit en zelfherstellend vermogen. Wanneer één service faalt, blijft de rest operationeel. Deployments verlopen zonder downtime dankzij canary releases, feature flags en automatische rollback-mechanismen. De voordelen zijn meetbaar: 93,5 miljoen views per dag, 200 miljoen API-requests, 1,6 miljoen gelijktijdige gebruikers en razendsnelle API’s — de Image API reageert in 30 ms, Graph API in 20 ms, Location API in 17 ms en Forecast API binnen 200 ms.
Observability en weerbestendig ontwerpen
Een belangrijk thema was observability. Met OpenTelemetry, Grafana Loki en een uitgebreid dashboard krijgt het team realtime inzicht in latency, CPU-belasting, foutpercentages en ontbrekende datapunten. Problemen worden zichtbaar nog vóór gebruikers er iets van merken. Ook bij het ontwerp van de systemen is rekening gehouden met falen. Bhatt beschreef hoe circuit breakers, retries met exponential backoff, failover-mechanismen en self-healing pods helpen om incidenten op te vangen zonder merkbare impact. Automatische alerts via PagerDuty en postmortems zorgen ervoor dat elk incident wordt geanalyseerd en verbeteringen structureel worden doorgevoerd.
Snelheid en efficiëntie als kernwaarde
Om latency laag te houden, maakt Buienradar gebruik van caching, CDN’s, asynchrone verwerking, compressie, minificatie en NoSQL-databases zoals Elastic en MongoDB. Hierdoor blijft het platform responsief, zelfs onder zware belasting. Bhatt sloot af met een vooruitblik. Het team experimenteert met 3D-weermodellen, AI-ondersteunde code review en verdere verfijning van observability. Zijn conclusie was helder: schaalbaarheid draait niet alleen om technologie, maar om cultuur, discipline en een team dat leert bewegen met de storm in plaats van ertegenin.
Conclusie van het evenement
Frontmania 2025 laat de breedte zien van front-end development. Het is niet alleen de visuele weergave, schaalbare systemen, slimme observability en een nauwe samenwerking tussen mens, machine en architectuur. Van de filosofische diepgang van reactive programming tot de praktische kracht van web components, van AI in design systems tot de precisie van performance-optimalisatie en DevTools. Elke talk benadrukte dezelfde beweging: een vakgebied dat continu leert, automatiseert en evolueert. De toekomst van front-end is niet één framework, maar een mindset die even veerkrachtig en reactief is als de systemen die we bouwen.
Op 3 juni 2025 bezocht ik de Full Stack Conference in Utrecht: een dag vol inspiratie, kennisdeling en technische diepgang. Deze blogpost is geschreven voor een technisch publiek, maar iedereen is welkom om het te lezen. De conferentie bracht developers van allerlei disciplines samen – van frontend tot backend, van DevOps tot AI. In dit verslag neem ik je mee langs de sessies: een praktische blik op AI zonder de hype en een boeiende introductie in de wereld van observability met OpenTelemetry.
Of je nu zelf ontwikkelaar bent, of gewoon benieuwd naar wat er speelt in de wereld van moderne softwareontwikkeling – ik hoop dat dit verslag je nieuwe inzichten of ideeën geeft.
Jessy The – AI zonder de hype: hoe je AI wél goed inzet
Na de lunch kwam frontend developer “Jessy The” het podium op, met zichtbaar enthousiasme. Niet iemand die zomaar met de AI-hype meevaart, maar juist iemand die probeert te begrijpen wat AI echt voor developers betekent. “AI is geen magie,” begon ze. “Het is gewoon een tool – en met grote kracht komt grote verantwoordelijkheid.” (Ja, Spider-Man werd nog even aangehaald.)
Jessy nam ons mee in haar eigen avontuur. Ze bouwde een app: een AI talk coachdie op basis van een LinkedIn-profiel advies geeft over passende sprekers of tech talks. Ze gebruikte Next.js voor de frontend en Flask (Python) voor de backend. De AI-functionaliteit? Die kwam van OpenAI en modellen van Hugging Face zoals Google’s FLAN-T5.
Maar voordat ze begon met bouwen, stelde ze zichzelf en ons voor een hele belangrijke vraag:
“Moet mijn app eigenlijk wel AI gebruiken?”
Niet elk project heeft baat bij AI. Soms is een simpele regels-engine effectiever, goedkoper én betrouwbaarder. Ze gaf voorbeelden van waar AI waarde toevoegt:
Bij complexe beslissingen waar geen vaste regels voor zijn
Wanneer je UX kunt verbeteren door slimme suggesties
Als er daadwerkelijk een probleem is dat AI kan oplossen
Daarna legde ze drie routes uit om AI toe te voegen aan je app:
Een kant-en-klare API gebruiken (zoals ChatGPT)
Een bestaand model finetunen
Een compleet eigen model trainen vanaf nul
Die laatste optie is alleen voor de echte avonturiers: duur, tijdrovend en risicovol. “Ze vergeleek het met een stagiair op een middelbare school, dat kost veel tijd om die op te leiden.”
Het AI-trainingsproces
Jessy ging vervolgens de diepte in over fine-tuning. Ze zag het als een leerproces waarbij jij de leraar bent en de AI de leerling. “Je bouwt een soort curriculum. Je bepaalt wat belangrijk is, wat de juiste antwoorden zijn en je voert het de juiste voorbeelden.”
Ze besprak het trainingsproces in 8 stappen:
Begrijp het model
Definieer je taak
Verzamel of bouw een dataset
Bepaal het leerdoel
Kies je model (grotere modellen zijn krachtiger, maar langzamer)
Fine-tune met tools zoals Hugging Face en Google Colab
Meet je training- en validatieverlies
Test en evalueer
Ze waarschuwde voor gevaren zoals hallucinatie (AI verzint dingen), input/output mismatch en het fenomeen van catastrophic forgetting: als je een model té hard traint op nieuwe data, vergeet het ineens alles wat het eerder wist.
“Het is net als leren met flashcards. Eerst begrijp je het niet, dan oefen je en op een gegeven moment snap je het. Maar je moet ook blijven checken of je nog weet wat je eerder hebt geleerd.”
Tot slot sloot ze af met een warme oproep:
“Gebruik AI bewust. Niet omdat het hip is, maar omdat het echt iets toevoegt voor de gebruiker.”
Alexander Chatzizacharias & Riccardo Lippolis – Operational Excellence met OpenTelemetry
De volgende sessie begon met een bijna theatraal verhaal. Alexander en Riccardo, twee backend developers, vertelden hoe hun team ooit in de situatie zat dat niemand wist wat er in productie gebeurde. Als er iets kapot ging? Slack. Paniek. Debuggen met screenshots.
Hun reis naar Operational Excellence begon uit frustratie. Ze wilden af van het reactieve brandjesblussen en toe naar inzicht, rust en controle.
Wat ze misten was observability – het vermogen om te zien wat er gebeurt. Niet alleen als iets fout gaat, maar ook waarom en waar in je systeem. Ze legden uit dat observability meer is dan monitoring. Het is een combinatie van:
Logs – de details
Metrics – de getallen
Traces – de reis van een request
De OpenTelemetry-aanpak
Ze introduceerden OpenTelemetry (OTel) als dé manier om al deze data te verzamelen op een open, gestandaardiseerde manier. Geen vendor lock-in, geschikt voor elke techstack (Java, Go, Python, etc.) en met krachtige integraties zoals:
Grafana
ELK Stack
Jaeger
Ze demonstreerden dit met een kleine game die ze gebouwd hadden: een Flappy Bird clone. Elke klik van de speler werd getraceerd. Je kon in Grafana exact zien:
Hoe vaak iemand scoorde
Waar de fouten zaten
Wat er in de logs stond op dat moment
Traces lieten letterlijk zien welke microservice werd geraakt bij elk request – alsof je een soort detective bent in je eigen landschap.
“Outage? It’s a microservice murder mystery!”
Ze bespraken ook de rol van de OpenTelemetry Collector: een centrale plek die data verzamelt en doorstuurt naar visualisatietools. Belangrijk: je kunt zelf configureren welke data waarheen gaat, ideaal voor privacy en interne netwerken.
Waarom zou je dit doen?
“Omdat je landschap complexer wordt. De techstack wordt diverser. En je gebruikers verwachten stabiliteit.”
Met observability kun je:
Proactief fouten opsporen
Performance optimaliseren
Debuggen zonder giswerk
Jezelf en je team tijd besparen
Ze sloten af met een oproep:
“Operational Excellence is niet saai. Het is juist wat je nodig hebt om te groeien – en je gebruikers serieus te nemen.”
Bart Wullems – A Gentle Introduction into Property-Based Testing (Test Automation)
Bart Wullems, MVP bij Microsoft en lead architect bij de Vlaamse Landmaatschappij, gaf een toegankelijke introductie in property-based testing. Hij begon met een persoonlijk verhaal over een dure bug tijdens een project waarbij handmatig 400.000 brieven verstuurd werden via een complexe Windows-service. Na een fout gingen 10.000 brieven de deur uit met verkeerde informatie, wat leidde tot een schadepost van €43.000. Deze bug was te wijten aan het ontbreken van goede tests, wat hem ertoe bracht zijn testaanpak grondig te herzien.
Van example-based naar property-based testing
Bart legde het verschil uit tussen traditionele example-based testing (waarbij een paar voorbeeldwaarden getest worden) en property-based testing (waarbij eigenschappen van de functionaliteit worden getest met willekeurige data).
Example-based: test input zoals add(1, 2) = 3.
Property-based: test algemene eigenschappen, zoals commutativiteit: add(a, b) == add(b, a).
Wat is een “property”?
Een property is een regel of verwachting waaraan alle geldige input/output-combinaties moeten voldoen, zoals “de som van twee positieve getallen is altijd groter dan elk van de getallen afzonderlijk”.
Tools en voorbeelden
Bart demonstreerde tools zoals FsCheck, jqwik en Fast-check (JavaScript). Via generators worden automatisch invoerwaarden gegenereerd. Bij een fout wordt via shrinking het kleinste foutieve voorbeeld gezocht, wat debugging makkelijker maakt.
Praktische toepassingen
Wiskundige eigenschappen: associativiteit, commutativiteit en idempotentie
Business rules: domeinspecifieke eisen, zoals de uitkomst van een algoritme of sortering
Edge cases: nulls, lege lijsten en negatieve getallen
Conclusie
Property-based testing dwingt je om dieper na te denken over je vereisten. Het is geen vervanging van example-based tests, maar een waardevolle aanvulling die helpt om edge cases en algemene fouten eerder te ontdekken.
Jeroen Resoort – Running LLMs on Commodity Hardware: Private, Practical, and Powerful
Jeroen Resoort gaf een praktische en toegankelijke sessie over het draaien van Large Language Models (LLMs) op betaalbare en lokale hardware. De focus lag op privacy, controle en betaalbaarheid, met tools als Ollama en Open Web UI.
Waarom lokaal draaien?
Geen dataverlies: alles draait op je eigen machine
Geen logging of tracking
Geen maandelijkse kosten
Meer controle en aanpasbaarheid
Mogelijkheid om ongefilterde modellen te gebruiken
Gebruikstoepassingen
Tekstanalyse en parsing
Code review en assistentie (bijv. in IntelliJ via DevoxxGenie)
Afbeeldingengeneratie met tools zoals Stable Diffusion
Spraakherkenning via Whisper
Modellen en performance
Er zijn veel modellen beschikbaar, o.a.:
LLaMA 3.2
Gemma
Mistral en Mixtral (Mixture of Experts)
CodeLlama voor codeertaken
Afwegingen zijn onder meer de grootte van het model (parameters), het geheugengebruik, tokens per seconde en de context window size.
Technieken voor optimalisatie
Quantization: van 16-bit naar 8-bit om geheugen te besparen
Mixture of Experts: modellen zoals Mixtral gebruiken gespecialiseerde submodellen voor snellere inferentie
Preloading en keep-alive: om laadtijden te verminderen
Hardwareoverwegingen
Minimaal: laptop met voldoende RAM (32–64GB)
Optimale setup: Mac Studio, krachtige GPU of server
Clusters: meerdere goedkope servers via RPC, maar niet per se sneller
Tot slot
Het draaien van LLM’s lokaal is mogelijk én praktisch. Het vereist wel enige hardwarekennis en een balans tussen performance, geheugen en use-case. Tools als Ollama en Open Web UI maken het toegankelijker dan ooit.
Lightning Talks
Talk 1: Rasmus Renvall – Hidden Costs of “Ready-Made” Platforms
Rasmus Renvall deelde een herkenbaar patroon: de verleiding om kant-en-klare platformen zoals Dataiku te kopen – tools die “alles beloven”, maar in de praktijk toch onverwachte kosten en obstakels met zich meebrengen.
Rasmus kwam met voorbeeld uit het werk: het team demonstreerde een nieuwe AI-platformoplossing. De demo zag er indrukwekkend uit: realtime inzichten, automatisering en veelbelovende resultaten. Het leek zelfs de boilerplate-code te kunnen vervangen. Iedereen was enthousiast, de beslissing werd genomen: kopen die handel!
Het patroon
In plaats van een gedeelde basis, gingen teams in de cloud allemaal aan de slag met hun eigen datasets en hun eigen interpretaties. Verschillende versies van data circuleren, wat leidt tot mismatchende uitkomsten. Bucket A heeft iets anders dan Bucket B. Samenwerking voelt ineens als een last: het platform “helpt” wel, maar lost het kernprobleem – communicatie en afstemming – niet op.
Reality check
De lokale mappen zijn nu vervangen door cloud buckets, maar de fragmentatie blijft
De maandelijkse factuur? Equivalent aan één of twee fulltime engineers
Kennisdeling stokt. Silo’s ontstaan. De samenwerking die beloofd werd, is vooral afhankelijk van de mensen – en die zijn vaak te druk
Wat dan wel?
Rasmus’ oplossing is simpel, maar krachtig: breng mensen weer bij elkaar. Ga in gesprek, creëer gezamenlijke definities van data en processen en werk stapsgewijs aan échte samenwerking. Technologie is een hulpmiddel, geen magische oplossing.
Eerst de communicatie oplossen, dan pas de tooling. Fix the people, not just the platform.
Talk 2: Ramona Domen – We Need You: Accessibility on the Web
Ramona Domen hield een pleidooi voor digitale toegankelijkheid (a11y) en ze maakte meteen duidelijk: we hebben iedereen nodig.
Ze begon met een persoonlijk voorbeeld: de vroedvouwenschool in Heerlen waar haar kind was geboren, voor 100 jaar geleden was er bijvoorbeeld lift. Fysieke toegankelijkheid was er niet. Helaas geldt dat ook nog vaak voor het web.
Waarom is digitale toegankelijkheid belangrijk?
Kleurblindheid: 12% van de mannen
Neurodivergentie: ca. 50% van developers (ADHD, autisme etc.)
Leeftijd: iedereen wordt ouder, met visuele of motorische uitdagingen
Tijdelijke beperkingen: gebroken arm, huilende baby, vertraagde vlucht etc.
Toegankelijkheid helpt iedereen. Denk aan ondertitels, duidelijke focus-indicatoren, schaalbare lettertypes en alternatieve teksten voor afbeeldingen.
Wat kun jij doen?
Praat erover in je team
Maak het bespreekbaar bij planning en design
Gebruik de WCAG-checklist
Hou het simpel
Toegankelijkheid is niet ingewikkeld, maar vraagt wél bewustzijn. En dat begint bij jou.
Talk 3: Edo Poll – What is a System Anyway? A Little Play
Edo Poll sloot af met een luchtige, maar scherpe mini-performance over systeemdenken. Zijn vraag: “Wat ís een systeem eigenlijk?”
Aan de hand van een sketch over een NS-fiets-parkeerapp en de bijbehorende backends, liet hij zien hoe makkelijk het is om race conditions, edge cases en onbedoelde interacties over het hoofd te zien als je alleen naar je eigen deel kijkt.
De kernboodschap: een systeem is meer dan code – het is ook gedrag, communicatie en interactie tussen onderdelen.
Hij gebruikte humor om duidelijk te maken dat systemen niet altijd rationeel of logisch gedragen – net als mensen. Een oplossing die “perfect” lijkt, kan totaal verkeerd uitpakken in een andere context, of als gebruikers onverwacht gedrag vertonen.
Zijn conclusie: systeemdenken vereist dat je uitzoomt. Kijk naar het grotere geheel. Vraag niet alleen: “Werkt mijn stukje?”, maar ook: “Wat gebeurt er als alle stukjes samenwerken?”
Sander Hoogendoorn – Seven Habits of a Highly Successful Team
Sander Hoogendoorn sloot de dag af met een energieke en inspirerende keynote over teamwerk in softwareontwikkeling. De centrale boodschap: software development is een teamsport. En succesvolle teams? Die hebben gewoontes – zeven om precies te zijn.
De realiteit van vandaag
Veel teams kampen met technische schuld, complexe platformlandschappen en verstikkende afhankelijkheden. Wat is het echte probleem? Niet alleen de monolith, maar vooral: de organisatie en cultuur eromheen.
Refactoring wordt uitgesteld (“de afwas stapelt zich op”)
Veranderingen zijn onvermijdelijk – maar worden vaak niet omarmd
De echte bottleneck zit niet bij de developers, maar in de structuur en besluitvorming
De zeven gewoontes van succesvolle teams
Sander deelde de zeven gewoontes die teams helpen om succesvol te zijn.
1. Prioriteer pragmatisch
Je kunt je tijd maar één keer uitgeven. Dus besteed die gericht:
70% innovatie
20% renovatie
10% bugs en onderhoud (“keep the lights on”)
Werk toe naar het gezamenlijke doel (“de stip op de horizon”). Gebruik een tech board om ideeën te toetsen: helpt dit ons écht vooruit? Is het klein genoeg? Is het urgent? Of moet het naar de “someday/maybe” backlog?
2. Continue vernieuwing in kleine stappen
De winkel moet open blijven terwijl je verbouwt. Denk klein. Experimenteer. Falen hoort erbij. Sander verwees o.a. naar de Cynefin framework: softwareontwikkeling is vaak complex of zelfs chaotisch – dus niet strak te plannen.
“Coddiwomple” – een woord voor doelgericht ronddwalen. Kleine stappen, feedback, aanpassingen.
3. Eigenaarschap op teamniveau
De kleinste eenheid van eigenaarschap is niet de developer, maar het team. En teams moeten autonomie hebben om keuzes te maken. Dáár ontstaat de magie.
Zelforganisatie is lastig, maar noodzakelijk. Je leert door te doen – en door te mogen falen.
4. Minder regels, meer vertrouwen
Inspiratie van Dee Hock (oprichter van Visa): hoe minder regels, hoe meer zelfregulatie. Sander gaf het voorbeeld van verkeersregels: minder verkeersborden → mensen gaan rustiger rijden, omdat ze elkaar aankijken. Vertrouwen en visuele communicatie in plaats van bureaucratie.
“Perfectie is niet wanneer er niets meer toe te voegen is, maar wanneer je niets meer kunt weglaten.” – Antoine de Saint-Exupéry
5. Microteams bouwen
Kleine en tijdelijke teams voor specifieke problemen:
Pick a problem
Form a team
Discuss a solution
Work
Report as done
Disband
Repeat
Snellere doorlooptijd. Minder afhankelijkheden. Flexibel en wendbaar.
6. Continu leveren
Van waterval naar trunk-based development. Geen pull requests en geen wachttijden. Lever meerdere keren per dag. Automatisering is cruciaal. “Code met vertrouwen.”
Sander haalde o.a. Jez Humble aan (Continuous Delivery): releases moeten zo klein zijn dat je “de bus kunt missen” en het geen ramp is.
7. Purpose, mastery & autonomy
Wat motiveert mensen écht? Niet regels of controle, maar:
Purpose – zinvol werk doen
Mastery – ergens beter in worden
Autonomy – ruimte om te beslissen
Afsluiting
Sander sloot af met een dosis humor en levensfilosofie:
“Waarom zijn we eigenlijk nooit naar Italië gegaan?” vroeg zijn moeder aan hem
“Oude sleutels openen geen nieuwe deuren.”
Durf te veranderen. Blijf leren. En bovenal: heb plezier.
“If all else fails: rm -rf node_modules && npm install.”
Conclusie
De Full Stack Conference 2025 bood een mix van inspiratie, technische diepgang en praktijkgerichte sessies. Wat alle sprekers gemeen hadden, was hun nadruk op bewust kiezen: gebruik AI niet omdat het hip is, maar omdat het iets wezenlijks toevoegt. Observeer je systemen niet oppervlakkig, maar met inzicht en context. Test niet alleen met voorbeelden, maar vanuit eigenschappen en intentie. Draai LLMs niet per se in de cloud, maar misschien wel gewoon lokaal – als dat beter past bij je use case of waarden.
Of je nu frontend-, backend- of DevOps-engineer bent: deze dag herinnerde ons eraan dat moderne softwareontwikkeling niet alleen gaat over tools en stacks, maar over het maken van doordachte keuzes. Technologie inzetten waar het écht werkt en waar je als team en gebruiker beter van wordt.
Zaterdag 17 mei 2025 was het zover: de allerlaatste editie van .NET Saturday. Dennis Vroegop opende de dag met een heldere boodschap: het doel van deze meetup-reeks is bereikt. Na meer dan 25 jaar community-opbouw, kennisdeling en enthousiasme is .NET volwassen geworden. Deze blogpost is geschreven voor een technisch publiek, maar iedereen is welkom om het te lezen.
Tijdens deze sloteditie waren er weer volop inspirerende sessies. In deze blog neem ik je mee langs een aantal van de talks die indruk maakten – en wat we er als ontwikkelaars van kunnen meenemen.
Overzicht houden in je dependencies – Supply Chain Security
Tom van den Berg beet het spits af met een sessie over supply chain security, een onderwerp dat steeds belangrijker wordt in een wereld waarin we nauwelijks nog alles zelf schrijven. Hij schetste hoe slechts een fractie van je code echt door je team is gemaakt. Het overgrote deel – denk aan libraries, packages, transitive dependencies – komt van buiten. En daarmee komen ook risico’s mee, zoals bleek uit eerdere kwetsbaarheden als Log4Shell en de SolarWinds-aanval.
Tom benadrukte het belang van zichtbaarheid: weet wat je binnenhaalt. Tools als Trivy kunnen je helpen om licentieconflicten en kwetsbaarheden te detecteren, nog voordat je een PR merged. Ook wees hij op het belang van een SBOM (Software Bill of Materials), straks zelfs verplicht onder de aankomende Cyber Resilience Act. En ja, zelfs je “NuGet Prefix Reserved”, bleek ineens een veiligheidsmaatregel. Dit voorkomt dat anderen packages onder jouw naam kunnen reserveren.
Wat deze sessie sterk maakte, was de vertaling van beleidsniveau naar praktische ontwikkelkeuzes. Minder afhankelijkheden, zorgvuldiger keuzes, en iets vaker de vraag: “Moeten we deze package écht gebruiken?”
Inzicht in gedrag met Application Insights
Mart de Graaf nam ons daarna mee in de wereld van observability, met een focus op Azure Application Insights. Waar veel developers vooral logs als naslag gebruiken, liet Mart zien hoe je met structured logging, metrics en dashboards waardevolle realtime inzichten kunt krijgen in het gedrag van je applicatie.
Hij toonde hoe je met KQL (Kusto Query Language) gericht kunt zoeken in je logdata, hoe je dashboards maakt die je direct inzicht geven in performance of errors en hoe sampling je kan helpen om log noise te reduceren. Ook custom dimensions kwamen voorbij – kleine toevoegingen aan je logs die net dat beetje extra context geven.
Wat vooral bleef hangen, was hoe je Application Insights niet alleen kunt gebruiken voor troubleshooting, maar juist ook als proactieve tool om je applicatie te begrijpen. En met een beetje extra moeite kun je zelfs workbooks bouwen en ze automatiseren via Bicep. Observability als vast onderdeel van je ontwikkelcyclus, in plaats van een afterthought.
Azure Container Apps als sweet spot
Geert van der Cruijsen nam ons daarna mee naar de wereld van Azure Container Apps (ACA). Voor wie Kubernetes te complex vindt, maar Azure App Services te beperkt, vormen Container Apps een krachtig alternatief. Geert legde uit hoe Azure Container Services (ACA) een hoop DevOps-zorgen wegneemt – geen clusterbeheer, geen pod-scheduling, gewoon je container deployen en schalen op events of load.
Wat de sessie overtuigend maakte, was hoe soepel de developer experience is. Geert demonstreerde onder andere blue/green deployments, schaalbare background jobs, en integratie met Dapr en service mesh. In combinatie met het nieuwe Aspire-dashboard krijg je als developer bijna vanzelf een goed inzicht in de gezondheid van je applicatie.
De boodschap was helder: ACA is geen vervanging van Kubernetes, maar wél een bijzonder aantrekkelijke optie voor veel workloads waar snelheid, eenvoud en schaalbaarheid belangrijk zijn – zonder zelf een platformteam op te tuigen.
Kubernetes
Voor wie dan toch nieuwsgierig bleef naar Kubernetes (k8s), was er de sessie van Joost van Uitert. Geen marketingverhaal, maar een technisch diepgaande sessie over hoe Kubernetes van binnenuit werkt. Joost bouwde een eigen cluster op een mini-pc met een N100-processor en gaf uitleg over het hart van Kubernetes: etcd, de control plane, en de scheduler.
Hij legde op een heldere manier uit hoe Kubernetes het verschil bijhoudt tussen de ‘desired state’ en de ‘current state’ en hoe k8s met behulp van controllers en reconciliation loops probeert die twee op elkaar af te laten stemmen. Ook de Raft-algoritmes achter etcd kwamen aan bod, net als hoe networking via kube-proxy wordt geregeld.
Het gaf een beter begrip van waarom k8s soms zo “complex” voelt – maar ook hoe robuust en doordacht het systeem eigenlijk is. Vooral als je je tooling op orde hebt, zoals K9s, wordt het managen van een cluster ineens veel tastbaarder.
Nullable & Required Properties
Tot slot gaf Shawn Wildermuth een verhelderende sessie over het juiste gebruik van nullable en required properties in C#. Hoewel kort van duur, raakte zijn verhaal precies de kern van een veelvoorkomend pijnpunt: de impliciete aannames in onze modellen.
Met de introductie van required-properties en nullable-reference types in C# kun je als ontwikkelaar veel explicieter zijn over je intenties. Wat móet er aanwezig zijn in een object en wat mag eventueel ontbreken? Shawn liet zien hoe deze features niet alleen bugs voorkomen, maar vooral ook communicatie verbeteren – zowel binnen je team als in de contracten tussen verschillende lagen of systemen.
Zijn uitleg over het semantische verschil tussen “iets wat een object is” en “iets wat een object wil zijn” – de grens tussen optional en required – gaf echt stof tot nadenken. Vooral bij het ontwerpen van DTO’s of API-modellen is het belangrijk om je model duidelijk uit te spreken: dit moet er zijn, dit mag null zijn en dit mag zelfs helemaal ontbreken.
Conclusie
Voor mij was het vooral een dag van verdieping hernieuwde inspiratie. Als je kijkt naar hoe breed het scala aan onderwerpen was – van supply chain security tot observability, van managed containers tot type safety – dan zie je precies waarom .NET vandaag nog net zo relevant is als toen het begon.
Dank aan alle sprekers, organisatoren en bezoekers voor deze prachtige afsluiter. En zoals Dennis mooi verwoordde: “Het doel is bereikt.” Maar dat betekent natuurlijk niet dat we stoppen met leren.