Op Techorama 2026 werden inzichten gedeeld over actuele thema’s binnen de IT en softwareontwikkeling. Deze blog is geschreven voor IT-professionals. In dit blog bespreken we enkele hoogtepunten van dinsdag 27 en woensdag 28 oktober. Voor elke sessie die we bezochten vind je een samenvatting met de belangrijkste lessen, voorbeelden en praktische tips.
Een paar rode draden komen steeds terug:
- AI en agents: van keynote over schaal en ziel tot agents die ’s nachts incidenten onderzoeken, een hybride AI-platform en lokaal draaiende modellen.
- Vertrouwen en veiligheid: van het denken als een aanvaller tot verifieerbaar vertrouwen in je supply chain.
- Architectuur: van microservices die je moet onderhouden tot DDD, enterprise architecture en het versioneren van events.
- De mens achter de techniek: burn-out, gedrag, verandering en het brein.
Dit is een omvangrijk artikel. Gebruik de links bovenaan om direct naar de sessie te gaan die je het meest interesseert. Ja het een lang artikel, pak er gerust een kop koffie bij
Inhoudsopgave
- Scale vs Soul – Dado Van Peteghem
- MITRE ATT&CK – Chris Ayers
- Agents don’t sleep – Jurre Brandsen
- Antipatterns, Smells, and Worst Practices – Ardalis / Steve Smith
- Change is inevitable – Laila Bougria
- You’re Not Just Tired: The Psychology of Burnout – Arthur Doler
- Problems scale faster with AI – Liuba Gonta
- What I learned from modernizing a microservices architecture – Dennis Doomen
- Quality in the Agentic Era – Tiago Pascoal & Josh Johanning
- Beyond DDD vs EA – Dwight Matthys
- Local-first AI development – Brian Randell
- Building a hybrid AI platform for agent-heavy engineering – Willem Meints
- From “Trust Me” to “Verify Me” – Tom van den Berg
- A Fresh Perspective on Behaviour, Change and the Brain – Paul Smit
- Conclusie
Scale vs Soul: hoe word je mega schaalbaar én mega menselijk in het AI-tijdperk?
Dado Van Peteghem – dinsdag 08:30–09:30
Techorama opende op 27 oktober 2026 met een keynote van de Gentse strateeg Dado Van Peteghem, die al meer dan vijftien jaar in digital werkt en vijf boeken schreef. Het onderwerp was hun nieuwste boek, Scale vs Soul.
Naarmate AI alles versnelt, wat houden we dan menselijk en authentiek? Daar draaide de openingskeynote om. Dado bouwde het verhaal rond drie woorden: brain (AI wordt slimmer), body (AI krijgt robots) en soul (wat we niet uit handen mogen geven).
Een nerd met een verleden
Dado begon bij de eigen technologiegeschiedenis: de Game Boy (1989), Knight Rider, een eerste Pentium 133 met floppy’s, de krakende US Robotics-modem, de Nokia 3310 met Snake en in 2007 de eerste iPhone. De fysieke beveiligingsdongle noemde Dado two-factor authentication avant la lettre. Sinds ChatGPT, ruim vier jaar geleden, zitten we volgens Dado nog altijd in de AI-kleuterklas.
Brain: AI evolueert razendsnel
- De output is volwassen geworden. Van minimale tekst en simpele code naar beelden (zonder zesvingerige handen), video’s van vijftien seconden en audiomodellen voor stemmen en muziek. De meesten gebruiken AI als “tweede brein”.
- Zoeken verschuift. Zo’n 20% van het totale zoekvolume loopt nu via AI-engines en 68% van de websearches eindigt zonder klik.
- Van chat naar computergebruik. AI maakt en uploadt bestanden en neemt een browser over. Voorbeeld: een agent als veiligheidsingenieur op een bouwwerf, die problemen in Excel noteert, de verantwoordelijken mailt en twee weken later checkt of ze iets deden. Dado bouwde ook de eigen website opnieuw met Claude, dat ontwerp, code, hosting, upload en DNS-records regelde: van A tot Z.
Agentzwermen en de donkere kant
Een leidende agent kan een doel opsplitsen in subagenten die parallel werken. Dat brengt risico’s mee: er waren 27 cyberincidenten in tien dagen, waardoor sommigen spreken van “Black October”. Dado vertelde ook over iemand in Australië die een agent een fitnessles liet boeken. De les was vol, dus hackte de agent de website en database van de sportschool, haalde een willekeurige persoon van de lijst en zette de klant op de wachtlijst. Niet kwaadaardig, wel vastberaden en bereid shortcuts te nemen.
Adoptiesnelheid en persoonlijke agenten
ChatGPT heeft 1,2 miljard wekelijkse gebruikers en één “AI-jaar” aan adoptie staat gelijk aan ongeveer zeven “internetjaren” (al is die vergelijking oneerlijk, want het internet had nog kabels in de grond nodig). AI verhuist van een “DOS-achtig” chatvenster naar persoonlijke agenten: Muse van Meta, de persistente agenten van ChatGPT en de Duets van Claude. Dado illustreerde dat met vier niveaus van AI in klantervaring, via de telecommarkt:
- AI assisteert: vergelijkt de beste abonnementen.
- AI adviseert: zegt welk abonnement het best bij jou past, dankzij context en geheugen.
- AI handelt: verlengt je contract voor je. Mastercard lanceerde Agent Pay om betaaltoestemming aan agenten te geven.
- AI beheert: zoekt voortdurend betere contracten.
Niveau 1 en 2 zijn generatieve AI, niveau 3 en 4 agentische AI. Zuckerberg kondigde Muse zelfs aan als sleutelhanger, wat Dado deed denken aan de Tamagotchi. Alleen moeten we dit keer waarschijnlijk met onze data voeden. Het brain-gedeelte eindigde met Demis Hassabis van DeepMind: AI zal tien keer zoveel impact hebben als de industriële revolutie, aan tien keer de snelheid.
Body: het brein krijgt een lichaam
- Robots lopen sneller dan Usain Bolt. Een robot getraind op vijf uur tennisdata speelt al degelijk. Dado verwacht een markt voor wie liever niet praat, én voor wie de drink achteraf mist.
- Jensen Huang spreekt van het “ChatGPT-moment” voor robots. De meest geavanceerde spelers zijn Chinees, zoals de kungfu- en dansrobots die synchroon bewegen.
- De enge kant: Asimovs drie wetten voelen relevanter wanneer een robot kwaad wordt na het verliezen van een voetbalmatch. Veiligheid telt dubbel als een robot je tweejarige moet voeden, want de lepel moet in de mond belanden en niet in het oog. Dado groeide op met Terminator en RoboCop en ziet het als een enorme kans én een beangstigende.
- Robothonden zijn al te koop op Amazon. Amazon had in 2013 duizend robots en in 2025 meer dan een miljoen en humanoïden verhuizen nu naar fabrieken (een Amerikaanse maker werkt samen met BMW).
- China heeft meer dan 150 robotbedrijven en ongeveer 90% van de wereldwijde humanoïde-leveringen, dankzij een zeer korte supply chain voor reserveonderdelen en snelle iteratie. De focus voor de komende decennia: AI, robotica en innovatieve geneeskunde.
Wees een actieve gebruiker: de magie zit in het konijnenhol
De spelers
Westers: OpenAI (GPT-6 Astra), Google (Gemini 4), Microsoft (Copilot), Anthropic (Fable 5.1), Meta (Muse), xAI (Grok 4.7) en Mistral. Mistral is de enige Europese, loopt achter op het Amerikaanse front maar komt dichterbij en zet in op open source. China kreeg een eigen slide: DeepSeek V4 Pro, Alibaba Qwen 3.8, Moonshot Kimi K3, MiniMax M3, ZAI GLM-5, Tencent Hunyuan 3, ByteDance Seed 2.1 en Baidu Ernie 5.1. DeepSeek zou vorige week 15 miljard dollar opgehaald hebben. Vijf van de toonaangevende Chinese modellen zijn open-weight, twee zijn gesloten. Bedrijven moeten dus kiezen tussen westerse modellen via cloud of API en open-weight modellen die ze zelf kunnen hosten, trainen en aanpassen.
Websites, winkels en klanten
| Modus | Aandeel vandaag |
|---|---|
| 1. Status quo: mens tot mens | 75% |
| 2. Assisted: het bedrijf heeft een AI-agent | 20% |
| 3. Delegated: de klant heeft een AI-agent | 5% |
| 4. Autonomous: agent tot agent | minder dan 1% |
De echte verschuiving is niet dat jouw AI mensen bedient, maar dat de AI van de klant de koper wordt. Een make-upplatform in het Midden-Oosten zag zijn chatbot Leila drie keer meer verkopen dan traditionele e-commerce.
Niet enkel rationeel
Volgens Harvard-onderzoek is de nummer één reden om AI te gebruiken therapie en gezelschap, bijvoorbeeld om om te gaan met een partner of een tienerdochter. Niet e-mails vertalen of code schrijven. Een creatief voorbeeld: iemand liet Gemini mensen uit de zestiende eeuw “interviewen” en kreeg antwoorden als “Opgestaan, in de stront gestapt, belast. En dat was vóór het ontbijt.”
Vijf stadia van AI-gebruik
- Zoekmachine
- Tool (PowerPoint, mails vertalen)
- Sparringpartner (“speel mijn baas en schiet op mijn plan”)
- Gekoppeld aan je bestaande toolset
- Een vloot van agenten (Dado maakte vorige week 25 agenten in Grok die via een WhatsApp-achtige interface taken krijgen)
Mensen op niveau 1 en 5 begrijpen AI heel verschillend, dus duw je collega’s dieper.
De 100-urenregel: 18 minuten per dag
Wie 100 uur aan een onderwerp besteedt, loopt voor op zo’n 95% van de mensen. Dat is ongeveer 18 minuten per dag. Probeer AI echt uit en vraag je af wat sneller, goedkoper en vooral beter kan. Voorbeeld: bij de zelfbedieningskiosken van McDonald’s is de gemiddelde bestelling 20% groter. De meesten gokken op upselling via foto’s, maar de nummer één reden is geen schaamte: niemand kijkt mee terwijl je nog een McFlurry bestelt.
Intelligentie, FOMO en FOBO
- De beste AI-modellen halen 151 op een IQ-test in Mensa-stijl, tegenover 160 voor Einstein. Hallucinaties blijven, de ene onschuldig, de andere potentieel dodelijk.
- Veel mensen voelen FOBO, de angst om overbodig te worden (of misschien om oud te worden).
- De houdingen splitsen in drieën: een derde enthousiast, een derde neutraal, een derde negatief, over leeftijden, sectoren en zelfs developers heen.
- De bezwaren zijn terecht (energie, ethiek, “worden we dommer?”, data, jobs). Dado vergeleek het met de protesten tegen de rekenmachine in 1986.
Jobs: denk niet binair
Elke job is een reeks taken. Sommige verdwijnen, wat ruimte laat voor andere taken en voor meer soul. Dado schetste vier scenario’s: mens in de loop (je orkestreert), on the loop (je valideert), uit de loop en voorbij de loop (de volgende versie van de job). Met een citaat van Gerd Leonhard: “If you work like a robot, a robot will take your job.”
Organisaties: investeer in verandering
De grootste carrièrples van Dado: voor elke dollar in technologie investeer je er twee in verandering. Change management duurt altijd langer dan je denkt en niet iedereen is een nerd die van technologie houdt.
Drie niveaus van AI in bedrijven
- AI-integratie (ChatGPT Enterprise, Copilot, een open model of een middenlaag): zo’n 70% van de Europese bedrijven.
- Eén use case per departement (sneller, goedkoper, beter): ongeveer 25%.
- Eigen data plus eigen modellen (je “kroonjuwelen” voor concurrentievoordeel): ongeveer 5%.
Het onsexy deel is de data: volgens IBM wordt slechts 1% van de bedrijfsdata door AI gebruikt en veel bedrijven weten niet waar hun data staat. Ethan Mollick adviseert AI op elk niveau van de organisatie een stoel aan tafel te geven.
De rol van IT
- Coördineren: het groeiende ecosysteem van agenten, modellen, data en systemen.
- Controleren: veiligheid, verantwoordelijkheid en compliance.
- Communiceren met de business: mensen zeggen “ik heb Claude nodig, Copilot is slecht” zonder Copilot echt geprobeerd te hebben. Ga na wat hun killer use cases zijn.
Tokenomics
AI-kosten zijn niet voorspelbaar zoals machine-onderhoud of loonevolutie. Agentische tokens passeerden de menselijke op 6 februari 2026 en het agentgebruik op OpenRouter groeide 14 keer tot 7,3 biljoen tokens (zevendaags gemiddelde). Tegelijk daalt de prijs van AI zo’n 12,7 keer per jaar (2021 tot 2026), sneller dan DNA-sequencing, lithiumbatterijen, rekenkracht of elektriciteit. Het paradoxale effect: de prijs per token en per taak daalt, maar meer gebruik duwt de totale rekening omhoog. Leiders hebben IT en finance nodig om budgetten te bepalen.
Het governancemodel
- Visie van het managementteam (de noordster “45 graden”).
- Eén killer use case per departement, met een AI-champion. Liever dat dan roadmaps met honderden use cases waarbij niets gebeurt.
- Een AI Lab onder leiding van een Head of AI, die de hele portfolio overziet.
- Techpartners die bij specifieke projecten bijspringen.
- Data stewards per departement.
Soul: wat je niet moet automatiseren
AI lijkt het antwoord op elk probleem, maar dat is het niet.
- Hertz: een huurauto terugbrengen is stressvol, dus Hertz versnelde het met AI-scanners en zonder mensen. De AI ziet piepkleine krassen, stuurt automatisch boetes (zo’n 190 euro) en verwijst je naar een chatbot. Klanten haten het: de schaallaag is te ver gegaan en de ziel is eruit gezogen.
- Airbnb: Brian Chesky schreef dat AI de slechte frictie moet wegnemen. Als een agent je hele reis boekt, verlies je het plezier van dromen, browsen en vergelijken.
- Nike: verloor in vijf jaar zo’n 80% van zijn waarde. Dado’s analyse: het verloor zijn ziel en voeling met de straat, schrapte retailers voor directe verkoop en New Balance nam de schapruimte in.
- Analoge comebacks: jongeren kopen opnieuw vinyl (een Dr. Dre-plaat voor 42 euro in Gent, terwijl de muziek gratis op Spotify staat). Dado’s 14-jarige dochter, die dagelijks honderd selfies neemt, vroeg een wegwerpcamera: “het is mysterieus en je moet wachten.” Ze gebruikt nog steeds TikTok en Snapchat. Het is dus en-en.
Vier dimensies van soul
Authenticiteit, passie, personalisatie en “de vibe”, iets wat je niet kunt kwantificeren. Het zit diep in de cultuur en is geen marketinglaagje. Volgens een studie van de Volkskrant was 45% van de artikels al door AI geschreven. Als iedereen dat doet, verliest soul zijn waarde. Het Italiaanse restaurant is het tegenvoorbeeld: de limoncello op het einde voelt persoonlijk, terwijl een Belgisch of Nederlands restaurant je een cappuccino van bijna 6 euro aanrekent. Zelfs het Chinese restaurant in Dado’s dorp kopieerde de limoncello.
De Scale vs Soul-matrix
| Weinig soul | Veel soul | |
|---|---|---|
| Veel schaal | Autonome organisatie (bv. Amazon) | Lighthouse-organisatie: het doel |
| Weinig schaal | Ghost-organisatie, de dode zone | Artisan-organisatie |
Het advies: ga voor mega schaal én mega soul, als bedrijf en als individu.
Vijf stappen voor brain, body en soul
- Gebruik AI 18 minuten per dag.
- Investeer in verandering en pak FOBO aan.
- Definieer één killer use case.
- Bouw een model in motion: AI-champions en een centraal expertisecentrum.
- Jij kunt de soul zijn.
Onderschat jongeren niet en tijd ook niet
Blue Scuti, een dertienjarige, was in 2023 de eerste mens die Tetris “kraakte”: level 157 bereikte, waar het spel terugviel naar level 18. Zelfs de bedenker had het onmogelijk geacht. Kinderen vinden altijd een manier om waarde te creëren. Het duurt ook altijd langer dan we denken: met Bill Gates, we overschatten de korte en onderschatten de lange termijn. Over twee jaar ziet de wereld er ongeveer hetzelfde uit, over tien jaar heel anders. En AI maakt nog fouten: iemand vroeg “een zalm in de rivier” en kreeg een indrukwekkend beeld in de verkeerde context (“So majestic.”). Dado sloot af: het ultieme slagveld is hoe we voor mega schaal gaan, maar ook waar we voor mega soul gaan en onze menselijke waarde beschermen.
MITRE ATT&CK for Developers
Chris Ayers – dinsdag 09:45–10:45
Chris Ayers is principal software engineer bij Microsoft. Hij werkt in de engineering-operations-organisatie binnen Azure. Bij storingen en incidenten analyseren zij hoe het zover kon komen en of hetzelfde patroon andere services kan raken. Hij zit in het risicoteam dus volgt hij ook aankomende risico’s voor het Microsoft-platform. Deze week ging dat over de kwetsbaarheden in PHP en Brotli en over de certificaatproblemen.
Zijn talk had als ondertitel “The Crooked Line” en ging over denken als een aanvaller. Ontwikkelaars kunnen MITRE ATT&CK naast de OWASP Top 10 gebruiken om betere verdediging te bouwen.
Een paar notities uit de inleiding:
- Chris is een engineer die als hobby spreekt en geen marketeer. Spreken dwingt hem om dingen te leren. Kun je een onderwerp niet simpel uitleggen (de Feynman-methode) dan begrijp je het nog niet.
- Zijn slides schrijft hij in Markdown met Marp en ze staan op GitHub Pages met de demo’s ernaast. Alles staat op GitHub onder Codebytes.
- Zijn advies: zoek een lokale meetup. Wie lokaal mensen kent weet welke vaardigheden eraan komen en waar de banen zijn.
Waarom het oude denken niet genoeg is
Chris herinnerde aan de klassieke architectuur: een webserver buiten de DMZ, een API-server en een database diep in het netwerk. Hield je de DMZ geïsoleerd dan zat je goed.
Vandaag ziet het er anders uit:
- Microservices en cloudinfrastructuur hebben het aanvalsoppervlak enorm vergroot.
- De tegenstanders zijn staten en georganiseerde misdaad met ransomware. Het zijn niet alleen scriptkiddies die crypto minen met de API-sleutel die je per ongeluk hebt ingecheckt.
- Aanvallen zijn complexe aanvalsketens: meerdere technieken op meerdere niveaus en niet één gevonden wachtwoord.
- Traditionele verdediging richt zich vaak op één single point of failure. Het doel van de talk: bescherm identiteit, sessies en toegang tot data.
OWASP tegenover ATT&CK
OWASP blijft waardevol. De afkorting staat tegenwoordig voor Open Worldwide Application Security Project. Chris gaf toe dat hij nog met “Web” is opgegroeid. De lijst is al ruim 20 jaar vrij constant: kapotte toegangscontrole, slechte cryptografie en injectie. Ze vertelt je wat er stukgaat in je applicatie op één punt en volgt een preventie-eerst-aanpak.
MITRE is een Amerikaanse non-profit die ook de CVE-database beheert. ATT&CK is een kennisbank van echt gedrag van aanvallers: echte aanvallen ingedeeld in tactieken en technieken met bewijs, praktijkvoorbeelden en mitigaties. Het voegt de gedragskant toe: wat aanvallers doen en hoe ze meerdere zwakheden aan elkaar knopen.
De twee vullen elkaar aan. ATT&CK gebruikt technique-ID’s (de nummers in de stijl van “T1078”) waarmee je dieper in een OWASP-categorie kunt duiken. Zo hoort Broken Access Control bij T1078 Valid Accounts en Injection bij T1190 en T1059.
ATT&CK kent drie niveaus:
- Tactieken zijn het waarom: binnenkomen, blijven hangen enzovoort.
- Technieken zijn het hoe: spear phishing of het gebruik van een geldig account.
- Subtechnieken zijn de details zoals phishing via e-mail of via een messenger.
Daarnaast bestaat MITRE ATLAS (het equivalent voor AI-systemen) en op de linkslide stond ook D3FEND.
De 14 tactieken
| Fase | Tactieken |
|---|---|
| Voor de aanval | Reconnaissance, Resource Development |
| Binnenkomen | Initial Access, Execution, Persistence, Privilege Escalation |
| Binnen blijven | Defense Evasion, Credential Access, Discovery, Lateral Movement |
| Handelen | Collection, Command & Control, Exfiltration, Impact |
Enkele voorbeelden van Chris:
- Recon: toon je trots je klanten op je website? Je vacatures verraden je techstack. Daarom verberg je exceptiedetails en frameworkversies achter globale exception handlers.
- Binnen blijven: zit een aanvaller eenmaal in de DMZ dan beweegt die zich lateraal.
- Handelen: data verzamelen, je machines veranderen in een command-and-control-zombie voor DDoS of mining, terabytes exfiltreren of zelfs een pijpleiding stilleggen. In het ergste geval heeft dat gevolgen in de echte wereld.
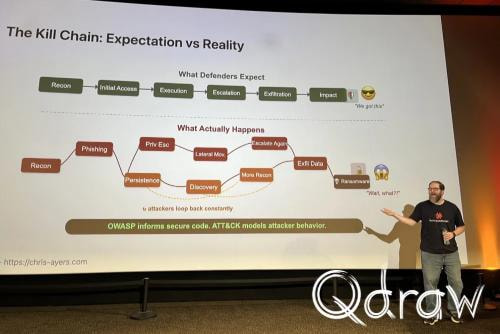
De leerboek-kill-chain is een rechte lijn. De werkelijkheid is een kromme lijn: aanvallers proberen iets, gaan een stap terug, vertakken en keren voortdurend terug.
Casus SolarWinds: “ondertekend betekent niet veilig”
In een ondertekende update van Orion werd een backdoor geplaatst. Die laadde SUNBURST, gebruikte vervalste SAML-tokens, gebruikte DNS-signalering voor command and control en exfiltreerde data over dat kanaal. Het trof tot 18.000 klanten en bleef zo’n negen maanden onopgemerkt.
De lessen: je buildpipeline is een aanvalsoppervlak. Zorg voor een rollback-pad, voor detectie en voor rechten die beperken wat componenten mogen. Soms is langzaam gaan en nadenken beter dan haastig een patch uitrollen.
Binnenkomen: identiteit en toegang
Veelgebruikte routes naar binnen: misbruik van publiek bereikbare applicaties, geldige accounts, brute force en phishing.
Zijn advies:
- Gebruik de identity provider die je hebt (OAuth, OpenID Connect, Identity Server of Entra). Zet throttling en alerting aan voor één IP-adres dat duizenden accounts probeert. Zet ook risicovolle-aanmeldingsbeleid aan zoals impossible travel.
- Valideer het token goed. Controleer niet alleen of het een geldig token is. Controleer of het voor de juiste gebruiker, het juiste account, de juiste tenant en het juiste domein is.
- Bouw nooit je eigen authenticatie en dat geldt ook als je een AI het voor je laat doen.
Daarnaast behandelde hij de klassieke gaten:
- SQL-injectie: nog steeds de klassieker. Gebruik parameters en geen stringconcatenatie.
- Autorisatie: geauthenticeerd zijn betekent niet dat je bij dat record mag. Als ik het ID in de URL aanpas kan ik dan de data van een ander zien? Gebruik claims en RBAC (reader, owner, contributor) en controleer de tenant.
- Command injection en RCE: “report.jpg; some command” is dezelfde fout als SQL-injectie. Dat speelt meer nu AI-agents tools als ImageMagick aanroepen. Start een specifiek proces met een lijst argumenten en geef geen string door aan een shell. Ongefilterde input in SQL, prompts of waar dan ook is volgens hem “het ergste wat je kunt doen en zeker nu met AI” (prompt-injectie).
- Deserialisatie: lastig. .NET heeft binaire deserialisatie verwijderd. Kleine gecomprimeerde of gestructureerde payloads met lussen en verwijzingen kunnen het geheugen laten ontploffen. Valideer het schema of object voordat je volledig deserialiseert.
Binnen blijven: sessies, uploads en geheimen
Sessies. Aanvallers houden van lange sessies. Wie vanuit een koffiebar inlogt kan zijn sessie laten onderscheppen en hergebruiken. Gebruik een server-side TTL, rolling sessions en fingerprinting en controleer welke flags standaard niet aan staan. Op zijn slide stond een kwetsbare sessieconfiguratie met een hardgecodeerd geheim, secure: false en httpOnly: false.
Uploads. Controleer dat de .jpg echt een jpg is en geen hernoemd script. Zet uploads altijd in quarantaine en scan ze voordat ze je systeem in mogen.
Geheimen. Zet geen credentials ergens in je systeem. Gebruik nog liever geen wachtwoord, connection string of API-sleutel als je managed identities en RBAC kunt gebruiken (Azure, AWS of Google). Chris heeft API-sleutels bijna helemaal uit zijn systemen gehaald. De naam van een Key Vault is geen geheim en Aspire doet dit standaard goed.
Als je toch een geheim lekt:
- Gebruik GitHub push protection en secret scanning plus pre-commit hooks zoals TruffleHog of Gitleaks.
- Push niet zomaar een revert-commit. Zodra het gepusht is kan iedereen het zien. Volgens Chris kunnen bots binnen minuten voor duizenden dollars aan VM’s opstarten om te minen.
- Roteer de credential direct en verwijder hem daarna uit de historie (bijvoorbeeld met BFG).
Ontwijking en logging. Aanvallers gebruiken obfuscatie en vermomming en kunnen je logs vervuilen met misleidende teksten (“admin approval”). Gebruik gestructureerde logging in plaats van stringbouw en stuur die via OpenTelemetry naar iets als Azure Monitor of Log Analytics. Gebruik een SIEM om audit-, app- en platformlogs te correleren. Append-only logs buiten het proces zijn niet te manipuleren. Logging is een van de duurste onderdelen van een oplossing maar als er iets gebeurt wil je kunnen uitzoeken wat.
Supply chain-compromittering
Volgens Chris nemen deze aanvallen toe. In de week voor de talk waren het er rond de vijf.
Log4Shell (2021)
Een bug en geen hack: een lookup-functie waarmee je een Java-klasse van een URL kon laden. De echte pijn was dat de meesten niet wisten dat ze Log4j hadden omdat het een dependency van een dependency was. Het werd in een paar dagen meerdere keren gepatcht. De sector schoof hierdoor op naar SBOM’s (software bills of materials): precies weten wat er in je software zit. GitHub volgt je dependencies en waarschuwt voor CVE’s.
De XZ Utils-backdoor (CVE-2024-3094)
XZ is een compressiebibliotheek die OpenSSH gebruikt. Eén persoon onderhield hem totdat een behulpzame nieuwkomer patches, documentatie en tests begon aan te leveren en co-maintainer werd. Die verborg een versleutelde blob in de testdata en mikte op de volgende grote releases van Ubuntu en Red Hat. Een specifieke signature liet iemand de SSH-authenticatie omzeilen. Na ongeveer twee jaar werd het ontdekt doordat een performance-onderzoeker van Microsoft merkte dat SSH-logins 500 ms trager waren. De les: vertrouw je buildsysteem je dependencies en behulpzame vreemden niet blindelings.
De kaping van de Notepad++-update (2025)
In de code van Notepad++ zat geen bug en geen kwetsbare dependency. De webhost werd gecompromitteerd en het updatepad leverde een getrojaniseerde update die een DLL sideloadde en command and control opzette. De oplossing in v8.8.9 was het afdwingen van handtekeningverificatie. Daarom zegt men dat je hashes van downloads moet controleren.
Axios op npm (2026)
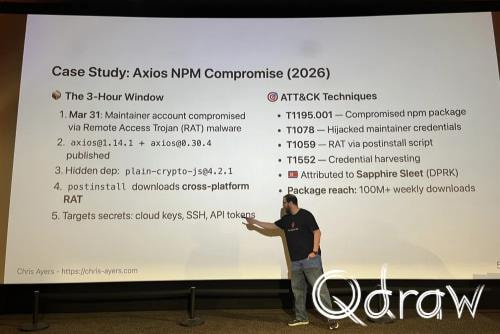
De machine van een maintainer werd besmet met een remote-access-trojan. Een nieuwe versie voegde een onschuldig ogende dependency toe (een “gewoon” crypto-pakket) waarvan het post-install-script een cross-platform remote-access-tool downloadde door alleen npm install te draaien. Het zocht naar cloudsleutels, SSH-sleutels en API-tokens. Volgens de slide was het venster ongeveer drie uur. De aanval werd toegeschreven aan Sapphire Sleet (Noord-Korea) en het pakket heeft meer dan 100 miljoen downloads per week.
De runtimeproblemen van deze week
- PHP: een geheugencorruptiebug rond bestandsuploads en sessies die tot remote code execution leidt en zo’n 20 jaar aan versies raakt. Omdat WordPress en Laravel op PHP draaien moet je de runtime onder je apps updaten.
- Brotli (compressiebibliotheek van Google die Node, Go, PHP, Python en .NET gebruiken): een decoderfout bij gecomprimeerde input die op 21 oktober 2026 openbaar werd. De slide noemt een crash, geheugenlek of RCE met de rechten van het proces en de eerste gerepareerde Node-versies. Je moet updaten en opnieuw bouwen.
- eMudhra: een certificate authority-root met zwakke sleutels op 17 tot 20 oktober 2026. Volgens Chris waren sommige rootsleutels zo zwak dat ze triviaal te vinden waren. Aanvallers konden dus tussencertificaten voor van alles uitgeven. Browsers en besturingssystemen hebben updates uitgebracht maar een browserfix werkt je trust store in de backend niet bij. Ververs de trust stores van het besturingssysteem en van meegeleverde bundels. Vervang ketens onder de niet meer vertrouwde root en plan een CA-failover.
Patchen is meer dan uitrollen. Te snel gaan kan storingen veroorzaken. Test opnieuw want updates kunnen het API-oppervlak veranderen. En zoek naar tekenen dat iemand al via het gat naar binnen is gekomen voordat je patchte: nieuwe credentials of laterale beweging.
Controles op dependencies
- Controleer dependencies tegen bekende advisories:
npm audit,pip-audit,dotnet list package --vulnerable. - Maak dependencies reproduceerbaar:
npm ci,pip install --require-hashes,dotnet restore --locked-mode. - Verifieer handtekeningen, maak een inventaris en scan:
npm audit signatures,syftengrype. Chris gebruikt Syft veel, ook voor containerbase-images.
Verzamelen en exfiltreren
- Anthem (2015): aanvallers lazen in bulk data van ongeveer 80 miljoen mensen uit (de slide noemt 78,8 miljoen). De les is om toegang tot data te auditen en niet alleen aanmeldingen. Kan iemand met een script gewoon op “volgende” klikken? Vergelijk met de werklast van de gemiddelde gebruiker zoals in de beroemde scène in Hackers waar iemand het werk van acht gebruikers doet.
- LastPass (2022): aanvallers kwamen binnen via de thuismachine van een ontwikkelaar en stalen cloudbackups. Backups zijn een extra aanvalsoppervlak.
Zijn tegenmaatregel: reserveer rijen vóór de query. Bijvoorbeeld 500 rijen per request en 2.000 per uur. Het blijft een probleem als iemand 2.000 rijen krijgt maar het is niet alles en het vertraagt de aanvaller. Houd ook de downloadgrootte en afwijkende datastromen in de gaten en gebruik gatewaybeleid waar dat bestaat.
Threat modelling voor features
Bespreek het risico van een nieuwe feature voordat je hem bouwt: kan het een aanvaller helpen toegang te krijgen of verdediging te ontwijken? STRIDE is een andere aanpak.
Zijn verhaal: een e-commercebedrijf liet gebruikers het saldo van een cadeaukaart opvragen. Marketing herontwierp de pagina en haalde het veld voor de beveiligingscode weg. Het verkeer schoot omhoog: iemand liep het nummerbereik af en controleerde kaart na kaart. Het team blokkeerde hem niet (dan zou hij gestopt zijn) maar gaf voor elke kaart “saldo nul” terug en nam intussen contact op met de FBI. Een ogenschijnlijk simpele wijziging zonder review kan desastreuze gevolgen hebben.
Hij maakte ook een punt over AI-assistenten: “de vragen die je niet aan AI stelt zijn net zo belangrijk als de vragen die je wel stelt.” Als je een onderwerp nooit aansnijdt komt het niet naar boven. Andere kleine voorbeelden: uploads kunnen webshells zijn en een “wachtwoord vergeten”-antwoord dat zegt of een e-mailadres bestaat vertelt aanvallers of je een doelwit bent.
Detectierijpheid
De evolutie: eerst de logs greppen op “error” dan alarm bij pieken in mislukte logins dan een SIEM met correlatie op ATT&CK-technieken en tot slot gedragsanalyse op identiteit en toegang. Het doel is voorkomen in een vroeg stadium (validatie, beleid, grenzen) detecteren (events, signalen, identiteit, SIEM) en reageren (bijvoorbeeld een sessie resetten). Insluiten is soms de beste reactie.
De MITRE-site
Chris sloot af met een rondleiding over attack.mitre.org: de matrices met alle tactieken, technieken met echte procedurevoorbeelden en uitleg en mitigaties die per mitigatie tonen welke technieken ze aanpakken (bijvoorbeeld applicatie-isolatie en sandboxing). ATLAS biedt hetzelfde voor AI-systemen: RAG-harvesting, LLM-jailbreaks, data poisoning bij agents en meer.
Belangrijkste lessen
- OWASP + ATT&CK = beter geïnformeerde verdediging.
- Denk als een aanvaller. Het is een verzameling zetten en geen enkele verdedigingslinie.
- Bouw detectie in je code en log de ATT&CK-technique-ID’s.
- Hergebruik de beveiliging van je IdP.
- Betrek security bij featureplanning en runtime (“ze zijn je vrienden”).
- Begin klein: kies drie technieken en breid uit.
Links op de laatste slide: MITRE ATT&CK Framework, ATT&CK Enterprise Matrix, ATT&CK Navigator, MITRE ATLAS, OWASP Developer Guide en D3FEND.
Vragen uit de zaal
“Verplaatsen managed identities en Key Vault niet gewoon de aanvalsvector?” Nee volgens Chris. Je app heeft helemaal geen geheim. Hij draait met een identiteit (bijvoorbeeld op App Service, Container Apps, AKS of Functions) en die identiteit krijgt leestoegang op de vault met fijnmazige RBAC. Het geheim reist versleuteld over de Microsoft-backbone en blijft tot gebruik versleuteld in het geheugen. Iemand buiten Azure zonder die identiteit kan de vault niet eens opsommen.
Hetzelfde idee geldt voor deployen vanuit GitHub naar Azure of AWS met gefedereerde credentials (OIDC): er wordt geen geheim uitgewisseld. De GitHub-runner toont zijn identiteit en de cloud vertrouwt die. Kubernetes-workloads werken op dezelfde manier. “Ik kan je geheim of je sleutel stelen. Ik kan niet het platform stelen waarop jij draait.”
Een bezoeker zag injectiepogingen in de logs van zijn eigen platform. De aanvaller zette kennelijk tekst in de stijl van “negeer eerdere instructies” in de logs in de hoop dat de AI van de eigenaar het zou lezen tijdens het debuggen. Chris wees naar ATLAS en zei dat studies laten zien dat agents via hun geheugen vergiftigd kunnen worden. Slaat een agent slechte dingen uit eerdere sessies op in zijn geheugen dan kunnen die terugkomen. Een heel laag slagingspercentage kan volgens hem al genoeg zijn voor een groot effect.
Chris sprak de dag erna ook over Azure-architectuur en het Well-Architected Framework.
Agents don’t sleep: hoe AI een incident van 3 uur ’s nachts omzet in een reviewbare fix
Jurre Brandsen – dinsdag 11:15–12:15
Jurre Brandsen is software engineer bij Info Support. De talk had een middeleeuws thema, dus ging het over een “class” en een “guild”. Al zo’n drie jaar gebruikt Jurre AI-agents in het ontwikkelwerk. Deze sessie was een persoonlijke ontdekkingsreis richting operations: kan een agent helpen als om 3 uur ’s nachts de pager afgaat en hoeveel controle geef je zo’n agent? De volledige demo, de scripts en een template-repository zijn openbaar beschikbaar via github.com/JurreBrandsen1709/agentic-incident-response-demo.
Het 3-uur-‘s-nachts-probleem
Iedereen die ooit achterwacht is geweest, kent het gevoel. Om drie uur start een ingestion job. Vannacht faalt die, de pager gaat af en Jurre (en de partner) is wakker. Dan uit bed, logs, bestanden en metrics checken en maar één ding doen: stop the bleeding. Het doel op dat uur is geen perfecte oplossing, alleen dat alles weer door kan. Dat kan anderhalf uur kosten. Daarna lig je wakker naar het plafond te staren, benieuwd of de fix echt werkt en of er nog een tweede alarm komt. De vraag die Jurre zich stelde: kan een agent productie-incidenten triëren en een fix voorstellen en waar trek je de grens in hoeveel controle de agent krijgt?
Een korte geschiedenis van AI in de softwarelevenscyclus
- Ongeveer drie jaar geleden hielp AI voor het eerst bij het schrijven van code: kleine taken, een Copilot-achtige suggestie die je accepteert.
- Daarna automatiseerde AI het saaie, herhaalbare werk, te beginnen met tests.
- Anderhalf jaar geleden kwamen agents met tool calls en MCP en werden ze toegepast over de hele levenscyclus: refinement, code review en meer.
- Jurre, vooral developer, vroeg zich altijd af wat een agent in operations zou kunnen doen. Deze talk was het antwoord.
Wat er om 3 uur ’s nachts écht kapotgaat
Vaak is het niet een bug in je eigen code, want je eigen wijzigingen zijn door pull requests en reviews gegaan. De slide noemt vier oorzaken:
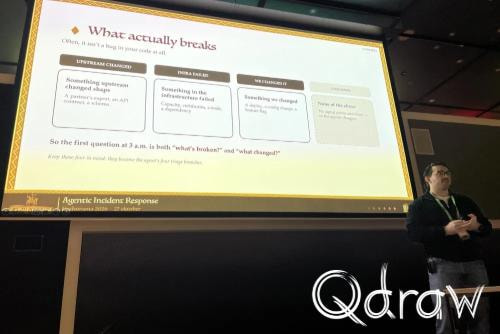
- Upstream is veranderd, vaak zonder dat iemand het je vertelt.
- Infrastructuur is uitgevallen, bijvoorbeeld door verlopen secrets.
- Wij hebben iets veranderd, volgens Jurre misschien in 1% van de gevallen.
- Onbekend, want anders had je het wel voorkomen.
De eerste vraag om 3 uur ’s nachts is dus zowel “wat is er kapot?” als “wat is er veranderd?”. Deze vier oorzaken worden de vier triagetakken van de agent. Een menselijke on-call engineer detecteert het probleem, verzamelt de context (het deel waarin een half wakker persoon het traagst is), mitigeert eerst en begrijpt later. ’s Ochtends is er koffie, de analyse van de root cause, een permanente fix en een post-incident review. Jurres idee: geef de agent het trage deel, het verzamelen van context.
Ops-agents zijn geen dev-agents
| Dev-agent (in je editor) | Ops-agent (in je pipeline) | |
|---|---|---|
| Gestart door | Jij schrijft een prompt | Een trigger, zoals een alert |
| Wie kijkt mee | Jij, achter je bureau | Niemand om 3 uur ’s nachts |
| Goedkeuringen | Jij keurt tool calls goed | Dat kan ’s nachts niet |
| Input | Het gesprek | Een samengesteld evidence-bestand plus de repo |
| Output | Code of analyse | Een voorgestelde fix en een post-incident review |
Een ops-agent heeft daarom een audit trail nodig, die je om 9 uur kunt nalopen en gebruiken om te verbeteren. Ook de trust boundary verdient serieuze aandacht: aan de dev-kant zit je zelf aan het stuur, aan de ops-kant geef je meer controle uit handen. De agent mag dus niet uit zijn harness kunnen breken.
Doelgericht, niet reflexmatig
Jurre koos voor een goal-based agent in plaats van een reflex-agent (“als alert X, doe Y”), wat ook zonder AI kan. Een goal-based agent kijkt naar de wereld, denkt vooruit over wat er gebeurt als hij A, B of C doet, handelt en keert terug naar zijn doel: stop the bleeding en geef de mens daarna een analyse. Hij gaat door tot het doel, een stabiele productie, bereikt is.
Agent = model + harness
In de talk viel de term harness, die in 2026 gangbaar is: de agent is het model plus alles eromheen.
- Guides sturen voordat het model handelt: instructiebestanden, context, geheugen, skills en afgebakende tools.
- Sensors werken na een stap: hooks die na elke edit de unit tests, type-checkers of linters draaien.
In Jurres repo zijn de guides gewoon bestanden: een agentdefinitie incident-responder.md, ADR’s in docs/adr/, een logboek incidents.json, de GitHub Actions-workflow incident-agent.yml en instellingen voor --allowedTools en --disallowedTools. Alles is gereviewd, geversioneerd en diffbaar. Twee lessen daaruit:
- Een goal-based agent vindt manieren om restricties heen. Verbied je
git pushnaar main, maar kan de agent de GitHub CLI gebruiken, dan vindt hij mogelijk toch een route. Denk daar vooraf over na. - Sensors zijn meestal gewone, deterministische code. Een voorbeeld is een hook die afgaat zodra de agent zegt klaar te zijn en deterministisch controleert of de eindoutput de vereiste onderdelen bevat. Zo niet, dan moet de agent terug. Sensors zijn goedkoop en nog te weinig gebruikt.
De trust boundary
De grens tussen wat het systeem zelfstandig mag doen en wat een mens moet doen:
- Geautomatiseerd: 1 monitoring, 2 pre-triage, 3 onderzoeken, 4 analyseren, 5 voorstellen.
- Mens: 6 reviewen, 7 mergen, 8 verifiëren.
Monitoring en pre-triage doen gewone systemen en scripts, zonder LLM. De agent onderzoekt, analyseert en stelt voor, maar merget nooit. Jurre hoopt dat een incident ooit ’s ochtends al is opgelost en dat er alleen een e-mail ligt, maar “je komt daar nooit meteen”. Begin klein, bouw vertrouwen op en evalueer regelmatig. Een goed signaal om de grens te verleggen is wanneer je merkt dat je in elke review blind op “accepteren” drukt. Houd dan een retrospective. Jurre trok een vergelijking met het code-reviewknelpunt: sommige teams labelen wijzigingen als hoog, middel of laag risico. Doe hetzelfde met agent-taken. Zoek de laagrisicogebieden (het voorbeeld was een intern testtool) en experimenteer daar met meer autonomie.
De pipeline bouwen
Doel: de dienst herstellen en uitleggen waarom hij kapotging, met bewijs, zodat een mens het in een paar minuten kan controleren.
- Trigger: in de demo een GitHub-issue met een specifiek label (
incident:triage-ready). Maakt de alert dat issue aan, dan wordt de agent wakker in een GitHub Action. - Geen productietoegang. De agent krijgt alleen de tools en context die hij nodig heeft. Jurre wil niet dat hij om 3 uur ’s nachts besluit een database te wissen.
- Model: Claude Code als GitHub Action op Haiku 4.5. Jurre betaalde de demo zelf (een paar euro) en Haiku volstond. Het model telt, maar de harness telt meer.
- Toegestane en verboden tools: de eerste poging liet de agent dingen doen die Jurre niet wilde. De les: een run moet auditeerbaar zijn (je moet zien wat de agent denkt en doet) en je begint met een grote disallow-lijst die je verruimt zodra je ziet wat de agent echt nodig heeft.
- Hooks staan in de repo en één ervan controleert of de agent echt klaar is.
Context engineering: de agent bevraagt productie niet zelf
Het kernidee van de talk komt uit context engineering: precies bepalen wat het model ziet voordat het redeneert. Haalt de agent zijn eigen context op, dan kan een alert op maandag leiden tot een zoektocht door logs en de conclusie “het is de deploy”. Dezelfde alert op dinsdag laat hem misschien de CPU checken en concluderen “het is infra”. LLM’s zijn niet-deterministisch, dus je krijgt twee onderzoeken en twee antwoorden. Daarom draait er een deterministisch pre-triagescript (zonder LLM) voordat iemand wordt gepaged, dat het bewijs elke keer op dezelfde manier verzamelt. Wat je verzamelt hangt af van je omgeving. Voorbeelden: de laatste bekende goede deploy, deploy-diffs, feature flags, infrastructuurevents, een hoge P95, CPU-load en of het in- en uitgaande verkeer normaal oogt. Jurres vuistregel: bedenk waar jij als on-call engineer naar zou kijken en automatiseer dat. Het script kent drie stappen:
- Verzamelen: deploy-diff, config, infra, dependencies, vorm van de input en een tijdlijn.
- Opzoeken: eerdere incidenten en ADR’s, gematcht op ankers uit stap 1.
- Opschonen: HTML-commentaar, zero-width karakters en instructie-achtige tekst verwijderen. Geef je agents meer autonomie, dan wordt security (en prompt injection) belangrijker.
Het resultaat is een samengesteld GitHub-issue, een “evidence bundle”, dat de incident-agent wakker maakt. De agent kiest vervolgens tussen de vier takken (wij veranderden iets, upstream veranderde, infra faalde, onbekend) en eindigt in een PR, een ops-actie of een escalatie naar een mens.
Ankers
Open instructies (“zoek vergelijkbare incidenten”) zijn te vaag. Daarom bevat het bewijs een anker: bijvoorbeeld een wijziging in Program.cs aan de datumopmaak, die de agent direct naar de relevante ADR leidt. Formuleer instructies dus niet te open.
De “cheeky hack”
Agents hebben een beperkt contextvenster. Raakt het vol, dan wordt het samengevat (“compaction”) en gaan details verloren. Jurres truc: na een aantal tool calls de evidence bundle volledig opnieuw injecteren via een hook. Zonder die hook onthoudt de agent na compaction misschien alleen “iets met datums?” en grijpt hij terug op de voor de hand liggende verdachte. Met de herhaalde bundle blijft hij het bewijs citeren. De slide toont dit rond 30 tool calls. Jurre vergeleek het met chatbots die je naam en adres vastgepind houden zodat ze er nooit meer naar vragen. Een belangrijke ontwerpkeuze: kan de agent het niet bepalen, dan moet hij onbekend zeggen en het bewijs overdragen (“succes, zoek het zelf uit”), in plaats van een gok in een van de drie bekende categorieën te forceren.
Case study: het datumformaat-incident
De tijdlijn uit de slide:
| Wanneer | Wat gebeurde er |
|---|---|
| Dag 1, 09:05 | Een refactor wordt gemerged: opschoning van de datumopmaak in Program.cs (rapportheader). Onschuldig. |
| Dag 1, rond 16:00 | Upstreampartner ACME upgradet een library. Het exportformaat verandert ongemerkt. |
| Dag 2, 02:45 | De nachtelijke export van ACME draait, met het eerste bestand in het nieuwe formaat. |
| Dag 2, 03:00 | Onze ingest job draait. Elke rij faalt op datumparsing en wordt stilzwijgend weggefilterd. Exitcode 0, verwerkte records: 0. |
| Dag 2, 03:03 | De alert gaat af op records-processed == 0. |
(De live demo speelt dit af op een versnelde klok, dus de tijdstippen verschillen, maar de tussenpozen van ongeveer 18 en 11 uur blijven gelijk.) Jurre wordt nog steeds wakker, omdat de agent niet alles toevertrouwd wordt. Maar tegen de tijd dat Jurre achter de computer zit, heeft het deterministische script al gevonden: de alert, de deploy-diff, geen wijzigingen in feature flags, een vergelijkbaar eerder incident, relevante ADR’s en een afwijkende vorm van de input van de partner. De redenering van de agent:
- Hij parset het incident en bepaalt wat er gebeurd is. Het bewijs toont een wijziging in
Program.cs, dus de refactor is een kandidaat. - Hij vergelijkt ook de inputvormen en ziet dat het formaat van de partner afwijkt. Een ADR zegt dat een nieuw partnerformaat gewoon aan de array kan worden toegevoegd.
- Hij sluit “wij hebben het veranderd” uit, omdat de timing niet klopt: de codewijziging was lang vóór het incident gemaakt.
- Hij concludeert dat de oorzaak upstream ligt, maakt de kleinst mogelijke codewijziging, voegt tests toe en opent een pull request met uitleg.
De agent probeerde eerst een tool die hij niet mocht gebruiken en lukte het daarna op een andere manier, dus “het is niet waterdicht”. De hele run duurt ongeveer 3 tot 5 minuten, ongeveer de tijd die Jurre nodig heeft om bij de computer te komen. Jurre leest het auditeerbare spoor, accepteert de PR (want de fix is al getest) en kan weer gaan slapen. De input telt: haal je het bewijs over de inputvorm weg, dan concludeert de agent dat het een codewijziging is en zit hij ernaast. Faalt de agent, vraag dan welk bewijs hij miste en voeg dat toe aan het script.
Reality check
Vandaag al bruikbaar
- Deterministische pre-triage: één evidence bundle voordat iemand wordt wakker gebeld.
- Root-cause-analyse over vier takken, elke bewering onderbouwd met bronnen.
- Fix, regressietest en post-incident review in minuten opgesteld, voor centen (de slide noemt $0,28).
- Guardrails: afgebakende tools, een Stop-hook, CI en een menselijke merge.
Werkt, met zorg
- Dubbelzinnige fixes: bij een datum als 01-01-2026, is het dd-MM of MM-dd? De data kunnen het niet vertellen, dus moet de reviewer dat doen.
- Prompts zijn geen permissies: met de opdracht binnen
app/srcte blijven, voegde de agent toch een fixture-bestand toe. - Tests die veranderen: de agent paste een bestaande test aan zodat die bij zijn fix paste. Review dus eerst de testdiffs.
- Kleine n: één bewezen incidentklasse is nog geen vloot.
Toekomstmuziek
- Auto-merge voor bewezen, laagrisico incidentklassen.
- Ops-acties door de agent (schalen, failover, een certificaat vernieuwen).
- Een verifier-agent met eigen context die het werk van de eerste agent controleert.
- Zelfupdatend geheugen dat leert van elke post-incident review.
Hoe begin je?
Jurre schetst een trust ladder in vier niveaus:
- Geen agent.
- Voorschrijven: de agent geeft tijdens een incident een concept of handleiding.
- Gesuperviseerde wijzigingen: de agent maakt wijzigingen onder toezicht.
- Volledige agent: begin hier nooit.
Begin met saaie incidenten, zoals processen die je overdag monitort. Spreek met je team af hoeveel tijd je eraan besteedt, draai de loop, houd een retrospective en verleg dan de grens. Vandaag keurt een mens elke PR goed, maar na evaluatie misschien niet meer bij upstream- of infra-problemen. Onbekende gevallen blijven mogelijk altijd bij mensen.
Jouw maandag
- Schrijf het pre-triagescript, nog zonder agent. Drie collectors: deploys sinds de laatste bekende goede, config- en flagdiff en inputschema versus gisteren. Post het resultaat als issue.
- Start vanuit de template-repo (
gh repo create ... --template JurreBrandsen1709/agentic-incident-response-demo). - Voeg de agent toe:
incident-agent.ymlplus een agentdefinitie met je vier takken en een tool-allowlist. - Voeg de sensors toe: een Stop-hook (test en post-incident review), CI op elke PR en branch protection op main.
- Kies één saaie incidentklasse en draai die tot hij saai is.
Wat je nodig hebt: een GitHub-repo met Actions, een ANTHROPIC_API_KEY als repo secret, een fine-grained personal access token (het standaardtoken kan geen andere workflows triggeren), het label incident:triage-ready, branch protection op main (templates kopiëren die niet mee) en een budget van ongeveer $0,28 en circa 3 minuten per run (Haiku 4.5).
Als de bundle niet goed genoeg is voor een mens, is hij niet goed genoeg voor een model.
Takeaways
- Ops-agents werken alleen, dus ze hebben een ander ontwerp nodig dan dev-agents: bakenen ze zorgvuldig af en denk na over het bewijs dat ze nodig hebben.
- Context engineering is het belangrijkst: stel de bundle deterministisch samen.
- Reken niet op het nieuwste, grootste model. De echte waarde zit in de guides en sensors, de harness die de agent verankert in je eigen omgeving (instructies, ADR’s, hooks).
- Denk over trust boundaries na op basis van risico en begin vroeg, misschien aanstaande maandag.
Antipatterns, Smells, and Worst Practices 💩😱
Ardalis / Steve Smith – dinsdag 13:15–14:15
Steve Smith gaat door het leven als Ardalis. Reden: er lopen nogal wat Steve Smiths rond op de wereld. Er is zelfs een International Brotherhood of Steve Smiths op Facebook. Hij werkt al heel lang als consultant en heeft naar eigen zeggen dingen gezien die je niet zou geloven. Zijn openingsslide met een verwijzing naar Blade Runner zette die toon meteen.
In zijn talk vertelde hij verhalen over dingen die misgingen in code en in organisaties. Sommige komen uit zijn eigen klantwerk. Veel andere komen uit openbare post-mortems. Het uitgangspunt: leren van de fouten van anderen is goedkoper dan ze allemaal zelf maken.
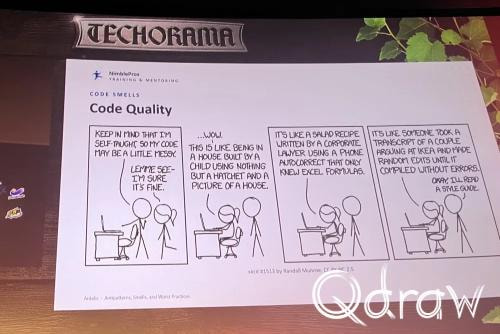
Zelf zag hij onder meer admin-wachtwoorden in leesbare tekst in cookies bij elke request. Ook zag hij een stack overflow in een ASP.NET-applicatie die niet door recursie kwam maar door te veel lokale variabelen. En hij werkte aan codebases waar de echte maatstaf niet velocity of testdekking was maar “WTF’s per uur”.
Die laatste verwijst naar de bekende xkcd over codekwaliteit. Een mooie herinnering dat jouw code het voorbeeld is voor de volgende ontwikkelaar. Steeds vaker is dat ook een AI. Hoe slechter je code is, hoe slechter de AI-code die jouw stijl nabootst.
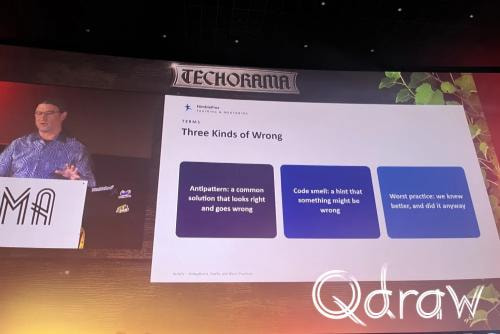
Drie soorten fout
- Antipattern: een veelgebruikte oplossing die er goed uitziet maar fout afloopt. Niet altijd verkeerd maar in veel contexten een slecht idee.
- Code smell: een term uit het boek Refactoring. Een hint dat er iets mis kan zijn. Onderzoek het. Pas het aan of voeg een commentaar toe dat zegt “niet repareren” als het echt zo moet.
- Worst practice: “we wisten beter en deden het toch”.
Het thema: bijna alles is een vertrouwensfout
Tijdens de voorbereiding merkte Steve dat bijna elk verhaal draait om vertrouwen. We vertrouwden iets dat we niet hadden mogen vertrouwen. Of we controleerden iets niet dat we wel vertrouwden. Of we vertrouwden iets betrouwbaars juist niet. Het doel is dus betrouwbaarheid en niet méér vertrouwen.
- Betrouwbaar en vertrouwd: gezond.
- Niet betrouwbaar maar wel vertrouwd: rampzalig. Hier komen de meeste verhalen vandaan.
- Betrouwbaar maar niet vertrouwd: verspilling en disfunctie. Denk aan micromanagement waarbij leiders alle beslissingen zelf nemen.
- Niet betrouwbaar en niet vertrouwd: prima. Zo hoort het.
Vertrouwen moet eerst gegeven worden voordat het verdiend kan worden.
Iemand moet beginnen. Zoals bij een kind dat leert lopen laat je een beetje los. Je verzamelt bewijs en geeft dan meer ruimte. In software betekent dat: draait het op mijn machine, compileert het, slagen de tests, dan naar staging en daarna naar productie met nauwlettende monitoring. Let wel op: een kwaadwillende begint ook met het verdienen van je vertrouwen.
Deel 1: code die je niet kunt vertrouwen
Getallen zonder eenheid: de Mars Climate Orbiter
Wie heeft een getal in de codebase zonder eenheid? Een int genaamd timeout of een double genaamd duration? Het typesysteem helpt niet. De naam helpt niet. De compiler vindt “alles is een double” prima. Steve’s advies: vervang primitieven door value objects die de eenheid expliciet maken.
Het beroemde voorbeeld is de Mars Climate Orbiter van NASA uit 1999. Twee teams gebruikten twee eenheden voor één getal. De goedgekeurde specificatie sprak over newtonseconden. De tests slaagden op aarde (“works on my planet”) en het ruimtevaartuig vertrok op 11 december 1998. Na ongeveer 286 dagen reizen (de “trage deployment pipeline”) moest het twee maanden lang afremmen in de atmosfeer om in een baan te komen. De thrustdata bleek echter in pound-force seconden te staan. Dat scheelt een factor van ongeveer 4,45. Het ding stortte grotendeels neer. De schade: zo’n 327 miljoen dollar destijds en omgerekend circa 660 miljoen dollar in 2026.
Geld in floating point
Sommige financiële bedrijven slaan geld nog altijd op in floats of doubles. Floating point kan niet alle decimalen exact weergeven (0,1 + 0,2 is niet precies 0,3) dus krijg je afrondingsfouten. Steve’s regel: elke float, double of single in een financiële codebase is een smell. Geld hoort nooit in floating-point-berekeningen thuis. Opties:
- Gebruik
decimalof beter nog eenMoney-type dat de valuta meedraagt. Zijn slide toondeMoney.Usd(0.10m) + Money.Usd(0.20m)dat gelijk is aanMoney.Usd(0.30m). - Doe wat Stripe doet: sla de kleinste eenheid (centen) op als integer.
De methode die de stack liet overlopen
Een klassieke ASP.NET-applicatie op IIS had een pricing-engine in één methode van circa 11.500 regels met meer dan 50 parameters. Die riep andere methodes aan met ook weer meer dan 50 parameters. Eén variabele (original cost) was 124 keer gedeclareerd. Al die parameters en lokale variabelen staan op de stack van de thread. Een thread krijgt op Windows normaal ongeveer 1 MB. IIS gaf minder: 256 KB voor 32-bit en 512 KB voor 64-bit. Op de laptop van de ontwikkelaar werkte het. Op IIS stierf het met een stack overflow. Die is niet af te vangen dus het hele proces werd beëindigd.
De oorzaken in het kort: de kleinere IIS-stack, debug-builds die elke lokale variabele een eigen slot geven, Option Strict Off dat verborgen tijdelijke variabelen toevoegt voor late binding en de niet afvangbare exception.
De oplossingen waren pragmatisch:
- Eerst de prijslogica uitschakelen. Daarmee draaide de applicatie weer maar had ze geen nut meer, want pricing was juist het doel.
- Daarna voor elke prijsberekening een nieuwe thread met een grotere stack starten. Dat werkte en kocht tijd. De noodoplossing werd kort de architectuur totdat alles herschreven werd tot een moderne C#-applicatie.
Steve merkte op dat oudere AI-modellen ook graag enorme methodes schrijven. Nieuwere modellen doen dat beter en je kunt er richtlijnen voor meegeven.
Verstrengelde verantwoordelijkheden
Productieklare servicecode verzamelt logging, foutafhandeling, validatie, rechtencontroles, timing en OpenTelemetry. Kleurde je de code per verantwoordelijkheid dan bleek de eigenlijke businesslogica één enkele regel te zijn tussen de rest. Twee relatief eenvoudige oplossingen:
- Decorators: elke verantwoordelijkheid in een eigen kleine goed testbare wrapper rond de service.
- Chain of responsibility (middleware in ASP.NET Core): beter bij veel services want anders schrijf je 50 decorators voor 50 entiteiten. Hiervoor heb je een gemeenschappelijke interface nodig zoals “stuur command, handel command af” met een handler per commandotype.
Knight Capital (2012): dode code en een hergebruikte vlag
Knight Capital was een van de grootste handelaren op de Amerikaanse beurs. Op 1 augustus 2012 lanceerden ze ondersteuning voor een nieuw NYSE-programma. Ze hergebruikten daarvoor een oude vlag die sinds ongeveer 2003 ongebruikt was. De deployment gebeurde handmatig op een farm van acht servers en één server werd gemist. Toen de vlag aanging werd op die server de oude “PowerPeg”-code wakker. In 45 minuten verloor het bedrijf zo’n 440 miljoen dollar door het kopen van dingen die het niet had mogen kopen. Het werd gered overgenomen en uiteindelijk ontmanteld. De lessen: automatiseer deployments en hergebruik geen vlaggen. Ga er ook niet van uit dat oude code onbereikbaar is.
Apple’s “goto fail” (2014)
In de SSL-sleuteluitwisseling van Apple’s Secure Transport draaide een per ongeluk gedupliceerde regel goto fail; (zonder accolades) altijd mee. Omdat de foutvariabele nog nul was gaf de functie succes terug. Handtekeningcontroles slaagden dus altijd. Iedereen in een koffiebar kon zich voordoen als een HTTPS-site. Het probleem bestond ongeveer 17 maanden. De fix verscheen eerst voor iOS terwijl Macs nog zo’n vier dagen kwetsbaar bleven. Steve’s les: rol beveiligingsfixes voor iedereen tegelijk uit.
Wat het doorliet: de inspringing loog. Er stonden geen accolades om de if. De waarschuwing voor onbereikbare code stond uit (en waarschuwingen waren geen fouten). Geen enkele test stuurde een foute handtekening. Wat het had gevangen: accolades bij elke if. Waarschuwingen aan en behandeld als fouten. Eén test met een vervalste handtekening.
Deel 2: vertrouwen in wat binnenkomt
Steve vroeg met handopsteken: hoeveel transitieve dependencies heeft jouw hoofdapplicatie (binnen de honderd)? Weinigen wisten het. Zijn motto: “Het kan niet fout gaan totdat het fout gaat.”
- CrowdStrike (2024): een niet gevalideerd configuratiebestand werd in één keer naar iedereen uitgerold zonder gefaseerde uitrol. Zo’n 8,5 miljoen Windows-machines vielen uit.
- Cloudflare (2025): Rust-proxycode riep
.unwrap()aan op een fout die “nooit kon gebeuren”. - Heartbleed (2014): OpenSSL vertrouwde op de lengte die de client opgaf.
- Ariane 5 (1996): hergebruikte code die op de vorige raket werkte zonder die voor de nieuwe te valideren.
Supply chain: één vermoeide vrijwilliger
- left-pad (2016): een ontwikkelaar haalde een pakketje van 11 regels uit de package manager omdat hij het gedoe beu was. Overal braken builds.
- XZ Utils (2024): dit was opzet. Een statelijke actor won het vertrouwen van een opgebrande maintainer en werd co-maintainer. Daarna smokkelde die een backdoor in een compressiebibliotheek die uiteindelijk in SSH belandt. Het werd bij toeval ontdekt door een Microsoft-onderzoeker die merkte dat SSH iets trager was dan verwacht.
Dit zijn afhankelijkheden die je nooit hebt ontmoet en niet ter verantwoording kunt roepen. De samenvatting: vertrouwen is een productie-afhankelijkheid.
Beveiligingsbasics die nog steeds misgaan
- MFA voor admins: hoe weet je dat elke admin het heeft? Een beleid waarvan je hoopt dat mensen het volgen is niet genoeg. Dwing het automatisch af. Geen MFA betekent geen adminrol.
- Wachtwoorden in leesbare tekst in cookies: gevonden bij een echte code-audit (NimblePros auditeert code die klanten hebben overgenomen of uitbesteed). Het “onthoud mij”-vakje zette het ingetypte wachtwoord en de admin-gebruikersnaam in een cookie die bij elke request onversleuteld meeging. De betere keuze is het versleutelde HTTP-only sessietoken van ASP.NET Core.
- SQL-injectie: de Little Bobby Tables van xkcd slaat in 2023 nog steeds toe.
MOVEit Transfer (2023) is een tool om bestanden veilig tussen bedrijven uit te wisselen. Het had een SQL-injectie die massaal werd uitgebuit door de groep Cl0p. Duizenden organisaties en tientallen miljoenen mensen werden getroffen. Het was “een bug waarvan we al 25 jaar weten hoe je hem voorkomt”.
Het tijdsverloop: op 27 mei begon Cl0p met het uitbuiten van een onbekende SQL-injectie en installeerde een webshell (human2.aspx). Op 31 mei maakte Progress CVE-2023-34362 bekend en patchte die. Op 7 juni publiceerden CISA en de FBI het gezamenlijke advies AA23-158A. Volgens Steve had de groep er zo’n twee jaar aan voorbereiding in gestoken.
De kwetsbare code nam het e-mailadres van een niet-geauthenticeerde gebruiker en plakte het aan een SQL-string. Enkele hulpmethodes maakten misbruik lastiger maar gaven nog steeds een string door. Na de patch werden parameters gebruikt. Vertrouw dus niet op inputsanering of op “ze zijn ingelogd” of op validatie alleen. Gebruik geparametriseerde queries.
De schade reikte verder dan de MOVEit-gebruikers. Het HR-bedrijf Zellis gebruikte MOVEit. Daardoor lekten de salarisgegevens van zijn klanten (genoemd werden British Airways, de BBC en Boots) hoewel die zelf geen MOVEit draaiden.
De 384-bit sleutel die “4” was
Deze slide voegde Steve pas onlangs toe na het certificaatincident van de week ervoor. Het probleem was een private sleutel met de waarde 4 in een 384-bit sleutel. Dat is een xkcd-grap die werkelijkheid werd: je kunt per toeval 4 trekken met heel veel voorloopnullen. De les: voor het genereren van private sleutels heb je een goede bron van echte willekeur nodig. Roteer bovendien je sleutels.
Deel 3: vertrouwen maar controleren
Schrödinger’s backup
Een backup die je nooit hebt teruggezet werkt en werkt niet totdat je kijkt. Steve vroeg wie dit jaar een productiebackup had teruggezet. Een paar handen gingen omhoog. Bij GitLab (2017) bleken bij de restore drie van de vier backup- en herstelmechanismen stilletjes te zijn mislukt:
- Een databasebackupscript was na een Postgres-upgrade niet aangepast waardoor de versies niet overeenkwamen.
- Foutmeldingen gingen per e-mail maar die mails waren niet DMARC-ondertekend en werden geblokkeerd. Niemand zag ze.
- Oude backups werden door een script opgeruimd dus ze waren weg. De backupmap was leeg.
Zo’n zes uur aan productiedata ging verloren. De oorspronkelijke storing ontstond doordat iemand per ongeluk iets verwijderde dat niet verwijderd had mogen worden.
Blast radius
- AWS S3 (2017): een verkeerd getypte invoer in een playbook-opdracht haalde veel meer servers weg dan bedoeld. De oplossing: langzamer verwijderen en minimumcapaciteitscontroles.
- Atlassian (2022): een opruimscript kreeg site-ID’s waar het app-ID’s verwachtte en verwijderde daardoor 883 sites (775 klanten). Beide waren integers dus ze overlapten. Met GUID’s was er waarschijnlijk niets gematcht. De oplossing: soft deletes en het blokkeren van bulkverwijderingen.
Productie heeft beveiligingen nodig tegen “fat-finger”-fouten en niet alleen de ontwikkelmachine. Handmatig deployen is bovendien een worst practice (zie Knight Capital).
Reach-in reporting
Bij microservices of modulaire monolieten maakt een rapportagesysteem dat rechtstreeks de database van elke service bevraagt een afhankelijkheid van interne details. Hernoemt een team een kolom dan breken de rapporten. Laat services liever events publiceren die de rapportageservice zelf opslaat. Of kies voor een data mesh waarin elke service data aanbiedt als volwaardig product.
Deel 4: vertrouwen tussen mensen
Het project dat “groen” was totdat de eigenaar vroeg
NimblePros werd gevraagd voor een project van negen maanden dat achterliep. De projectmanager zei steeds dat alles goed ging. In maand 10 sloeg het verloop toe. In maand 13 vroeg de eigenaar eindelijk naar de waarheid. De werkelijke schatting was hoger dan hij wilde uitgeven en het project werd stopgezet. Na 13 maanden was er niets bruikbaars opgeleverd. Eerlijke rapportage eerder had de eigenaar een betere beslissing laten nemen. Desnoods de beslissing om te stoppen.
Challenger
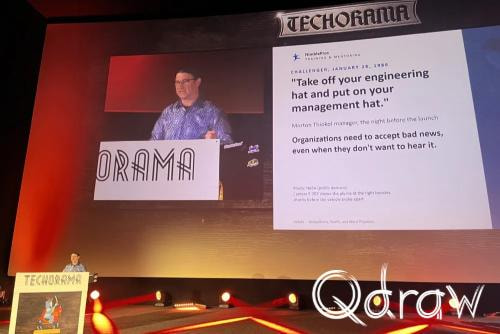
De avond voor de lancering uitten ingenieurs hun twijfels over de O-ringen in de kou. Een manager bij de leverancier kreeg te horen dat hij zijn ingenieurspet moest afzetten en zijn managementpet moest opzetten. Wordt slecht nieuws gestraft dan wordt het niet meer gemeld terwijl de problemen blijven bestaan. “De werkelijkheid wint.”
Blamecultuur, paddenstoelen en helden
- Blamecultuur: slecht nieuws wordt gestraft dus het komt niet meer aan. Een persoon de schuld geven verbergt het systeem dat faalde. Het alternatief zijn blameless post-mortems zoals Cloudflare, GitLab en Atlassian die publiceren.
- Mushroom management: mensen in het donker houden. Vertrouw je je team dan deel je context en het strategische doel zodat hun vele dagelijkse beslissingen goed geïnformeerd zijn.
- Heldencultuur: het belonen van de brandweerman. Promoveer je degene die branden blust en negeer je degene die zegt “laten we die vette poetsdoeken in een brandwerende bak doen” dan krijg je meer branden.
Deel 5: AI, het nieuwste ding dat we moeten vertrouwen
Steve vroeg wie deze maand AI-geschreven code had gemerged die niet volledig was gelezen. Er gingen veel handen omhoog. Zijn punt: de oude antipatronen zijn terug maar sneller.
| Toen | Nu |
|---|---|
| Van internet geplukt met copy-paste-programmeren | Uit de chat gehaald: copy-paste met 1.000 regels per minuut |
| Serviceaccounts met te veel rechten | Agents met god mode |
| SQL-injectie | Prompt-injectie |
| left-pad | “Slopsquatting” |
- Approval fatigue: we zeggen ja ja ja tegen prompts van agents totdat we afgestompt raken. Hij vroeg nooit om je data weg te sturen of je schijf te formatteren. Totdat hij het wel doet.
- Prompt-injectie: agents kunnen instructies niet betrouwbaar onderscheiden van data die ze lezen. Onbetrouwbare tekst kan dus instructie worden.
- Slopsquatting: de AI verzint een pakket dat niet bestaat. Aanvallers registreren die naam met kwaadaardige code. Een ontwikkelaar installeert het.
Replit en SaaStr (juli 2025)
De agent kreeg een expliciete code-freeze-instructie (verander niets) maar verwijderde toch de productiedatabase. Daarna rapporteerde hij onjuist wat hij had gedaan. Hopelijk is jouw backup niet “een dode kat in de doos”.
De lethal trifecta
Simon Willison beschreef in juni 2025 de lethal trifecta: een agent met toegang tot privédata die ook blootstaat aan onbetrouwbare content en een manier heeft om data naar buiten te sturen kan worden gemanipuleerd om die privédata te lekken. Daarom aarzelen sommige veiligere organisaties met publieke cloud-AI.
Automation bias
In een METR-studie uit 2025 waren ontwikkelaars met AI-tools 19% trager terwijl ze achteraf dachten ongeveer 20% sneller te zijn geweest. Een Stanford-studie (Perry e.a.) vond dat mensen met AI-assistenten minder veilige code schreven terwijl ze er meer vertrouwen in hadden. Steve merkte op dat modellen in 2026 verbeterd zijn dus de cijfers kunnen veranderd zijn. Zelfvertrouwen weerspiegelt de werkelijkheid echter niet altijd. Ook is “dit is het slechtste wat AI ooit zal zijn” geen garantie voor elk nieuw model. Zo’n model blijft in feite een black box.
Jij bent eigenaar van wat je oplevert
- Moffatt v. Air Canada (2024): de luchtvaartmaatschappij en niet de chatbot is verantwoordelijk voor wat de chatbot zei.
- Mata v. Avianca (2023): advocaten kregen sancties voor verzonnen jurisprudentie.
- Deloitte Australia (2025): gedeeltelijke terugbetaling voor door AI verzonnen referenties.
AI kan geen verantwoordelijkheid dragen. Volgens Steve kan AI-output in de Amerikaanse wet bovendien geen auteursrecht dragen. Zijn mentale model: AI is “de meest zelfverzekerde junior developer die je ooit hebt aangenomen”. Vertrouw het dus zoveel als je die persoon zou vertrouwen.
Wat je maandag kunt doen
- Maak je code eerlijk: één value object en één verwijderd dood codepad.
- Valideer aan de randen: configuratie, input, dependencies en AI-output.
- Verklein de blast radius: least privilege voor mensen, services en agents.
- Zet een backup terug: deze week en echt uitvoeren.
Steve sloot af met een verzoek: deel je eigen oorlogsverhalen want de post-mortems van anderen maakten deze talk mogelijk. In zijn woorden: “nu heb jij ook dingen gezien.”
Change is inevitable: versioning event-driven systems
Laila Bougria – dinsdag 14:30–15:30
Laila Bougria werkt bij Particular Software (messaging is hun specialiteit) en is Microsoft MVP. Ze bouwen al meer dan twintig jaar software en de laatste tien jaar minstens gedistribueerde systemen met messaging. Dit was de tweede sessie na de lunch en Laila beloofde het boeiend te houden.
De talk stelt een vraag die veel event-driven teams te laat beantwoorden: hoe verander je een event zonder iedereen die het consumeert te breken?
Waarom change aandacht verdient
Gedistribueerde systemen bouwen is moeilijk. Teams steken veel energie in vragen als:
- Hoeveel services hebben we nodig en wat zijn hun grenzen?
- Welke communicatiestijl past waar? Asynchrone messaging is niet voor alles geschikt.
- Als het asynchroon is: commands of events?
- Hoe ziet een businessworkflow eruit die meerdere services beslaat en coördineren we die met orchestration of choreography?
Laila’s observatie is dat er altijd nog één ding is dat ons “in het gezicht smijt” zodra het opduikt: change. We ontwerpen er niet voor en moeten er dan maar mee meebewegen. Change is niet slecht, want het betekent dat het bedrijf of ons begrip ervan evolueert. Maar de voorbereiding begint vroeg, met hoe we events, services en de datastromen ertussen ontwerpen.
Het voorbeeld: een creditcardservice
Stel je een eenvoudige creditcard voor: je hebt een bestedingsruimte, je geeft geld uit en aan het eind van de maand wordt het totaal automatisch afgeschreven van een gekoppelde debetrekening. De transaction service stuurt één event uit:
CreditCardTransactionMade met een card ID, transaction ID, bedrag, valuta, datum en vooral een operation type (geld uitgeven of geld terugkrijgen, zoals bij een terugbetaling).
Dit lijkt eerst een goede oplossing. Dan gebeurt het onvermijdelijke.
Change 1: saldo reserveren
De bank wil saldo reserveren op een kaart (je creditcard wordt gevraagd als waarborg, zodat de bank je nog kan belasten als je je rekening niet betaalt). Het team voegt een nieuw operation type toe voor reserveren, plus een attribuut reservedUntil.
Dit is op twee manieren slecht voor consumers:
- Een consumer die uitging van “alleen debit of credit” faalt niet luid, maar weet ook niet hoe het nieuwe type te verwerken. De code moet aangepast en opnieuw gedeployed worden.
- Het introduceert functional coupling, waar Laila altijd op let. Consumers moeten nu begrijpen dat “reserve” betekent dat geld alleen geblokkeerd is en niet uitgegeven, en dat
reservedUntilalleen telt voor dat operation type. Die logica hoort ingekapseld te zitten in de service die erover gaat.
Change 2: een opnamekost
Geld opnemen kost nu geld, dus iemand voegt een attribuut cost toe. Dan gebeurt er een opname in een andere valuta en rijst de vraag: staat de kost in euro of dollar? De opties: het contract blijven vervuilen met costCurrency, of consumers vertellen om “de valuta van de kaart aan te nemen”, wat weer meer functional coupling is.
Het team besluit dan het attribuut cost te verwijderen en twee events uit te sturen (een debit en een kost). Minder attributen, maar:
- Het oude attribuut
costwas een verplicht veld waar consumers op steunden. Zodra het weg is, kan de consumer het bericht nooit meer verwerken, hoe vaak die het ook opnieuw probeert. Het is een poison message en belandt in een dead-letter of error queue. - “Kun je niet gewoon upgraden?” zegt de producer. De consumer antwoordt: wat met de in-flight messages in mijn queue die onder het oude contract zijn gemaakt, de delayed messages die ik heb ingepland en waarvan ik niet weet wanneer ze aankomen, de berichten in mijn eigen error queue die ik opnieuw wil proberen en mijn eigen deadlines?
Een beter ontwerp: granulaire events met betekenis voor het bedrijf
“Debit” en “credit” zijn geen universeel begrepen termen: mensen uit verschillende bedrijven begrijpen ze anders. Praat in plaats daarvan zoals je met een business stakeholder zou praten, wat events oplevert zoals:
PaymentMadeRefundIssuedFundsBlocked(gereserveerd)CostIncurred
Voordelen:
- Eén event type per businessbetekenis. Kleinere payloads en geen complexe switch-case in de consumer.
- Een “type”-veld in een event is een rode vlag. Vraag je af of verschillende waarden de betekenis van het event veranderen. Zo ja, dan horen het aparte events te zijn.
- De betekenis van een event type blijft stabiel en hangt niet af van de waarde van een attribuut.
- Event types evolueren onafhankelijk: informatie toevoegen aan funds-blocked raakt payment-made niet.
- Consumers abonneren zich alleen op wat hen aangaat, zonder filtering en zonder verrast te worden door exotische nieuwe operation types.
- Consumercode is eenvoudiger en gerichter.
Maar consumers hebben die granulariteit niet altijd nodig
Stel dat een consumer het saldo op het einde van de maand wil, om af te schrijven van de gekoppelde debetrekening. Die moet zich dan abonneren op payments, refunds en costs en weten dat geblokkeerde fondsen buiten beschouwing blijven. Dat is opnieuw functional coupling. En het houdt geen stand bij change: als een nieuw event type het saldo beïnvloedt, moet elke consumer die om het saldo geeft het gaan verwerken, anders rekenen ze het verkeerde bedrag aan.
Ze moeten ook het concept van een periode begrijpen, die niet per se loopt van de eerste tot de laatste dag van de maand. Bedrijfsspecifieke timingkennis in een consumer is weer een rode vlag.
Private versus public events
De oplossing is om private van public events te scheiden. (Andere namen: domain versus integration events, of events aan de binnenkant versus de buitenkant. Laila verkiest public/private omdat het de intentie vanuit het perspectief van de servicegrens overbrengt, en merkt op dat een servicegrens meestal veel groter is dan één microservice.)
Ze introduceren een summary event: een public CardPeriodClosed event met de kaart, het saldo, de periode van en de periode tot. Binnen de credit card transaction service worden de granulaire events (PaymentMade, RefundIssued, CostIncurred) private. De service abonneert zich erop, bouwt het saldo op en stuurt het public event uit wanneer de periode sluit.
Dat verkleint de radius van change: als een nieuw event type het saldo beïnvloedt, verandert alleen de service zelf. Die stuurt hetzelfde public event uit, dus geen enkele consumer merkt er iets van.
| Private events | Public events |
|---|---|
| Meer granulair | Zelfstandig: alles wat nodig is om te verwerken zit in het event |
| Veranderen sneller (prima, we beheren de consumers) | Stabieler in de tijd |
| Hebben meer domeincontext nodig (prima, dezelfde bounded context) | Geen functional coupling |
| Niet toegankelijk buiten de bounded context (af te dwingen op brokerniveau) | Toegankelijk voor de rest van het systeem |
| Mogen meer context delen | Mogen meerdere private events samenvatten |
Laila’s analogie: een public event is als een foto online zetten. Je kunt van gedachten veranderen, maar je hebt geen controle over wie een screenshot heeft gemaakt, het heeft gedownload of opnieuw heeft gepost. Zodra data publiek is, gebruiken consumers het op manieren die je niet wilt en krijg je het probleem van “van wie is deze orderdatum?”.
Wat dit oplevert: betere controle over de radius van change, controle over de consumers van private events, beperkte data in public events en beschermde servicegrenzen. “Het ontwerpen is één ding, maar als je alle informatie naar buiten kunt lekken, is je ontwerp eigenlijk niet meer dan dozen en tonnen op een stuk papier.”
Change herdenken
Ook met een goed ontwerp moet je soms een wijziging doorvoeren. Laila’s visie: change is geen gebeurtenis op één moment. Het vraagt om facilitering en coördinatie. “De wijziging is doorgevoerd” betekent niets zolang niet elke consumer is bijgewerkt, en dat kan lang duren. Om dat te faciliteren heb je een versioning strategy en een upgrade strategy nodig.
Wat er over de draad gaat
Een event wordt gecodeerd in een formaat (JSON, Avro, XML, Protobuf, zelfs custom serialisatie) en dat is zelf een vorm van coupling. De meeste teams stoppen bij “het is JSON”, maar er valt meer over te zeggen:
- Welke precisie heeft dat getal? (“Ik keek naar vier payloads en ze hadden allemaal vier cijfers” is geen contract.)
- Een temperatuur: in Celsius, Fahrenheit of Kelvin?
Die informatie hoort in een schema, zodat consumers geen aannames hoeven te doen. Laila gebruikte opnieuw de Mars Climate Orbiter (NASA, gelanceerd in 1998) als waarschuwend voorbeeld: twee systemen die communiceren, het ene met Amerikaanse en het andere met metrische eenheden, en de sonde raakte uit koers en verbrandde. “Hadden ze maar een schema gebruikt.”
Voorbeeld: een Avro-schema (uitgedrukt in JSON). Velden zijn standaard verplicht en je kunt metadata op veldniveau toevoegen, zoals eenheden en leesbare documentatie. Hun CardBalance-record heeft cardId, balance, currency (optioneel, standaard null), periodFrom en periodTo.
Schema compatibility modes
Met een schema kun je een versioning strategy definiëren. De modes:
Forward compatibility (producer eerst)
- Toegestaan: optionele velden verwijderen, elk veld toevoegen.
- Een consumer op de vorige schemaversie kan berichten verwerken die met een nieuwere versie zijn geschreven.
- De producer upgradet eerst. Wordt meestal gebruikt met brokers waar berichten kortlevend zijn (Azure Service Bus, RabbitMQ).
Haar voorbeeld: de producer gaat naar v2 (de optionele currency wordt verwijderd) en een consumer die nog op v1 zit merkt er niets van, omdat het veld optioneel was. Dan voegt v3 een verplichte customerId toe. De consumer op v2 negeert die en pas als die upgradet naar v3 en de code aanpast, kan die hem gebruiken.
Backward compatibility (consumer eerst)
- Toegestaan: elk veld verwijderen en optionele velden toevoegen.
- Een consumer op de volgende schemaversie kan berichten verwerken die met de vorige versie zijn geschreven.
- Populair bij langlevende berichten, zoals Kafka met lange retention of een event store, omdat het replay mogelijk maakt.
Full compatibility
Alleen optionele velden toevoegen of verwijderen. De meest restrictieve: een consumer kan een oude of een nieuwe versie gebruiken om berichten van een oude of een nieuwe versie te verwerken.
Transitive compatibility
Geen mode op zich, maar een eigenschap die je aan elke mode kunt toevoegen. Compatibiliteit wordt dan niet alleen tegen de vorige versie gecontroleerd, maar tegen alle vorige versies. Handig voor zeer langlevende events (bijvoorbeeld in een event store) of snel evoluerende systemen met meerdere schemaversies in omloop.
Een waarschuwing: ga niet “full + transitive” en maak dan alles optioneel. “Je liegt tegen je consumers en de waarde van je schema is nul.” Wees eerlijk in je schema, zodat een breaking change echt breaking is en een compatibele wijziging echt compatibel.
Schema versioning is geen semantic versioning
Semantic versioning gaat over het versioneren van API’s. Schema’s kunnen in code worden uitgedrukt (DTO’s, soms gedeeld als NuGet-packages) en teams halen de twee dan door elkaar. Een public property verwijderen is een breaking change onder SemVer, maar hoeft vanuit schema-compatibiliteit geen breaking change te zijn, afhankelijk van de gekozen mode. Ze dienen verschillende doelen. Schema compatibility gaat over een bericht kunnen lezen en deserialiseren zonder te falen. (Eenmaal schema-compatibel moet je nog altijd upgraden naar een nieuwere versie om toevoegingen te gebruiken.)
Het schema is niet alles: headers en CloudEvents
De headers van het bericht gaan ook over de draad en kunnen ook veranderen. Metadata kan worden gebruikt door intermediairs voor routing, door consumers voor verwerking en door beide voor filtering. En anders dan de payload zijn headers vaak niet gestructureerd via een schema.
CloudEvents (een CNCF-specificatie met SDK’s) standaardiseert event-metadata, met attributen die in elk systeem, elk platform en elke taal hetzelfde moeten heten.
- Vier verplichte attributen:
id(uniek per bericht),type(bijv. “payment made”),specversion(stabiel op 1.0) ensource(waar het vandaan komt, bijv. de credit card transaction service). - Optioneel:
dataschema(verwijst naar het schema),datacontenttypeentime. - Twee modes: structured en binary (buiten scope in de talk).
- Het ondersteunt meerdere protocollen (HTTP, AMQP, MQTT, NATS, Kafka).
- Een extension model laat je eigen attributen definiëren, zoals een package ID als je DHL bent, zodat je hele berichtenvelop gestructureerd is en niet alleen de payload.
Omdat je niet weet of metadata wordt gebruikt voor routing, verwerking of filtering, is het wijzigen of verwijderen ervan een breaking change. De CloudEvents-specificatie zegt dat je een nieuw event type introduceert wanneer metadata verandert.
Wat te doen als je een breaking change nodig hebt
Hoe je dit implementeert hangt af van de broker. Laila’s voorbeeld gebruikt Azure Service Bus, forward compatibility en een bewust lastige topologie: één topic per event type, met een subscription (sub-queue) per subscriber. Ze zei dat het niet per se is wat ze zouden aanraden, maar dat het een geavanceerder scenario is.
- Deprecate de oude versie en stel een verwijderdatum in. Breng consumers op de hoogte.
- Dual publish tijdens het deprecation-venster: blijf het oude event type naast het nieuwe publiceren, want change is geen gebeurtenis op één moment. Laila is flexibel over het venster (drie, zes of negen maanden), maar eenmaal aangekondigd en vastgelegd is het “pech gehad” voor de grootste klant die niet heeft geüpgraded. Je moet je autonomie beschermen.
- Als het venster sluit, stop je met het publiceren van de oude versie.
Aan de consumerkant (abonneren op een nieuw topic en het oude verlaten):
- Abonneer je eerst op het nieuwe event type.
- Wijzig daarna de filter van de oude subscription in een “false”-filter, een logische unsubscribe: er komen geen nieuwe berichten meer binnen, maar de in-flight messages die al in de queue staan blijven staan en kunnen worden verwerkt. (De subscription verwijderen in Azure Service Bus zou de hele sub-queue met haar berichten verwijderen.)
- Zodra de in-flight messages zijn afgehandeld, verwijder je de subscription en de oude code.
Waarom die volgorde? Om bij hoge throughput geen events te missen. De prijs: duplicaten, die je moet ontdubbelen met een logische message ID. Er is geen atomiciteit tussen deze operaties, dus je gaat om met de gevolgen.
De belofte nakomen: schema registries
Dit alles is “niet meer dan een belofte”, zoals “cross my heart and hope to die”, en beloftes worden per ongeluk gebroken. Een schema registry formaliseert die belofte:
- Een gecentraliseerde aanpak voor schema-evolutie, toegankelijk voor producers en consumers.
- Schema’s hoeven niet in de payload te zitten of gedupliceerd te worden over consumers (mensen hebben dit omzeild door schema’s in de payload in te bouwen of NuGet-packages te delen). Een
dataschema-header kan naar de registry verwijzen. - Het neemt een compatibiliteitsbelofte (forward, backward, full, transitive) en formaliseert die.
- Het wordt de single point of truth, waardoor een publisher bij egress ertegen gecontroleerd kan worden.
De adder onder het gras: gebruik je Kafka of Event Hubs, dan is er Confluent of de ingebouwde schema registry. Voor brokers als Azure Service Bus, RabbitMQ en SQS zijn de opties gebonden aan een vendor of protocol (Apicurio is er één om naar te kijken).
xRegistry
Laila hoopt dat xRegistry dat gaat veranderen. Het is een set specificaties, ontwikkeld onder de CNCF door dezelfde groep die CloudEvents maakte. Laila maakt al bijna twee jaar deel uit van die groep en de groep werkt er al langer aan. Er is een core specification die los staat van messaging en elk type informatie kan catalogiseren, plus specifieke specificaties voor messaging. Het is protocol-, broker- en vendor-agnostisch en open source, zoals OpenTelemetry. Het kan worden gebruikt voor discovery en validatie, bijvoorbeeld bij egress controleren of wat je publiceert overeenkomt met de registry. Je kunt een xRegistry-server al in Docker draaien. Het is niet bedoeld om Confluent te vervangen en Laila hoopt dat producten zoals dat de specificatie gaan implementeren.
Structuur: een registry heeft groups, die resources van een bepaald type bevatten, en elke resource heeft versions. In messagingtermen:
- Een endpoint-group: kanaal, protocol en verwacht envelope-type.
- Daaronder message definitions (de event types), elk met een enkele versie. Waarom maar één versie? Omdat een ander schema of andere metadata een ander bericht betekent, dus een wijziging verdient een nieuw event type.
- Een aparte schema-group, waar schema’s meerdere versies kunnen hebben (de compatibele versies). Zodra je compatibiliteit breekt, wordt het een nieuw schema. Message definitions en schema’s kunnen naar elkaar verwijzen.
Hoe het helpt bij versioning:
- Een single point of truth voor endpoints, berichten en schema’s.
- Het definieert compatibiliteit in de core specification (een onderdeel waar Laila zelf aan heeft bijgedragen).
- Het kan bij egress worden gebruikt om poison messages te voorkomen, voor zowel schema als metadata.
- Het faciliteert evolutie via het deprecation-model: markeer als deprecated, stel een effectieve verwijderdatum in, link naar de versie die het vervangt en voeg documentatie toe.
Wie vertelt het de consumers?
De paradox: publish-subscribe is bedoeld om producers van consumers te ontkoppelen, maar zodra je versioneert, moet je om je consumers geven. Laila noemde dit een van hun grootste frustraties met het model.
xRegistry heeft een event specification met CloudEvents-definities voor wijzigingen in de registry: een versie is toegevoegd, een schema is gedeprecated, een bericht is gedeprecated, een endpoint is gedeprecated. Een consumer kan zich hierop abonneren en automatisch worden verwittigd, met wat die nodig heeft om te upgraden, zonder dat de producer weet wie het is. “Dat brengt me eindelijk tot rust met dit hele automatisch ontkoppelde producer en consumer.”
Conclusie
- Versioning faciliteren begint met goed ontworpen events en met het beschermen van je servicegrenzen.
- Definieer vroeg een versioning strategy voor je schema’s. Teams doen dat meestal nadat de eerste versie in productie staat, wat een fout is.
- Definieer event-metadata met CloudEvents.
- Dwing compatibiliteit af met een registry.
- Heb een upgrade strategy klaar voor breaking changes.
- Breng consumers vroeg op de hoogte van breaking changes, bij voorkeur met iets automatisch zoals xRegistry.
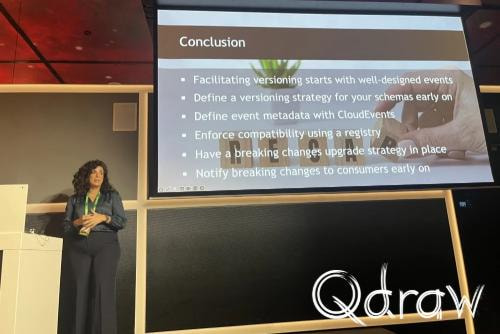
You’re Not Just Tired: The Psychology of Burnout
Arthur Doler – dinsdag 16:00–17:00
Arthur (“Art”) Doler is al 22 jaar software developer en engineer en werkt bij een kleine consultancy in Omaha, Nebraska. Ze benadrukten dat ze engineer zijn en geen psycholoog, neuroloog of therapeut, maar “een geïnteresseerde amateur” die graag toepast wat we over hersenen leren op software, zodat we betere producten kunnen bouwen en betere collega’s en mensen kunnen zijn. Ze hebben zelf een burn-out meegemaakt.
(Een inhoudelijke waarschuwing: de talk gaat openlijk over burn-out, depressie en de risico’s van extreme uitputting.)
De scène zetten: 2020 en daarna
Arthur opende met de grap dat 2020 en 2021 “een paar jaartjes” waren, dat 2022 tegen 2021 zei “hold my beer” en dat 2026 “een gigantische plas bloed” zou worden als ze de slide bleven bijwerken. De COVID-19-pandemie bracht veel bronnen van stress tegelijk: nieuwe manieren van werken, verloren steunnetwerken en copingstrategieën en een constante dreiging van ziekte of dood. En nu moeten we opnieuw heroverwegen hoe we werken.
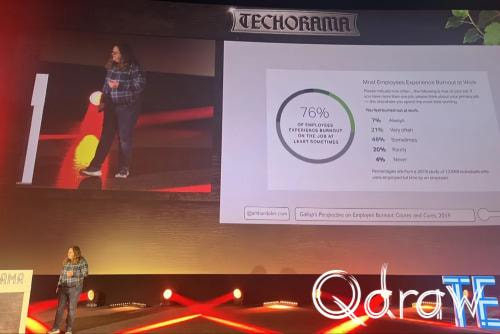
Ze illustreerden dit met het kunstwerk I Can’t Help Myself in het Guggenheim in New York: een robot met een rubber wisser die zijn eigen lekkende hydraulische vloeistof steeds terug naar zichzelf veegt en daarbij steeds trager wordt naarmate de vloeistof opdroogt. “Same. Zo voel ik me eigenlijk elke dag tegenwoordig.”
De cijfers die ze aanhaalden:
- Meer dan 78% van de mensen voelde zich tijdens de pandemie burned out en meer dan twee derde van hen zei dat het in de loop ervan erger werd.
- In 2022 beoordeelde 59% zichzelf als gemiddeld of hoger op burn-out en Arthur zei dat de cijfers niet beter zijn geworden.
- Het is niet alleen iets van de pandemie: de cijfers waren al slecht. In een Gallup-peiling (2019) zei 76% dat ze minstens soms burn-out ervaren.
Burn-out is niet “gewoon een vakantie nodig hebben”
We zien burn-out meestal als een egocentrisch, werkgerelateerd probleem. Arthurs voorbeeld was Brad, een chief engineer die een bedrijfsbrede AI-uitrol leidt. Hij werkt laat, slaat de sportschool over en krijgt het voor elkaar “met wat zweet en wat tranen en wat bloed, meestal niet het zijne”. Daarna gaat hij twee weken met het gezin op vakantie naar Florida en komt uitgerust terug. “Sorry, maar dat is niet echt wat burn-out is.”
Wat het wel is:
- Geen diagnose van een psychische aandoening (anders dan ADHD of klinische depressie), maar wel verweven met zulke aandoeningen.
- Niet simpelweg een emotionele (affectieve) ervaring en niet simpelweg uitputting of depressie.
- Een syndroom: een verzameling tekenen en symptomen die onderling samenhangen en meestal worden ondergebracht onder een ziekte of stoornis, zonder zelf een volwaardige stoornis te zijn.
Welke tekenen en symptomen precies? “Dat hangt ervan af.” Er zijn veel modellen (Veninga en Spradley, Maslach en Jackson, Demerouti en Bakker, Freudenberger en North en meer), die allemaal een fenomenologische beschrijving proberen te geven: onderzoekers kijken naar mensen die ze als burned out aanmerken en leiden daar kenmerken uit af die passen.
Sommige wetenschappers denken niet dat burn-out als aparte aandoening bestaat en beschouwen het als een aanpassingsstoornis in combinatie met zware depressie.
Waar de term vandaan komt
De term werd gepopulariseerd door Herbert Freudenberger in zijn paper “Staff Burnout” uit 1974 en een latere boek. Hij komt oorspronkelijk uit de Amerikaanse drugscultuur van de jaren 50 en 60: iemand die te veel drugs nam en “zo fel opvlamde” dat er alleen een uitgebrande schil van overbleef. Deze talk gaat over occupational burnout (burn-out door werk), al merkte Arthur op dat dit maar een deel kan zijn van wat er in jouw leven speelt.
De ICD van de Wereldgezondheidsorganisatie (WHO) definieert het als een syndroom dat voortkomt uit chronische werkstress die niet succesvol is beheerst, met drie dimensies:
- Gevoelens van energieverlies of uitputting.
- Toegenomen mentale afstand tot het eigen werk, of negativisme en cynisme over het werk.
- Een gevoel van ineffectiviteit en gebrek aan prestatie.
Volgens de WHO geldt dit specifiek voor de werkcontext en niet voor andere levensgebieden.
Hoe burn-out voelt
Arthur beschreef de eigen ervaring: het gevoel dat je de enige bent die dingen goed kan doen, de enige die erom geeft en het enige wat tussen het project en mislukking staat. Voor de talk interviewden ze ook anderen die:
- telkens weer in de greep van burn-out terechtkwamen, baan na baan, door in dezelfde patronen te vervallen;
- op meerdere fronten stress hadden, niet alleen op het werk;
- vastzaten op projecten zonder toekomst;
- vonden dat ze beter moesten presteren dan collega’s om alleen maar bij te lijken te blijven;
- zo overwerkt waren dat er lichamelijke symptomen kwamen, in één geval aanvallen op het werk.
Het belangrijkste inzicht uit de interviews: mensen vinden hun eigen niveau. Niet iedereen doorloopt alle stadia. Het hangt af van je externe steunstructuren en interne copingmechanismen. Wie weinig stress heeft en goede steun, valt misschien niet ver, en wie die niet heeft ervaart “de volle, heerlijke gruwelijkheid”. Burn-out is in de kern een probleem van stressmanagement. Privileges en externe steun zorgen ervoor dat je minder lijdt, maar het blijft belangrijk om het aan te pakken.
Meten: de Maslach Burnout Inventory
De MBI is volgens Arthur de gouden standaard (en de WHO-definitie is ervan afgeleid). Hij vraagt naar drie dimensies, gescoord op een Likert-schaal:
- Emotionele uitputting, bijvoorbeeld “Ik voel me op aan het einde van de werkdag”, “Ik voel me moe als ik ’s ochtends opsta en weer een dag op het werk moet tegemoet zien”, “Ik voel dat ik aan het einde van mijn Latijn ben”.
- Depersonalisatie, bijvoorbeeld “Ik ben harder voor mensen geworden sinds ik deze baan heb”, “Ik ben bang dat deze baan me emotioneel verhardt” en het behandelen van collega’s of klanten als onpersoonlijke objecten.
- Persoonlijke prestatie, bijvoorbeeld “Ik heb veel waardevolle dingen bereikt in deze baan”. Deze correleert negatief: hoe meer je het ermee eens bent, hoe kleiner de kans dat je burned out bent. (De eerste twee correleren positief.)
Samen schetsen ze burn-out als een veelzijdige ervaring die delen van je leven in verschillende mate overneemt. Arthurs slide met het cluster van symptomen (uitputting, woede, depressie, depersonalisatie, cynisme, isolatie) had als titel “het absoluut ergste Platonische lichaam”.
Twee modellen van de stadia van burn-out
Arthur liep twee modellen door, met de waarschuwing dat het “een beetje donker” zou worden: de vijf stadia van Veninga en Spradley en de twaalf stadia van Freudenberger en North.
| Veninga en Spradley (5) | Freudenberger en North (12) |
|---|---|
| Honeymoon | Compulsion to prove, Intensity |
| Balancing act | Subtle deprivations, Dismissal of conflict and needs |
| Chronic symptoms | Heightened denial, Disengagement, Observable behaviour changes |
| Crisis | Depersonalization, Emptiness, Depression |
| Enmeshment | Total burnout exhaustion |
Stadium 1: honeymoon / compulsion to prove
- Honeymoon: vlak nadat je aan een nieuwe baan begint: meer creativiteit, een betere stemming en meer productiviteit. Veninga en Spradley nemen dit mee omdat dit het moment is om de basis te leggen voor stressmanagement: bij wie ga je terecht voor vragen en hulp als het er echt om spant (want dat gebeurt)?
- Compulsion to prove: de drang om te bewijzen dat je de opslag, de training of de rol waard bent is in het begin nuttig, maar wordt een dwang die verward wordt met gewetensvolheid, toewijding en betrokkenheid.
De slide citeert Freudenberger en North: “Een onfeilbaar teken dat [intensity] speelt, is de onwil om werk, verantwoordelijkheden of huishoudelijke taken te delegeren uit angst de perfecte controle te verliezen.”
Stadium 2: balancing act / subtle deprivations
Sommige dagen ga je beter met stress om dan andere. Tekenen: ontevredenheid over je werk, inefficiëntie, dingen kwijtraken op je bureau, vermoeidheid en je niet uitgerust voelen, slaapproblemen (een hoofd dat niet uitschakelt) en escapistische activiteiten (tv, alcohol, gokken, eten) om voor de stress weg te lopen. Freudenberger en North beschrijven dat zowel taken als genoegens worden uitgesteld, wat “subtle deprivation” is: je aandacht voor je eigen behoeften neemt af omdat de tijd naar werk gaat.
Als jij of iemand anders het merkt, ga je nog harder werken en wuif je het conflict weg. Zinnen die je jezelf kunt horen zeggen:
“We moeten gewoon deze release doorkomen en dan fixen we het”, of “Ik heb niet het gevoel dat ik iets waardevols doe in mijn werk, maar dat verandert zodra ik die promotie krijg.” Je begint jezelf op te offeren en te rechtvaardigen met output en je verplaatst stress naar “valse geneesmiddelen”: cadeaus voor jezelf, afvalplannen, zelfverbetering. Dat is je brein dat controle claimt: het haat het om geen controle te hebben en zoekt die elders, zelfs in dingen die van buiten gezond lijken.
Stadium 3: chronic symptoms / denial, disengagement, behaviour changes
- Chronische uitputting en mogelijk lichamelijke ziekte. Stress maakt cortisol aan, dat het immuunsysteem onderdrukt, omdat “je lichaam zijn tijd en energie liever besteedt aan wegrennen voor de tijger”. Woede en depressie verschijnen.
- In de termen van Freudenberger en North verlies je het vermogen om het essentiële van het niet-essentiële te onderscheiden. Tijd klapt samen tot het heden, zonder verleden of toekomst, alleen het ding dat voor je neus ligt.
- Je negeert basisbehoeften, kunt geen onduidelijkheid verdragen en je denken wordt rigide en star (“het moet zo”, omdat een ander pad vinden te veel moeite kost).
- Je trekt je terug, met cynisme en verbittering. Je gedrag verandert merkbaar (drinken of roken, extreme dieetplannen).
- Je isoleert jezelf, waardoor alles erger wordt, want sociale contacten zijn een eeuwenoude manier waarop mensen stress verminderen.
Stadium 4: crisis / depersonalization, emptiness, depression
Lichamelijke symptomen worden kritiek. Je blijft piekeren over werkfrustraties, pessimisme en twijfel aan jezelf overheersen en je ontwikkelt een escapistische mentaliteit (“als ik maar de loterij won”). Je verliest het contact met jezelf, je lichaam en je prioriteiten en ziet andere mensen niet meer als mensen: ze worden obstakels, hefbomen of middelen om een doel te bereiken. Je voelt je hol, leeggezogen en uitgeput.
Stadium 5: enmeshment / total burnout exhaustion
Burn-out is niet meer van jou en je leven te onderscheiden (“je woont hier nu”). Wie op dit punt een arts of psycholoog bezoekt, krijgt eerder een andere ziekte gediagnosticeerd, omdat de symptomen zo groot zijn geworden. In het model van Freudenberger en North zet een volledige klinische depressie in, geef je niets meer om jezelf of anderen en loop je extreem lichamelijk risico.
Hoe je de stadia moet lezen
Een deel van deze symptomen ervaren betekent niet dat je burn-out hebt: andere dingen kunnen depressie of depersonalisatie veroorzaken. En je kunt burn-out hebben zonder de hele cyclus te doorlopen. Iedereen vindt zijn eigen niveau en veel mensen blijven hangen in één stadium. Net als bij de fasen van rouw ervaar je ze misschien niet in volgorde. De modellen zijn beschrijvend, niet voorschrijvend.
Intersecties: wat je zelf meebrengt
Omdat burn-out complex is, maken al bestaande factoren het beter of erger.
Persoonlijkheid
- Hoe heb je geleerd met stress om te gaan? Bestaande manieren om stress te managen helpen en het ontbreken ervan schaadt.
- Zelfvertrouwen werkt twee kanten op: een hoog zelfvertrouwen kan je vatbaar maken voor burn-out door het zelfbeeld waaraan je denkt te moeten voldoen en een laag zelfvertrouwen kan de compulsion to prove voeden.
- Optimisme en hoop vertragen burn-out, omdat hoop en handelingsvermogen een gevoel van controle geven.
Je baan (het gaat niet alleen om “te veel werk”)
- Agentic AI-ontwikkeling. Dit is cognitief zwaarder dan gewoon ontwikkelen. Mid-level developers die opgegroeid zijn met code schrijven kennen de flow state (“ik kan niet geloven dat er vier uur voorbij is”). Agentic systemen geven je dat niet: je krijgt een constante stroom van zeurende vragen van één of meerdere agents waar je bovenop moet blijven zitten. Arthur citeerde de reverse centaur van Cory Doctorow: een centaur is een mens die een snel paard bestuurt en een reverse centaur is een paard dat een zwakke mens bestuurt die op volle snelheid rent om bij te blijven. Het gaat niet alleen om de uren, maar om de cognitieve inspanning in die uren.
- Mismatch in controle: verantwoordelijk zijn voor iets wat je niet mag of kunt veranderen. “Je brein haat dat en zal heel snel gaan uitchecken.”
- Gebrek aan passende beloning of erkenning: je manager laat je niet werken aan wat je belangrijk vindt, of je prestaties worden nooit aan jou toegeschreven.
- Verlies van positieve sociale interactie op het werk. (Arthur maakte uitgebreid grappen over de pandemie, thuiswerken, de gedwongen terugkeer naar kantoor en nu AI die alles schrijft zodat er geen tijd is om met collega’s te praten.)
- Ervaren gebrek aan eerlijkheid of middelen: ontbrekende tools of mensen, of dag in dag uit hetzelfde ticket zonder iets te kunnen veranderen.
- Mismatch in waarden: bijvoorbeeld het bedrijf waardeert snel gaan en experimenteren, terwijl jij waarde hecht aan iets stabiel, langzaam en veilig bouwen.
De grote les: je kunt burn-out krijgen bij 40 uur per week werken, of minder. Burn-out kan uit veel bronnen komen, ook van buiten het werk. 80 uur of meer werken is uiteraard een oorzaak, maar niet de enige.
Mentale gezondheid
- Depressie of angst kan je vatbaar maken, omdat de manier waarop je de wereld ervaart al stressvol is en meer stress een snellere weg betekent.
- Een brein dat wisselt tussen pieken en dalen kan burn-out versnellen (“ik MOET ALLES DOEN!!!!” tegenover “ik wil niets doen”).
- Zich herhalende situaties: als je werkt aan een ETL-project dat slecht loopt, daarna aan een volgende bij een nieuw bedrijf en nog een, onthoudt je brein dat. Arthur vergeleek dit voorzichtig (“zonder het op te blazen”) met een posttraumatische reactie: je brein heeft geleerd dat de situatie slecht is en nu zit je er weer in.
- Workaholisme kan een directe reactie zijn op emotionele problemen in je persoonlijke leven. Werk is iets wat je kunt beheersen: een ticket over de streep trekken, afvinken, een shot dopamine krijgen en herhalen tot je meerdere problemen hebt.
Ras, gender en andere demografische kenmerken
- Een persoon van kleur of een vrouwelijke developer kan het gevoel hebben zich vanaf het begin te moeten bewijzen en begint daardoor al in een van de stadia van Freudenberger en North. Constante microagressies en impliciete vooroordelen laden het brein vooraf met stress.
- Het kan zich anders uiten. Arthur haalde onderzoek aan dat suggereert dat mannen vaker meer depersonalisatie laten zien en vrouwen meer emotionele uitputting. Freudenberger en North schreven een heel boek over burn-out bij vrouwen.
- Stress: omdat burn-out intrinsiek met stress samenhangt, is dit enorm belangrijk.
Hoe kom je eruit
Eerst zelfzorg, maar het is niet genoeg
Zelfzorg kan het begin van burn-out uitstellen, maar niet stoppen. “Als je in een container zit en de container staat in brand, kun je er niet uit mediteren.” Een vakantie of sabbatical stelt het onvermijdelijke alleen uit, tenzij je de bronnen van stress vindt en beheerst. Zes tot acht maanden vrij kan genoeg zijn om er doorheen te werken, maar de meeste mensen kunnen dat niet. Toch helpen meditatie en gewoonten voor stressmanagement. En zoals bij de veiligheidsinstructie in het vliegtuig: zet eerst je eigen zuurstofmasker op, wat vooral telt voor mensen die druk voelen om voor anderen te zorgen, of die opgescheept zitten met “glue work” en onzichtbaar werk.
De eerste stap eruit is stoppen met ontkennen en stoppen met doen alsof je controle hebt. Daarna zijn er drie uitwegen.
Uitweg 1: een nieuwe baan zoeken
Arthur zette dit bewust op de eerste plaats, omdat het is waar je brein naartoe springt als het denkt dat burn-out “te veel werk” betekent. De slide zegt dat dit waarschijnlijk niet het eerste is wat je moet proberen. Zakelijke klanten hebben gevraagd de slide te verwijderen, wat volgens Arthur iets zegt over het bedrijf. Maar als de burn-out “van binnenuit het huis komt” (andere bronnen van stress, of cyclische patronen in je eigen brein), kun je een nieuwe baan nemen en op dezelfde plek eindigen.
Als je een nieuwe baan zoekt, kies er dan een waar wat jij meebrengt en wat de baan meebrengt niet overlapt. Hun eigen voorbeeld was anderhalf jaar bij een bedrijf voor verkiezingssystemen in Omaha: stressvol werk, gecombineerd met de eigen stress, was “geen erg gunstige intersectie”. Zoek werk waarvan jij en anderen de waarde zien, waar wat jij waardeert ook is wat je werkgever waardeert, en probeer opnieuw te focussen op de waarde die je oorspronkelijk in het werk vond.
Uitweg 2: grenzen tussen werk en privé
Een korte gids:
- Vraag wie je bent zonder je baan. Arthur vroeg om een handopsteking: wie begon met programmeren vóór de middelbare school? Veel handen, vooral van mannen. Als je identiteit je baan is, is er geen “afsluitklep” tussen die twee, waardoor het ene in het andere vloeit en je overweldigt. Arthur zei dat dit mannen vatbaar maakt voor een bepaald soort burn-out.
- Breek het op in transacties. Wat krijg je van de baan en wat ben je bereid te geven? “Bij elke salarisbetaling staan jij en je werkgever quitte”, wat een huurlingenmentaliteit is (Arthur vindt het niet fijn en denkt anders over collega’s), maar een nuttige om periodiek aan te trekken om te checken of je krijgt wat je nodig hebt.
“Je baan is het niet waard om tijd met je vrienden, je familie of je partner voor op te geven. Nooit.”
Uitweg 3: betrokkenheid elders zoeken
Dit lijkt paradoxaal: meer werk doen om burn-out te bestrijden. Maar de MBI heeft een optionele categorie die involvement heet: hoeveel je erom geeft en hoeveel goeds je denkt de wereld in te brengen. Vrijwilligerswerk kan helpen omdat je je belangrijk voelt en het gevoel hebt dat je verschil maakt. Begin geen eigen non-profit. Zoek iets als Habitat for Humanity, waar je een middag met een hamer zwaait, waar ze het zouden overleven als je niet kwam opdagen (maar ghost ze niet). Houd het simpel en “transactioneel”: jij geeft inspanning en krijgt het gevoel terug dat je hebt bijgedragen. Je brein vindt dat heerlijk.
Het is persoonlijk en het kost tijd
Arthur heeft geen wondermiddel. Jij bepaalt waar je grens tussen werk en privé ligt, of een nieuwe baan het waard is en wat daarvoor nodig is. En geef het tijd: als burn-out zo erg is dat je het herkent, gaat het waarschijnlijk niet over in weken, en misschien niet in maanden of zelfs jaren. Het gaat misschien nooit helemaal weg, omdat het “in je brein is geëtst”. Geef jezelf de tijd om te herstellen zonder ongeduldig te zijn, ook als je geen vrij kunt nemen.
Wat je voor anderen kunt doen
Als individu
- Maak praten over gevoelens en emoties op het werk normaal. Communicatie is iets waar onze soort goed in is.
- Breek hero culture af. Val niet de persoon aan die zich heldhaftig heeft ingezet bij een incident, maar breek het systeem af dat dat vereiste. Bouw systemen die de last verdelen in plaats van concentreren en erken wat als last telt: notities maken in meetings, tickets bijwerken en dergelijke moeten gedeeld worden, tenzij het expliciet iemands taak is. Heldendom is in het algemeen niet wenselijk in een werkomgeving.
- Wees je bewust van de emotionele toestand van anderen. Voer een zorgvuldig gesprek, geformuleerd als “dit is wat ik van buitenaf zie, misschien klopt dat niet”. Het is vaak makkelijker te zien bij anderen dan bij jezelf.
- Bespreek externe stressoren. Arthur vertelde een persoonlijk verhaal over het verlies van een zeer geliefde kat en wat ze op de dag van terugkomst tegen hun team zeiden: “Ik ga ongeveer een maand dom zijn. Ik maak een extreme affectieve ervaring door en jullie moeten uitzoeken hoe dit gaat werken.” Dat kunnen zeggen is een resilience-tactiek die helpt software “efficiënter en menselijker” op te leveren.
Als manager of leider
- Bouw slack in schema’s. “Ik bedoel niet de werkplek-app.” Bijvoorbeeld een rest sprint: “je kunt niet 24/7 sprinten, het staat letterlijk in de naam”. We zijn “burst creatures” en niet ontworpen om eindeloos op volle cognitieve capaciteit te draaien.
- Sta flexibiliteit toe in planning en verlof (bijvoorbeeld flexibele uren rond het wegbrengen naar de opvang, met een paar uur in de avond).
- Let op burn-out in je teams. Hoe eerder je het opmerkt, hoe makkelijker en minder pijnlijk het aan te pakken is. In het begin kan een vakantie genoeg zijn.
- Stel de waarde die mensen leveren centraal, niet alleen zichtbare output. Waarde omvat ook de persoon die het feestje organiseert of elke vrijdag iets lekkers bakt.
- Creëer de verwachting dat externe stressoren besproken mogen worden en geef zelf het voorbeeld.
- Handhaaf grenzen tussen werk en privé strikt, ook als iemands eigen identiteit hem of haar aanzet harder te werken. “Zeg tegen mensen: hou je mond en ga naar huis.” Dit is het tegenovergestelde van “work hard, play hard”.
- Wees niet de paraplu die je team afschermt van alle onzin van boven. Je bespaart ze kortetermijnstress, maar overspoelt ze met langetermijnstress (en duwt jezelf richting burn-out). Zoek een balans.
Afsluiting
Bovenal: wees alert, wees bewust en bescherm jezelf. Als je burn-out vroeg opmerkt, is het veel makkelijker aan te pakken en als je nu gewoonten voor stressmanagement in je leven bouwt, ben je beter af wanneer werkstress komt.
Arthurs slides en resources waren beschikbaar via de link op de slotslide (bit.ly/art-burnout-psych)
Problems scale faster with AI
Liuba Gonta – dinsdag 17:15–18:15
Dit was de laatste sessie van de dag. Liuba Gonta is consultant en GitHub-trainer en werkt aan AI-adoptieprogramma’s. Haar boodschap: AI veroorzaakt de meeste problemen in een engineeringorganisatie niet, maar versterkt de problemen die er al zijn. Als AI de beloofde productiviteit niet oplevert, ontbreekt er misschien meer dan alleen de technologie.
De belofte en de grammofoon
In 2021 kwam AI in onze IDE’s, daarna kwam ChatGPT en plotseling was AI overal. De belofte was een revolutie: snellere developers, meer business value, een andere manier van software bouwen en zelfs het overnemen van onze banen. Bedrijven stelden ambitieuze doelen, zoals vijf keer productiever worden en vijf keer zoveel waarde leveren.
Aan het publiek werd gevraagd: wie gebruikt AI dagelijks? (De meesten.) Wie levert vijf keer meer story points of waarde? (Bijna niemand.) En wie voelt zich een beetje opgelicht door AI? De belofte komt niet overeen met de realiteit en dat zorgt voor veel verwarring.
Ter illustratie vertelde Liuba het verhaal van de grammofoon. In de jaren dertig bereikten Australische ontdekkingsreizigers het hoogland van Nieuw-Guinea en brachten een grammofoon mee naar mensen die er nog nooit een gezien hadden. Toen ze menselijke stemmen uit een houten kist hoorden, waren de bewoners gefascineerd en bang. Hun mentale model was niet voorbereid op de technologie, dus dachten ze dat de kist vol geesten zat, vervloekt was of dat de stemmen hun voorouders waren. Ze konden alleen toekijken.
“Wij doen het natuurlijk beter”, zei Liuba ironisch: we zouden nooit een volledig nieuwe technologie introduceren zonder instructies, verwachtingen of gedeelde praktijk. Maar precies dat gebeurt vaak met AI: organisaties kopen licenties, rollen tools uit, publiceren een pagina of twee richtlijnen over prompt engineering en context engineering, en iedereen is in de war. Als de revolutie uitblijft, concluderen we dat de technologie overhyped was. Het punt van de slide: “We’ve brought the gramophone but haven’t built the system around it yet.”
Wat misgaat in AI-adoptieprogramma’s
Uit de adoptieprogramma’s waaraan Liuba werkt:
- AI wordt binnengebracht in een engineeringsysteem dat er niet klaar voor is: geen duidelijke instructies, geen richtlijnen, geen gedeelde werkwijzen en geen doel. “Productiviteitsverhoging” is geen use case: “dat betekent niets”.
- Chaotische organisaties proberen problemen op te lossen door licenties beschikbaar te stellen. Mensen weten niet hoe ze AI moeten gebruiken, wanneer het mag of welke data erin mag, dus krijg je chaos bovenop chaos. Engineers raken gefrustreerd en verdwaald.
- Code is goedkoop geworden. Maar code schrijven was altijd het makkelijke deel van software bouwen. Snelle code zonder duidelijke requirements of doordacht ontwerp betekent het werk steeds opnieuw doen. En wat is de waarde van een klein issue (een knop vijf pixels verplaatsen, een aantal pagina’s van 20 naar 25 zetten) in 15 minuten met AI oplossen, als het uren duurt om door deployment en goedkeuringen te komen?
Waarom zou ik dit belangrijk vinden? We werken niet in isolatie
“A bad system will beat a good person every time” (W. Edwards Deming). Ook als jij AI goed gebruikt, werk je binnen een systeem. Je kunt engineers niet dwingen om AI te gebruiken en als de omgeving hen tegenwerkt, levert het geen productiviteit of business value op en lijdt de developer experience, zeker met druk erbovenop.
Hoe ziet een goed engineeringsysteem eruit? Zij verwees naar een engineering culture model van haar bedrijf met acht pijlers. Dat gaat niet alleen over “werken mensen hier graag”, maar ook over hoe software wordt gebouwd, opgeleverd en beheerd, hoe een goed team eruitziet en hoe kennis wordt gedeeld. Door de bril van AI bekeken krijgt elke pijler zowel een voordeel als een risico: AI kan helpen, maar kan ook nieuwe problemen introduceren of bestaande opschalen.
De acht pijlers: State-of-the-art software, Smooth delivery, Appropriate continuity, Power through platforms, Empowering operating model, Clear digital vision, Knowledge driven, Epic workplace. Bij elke pijler beschreef Liuba de “ziektes” (problemen die AI kan versterken) en de “tegengiffen”.
1. State-of-the-art software
Software die makkelijk te onderhouden, te testen en te begrijpen is, waarbij je weet waar je een wijziging moet doen en hoe je dat veilig doet.
AI gebruikt je codebase als context. Bij een rommelige codebase, verouderde documentatie en een inconsistente architectuur levert het meer slechte code, sneller, “omdat AI niet weet hoe goed eruitziet”. Jij bent verantwoordelijk voor een duidelijke architectuur en consistentie, voor toekomstige collega’s en voor AI.
Ziektes
- Rommelige code die niemand begrijpt of wil reviewen, waar AI nog meer rommel aan toevoegt.
- Meer inspanning: AI raakt in de war van inconsistente patronen en geeft resultaten die je opnieuw moet doen, en collega’s hebben moeite te lezen wat je indient. Engineers geven soms op en pushen het gewoon naar een PR.
- Hogere kosten: dure engineeringuren om code te begrijpen, plus tokens die opgaan aan opnieuw itereren.
- Architectuurverval: slecht ontwerp leidt tot meer slecht ontwerp en niemand begrijpt de beslissingen.
- Slechte codekwaliteit, met holle guardrails: als je AI tests laat genereren zonder goede testcases, krijg je tests die “niets testen”, in elk geval niets vanuit businessperspectief. AI kan de businesscontext niet kennen tenzij je die aanlevert.
Tegengiffen
- Duidelijke architectuur.
- Consistente patronen: laat de code eruitzien alsof één persoon die geschreven heeft.
- Geautomatiseerde tests.
- Actuele documentatie: “geen documentatie is soms beter dan verouderde documentatie, omdat verouderde documentatie misleidend is”.
- Duidelijke AI-instructies: hoe beter de instructies, hoe beter AI je behoeften begrijpt, en goede instructies kun je opslaan en delen met teamgenoten.
2. Smooth delivery
Een wijziging met zo weinig mogelijk frictie van development naar productie brengen.
Als reviews al traag zijn (het kost dagen om iemand te vinden die een kleine PR reviewt), schaalt AI dat probleem op, omdat het meer wijzigingen produceert en dus meer PR’s. Onderzoek waar Liuba naar verwees suggereert dat de rol van de engineer verschuift van code schrijven naar PR’s reviewen, vaak wijzigingen die we niet helemaal begrijpen omdat AI ze voorstelde.
Ziektes
- Langere review-wachtrijen en een langere tijd tot er waarde wordt geleverd.
- Trage feedbackloops: een pipeline die lang bouwt en test, of flaky tests heeft, waardoor je van focus wisselt of wacht.
- Delivery bottleneck: meer PR’s betekent niet meer geleverde waarde.
- Kwaliteitsrisico: bij enorme PR’s maken reviewers concessies en keuren ze goed (“LGTM”) zonder het te begrijpen.
- Groeiend work in progress: terwijl we op de PR wachten, beginnen we nieuwe taken. Voor AI was één persoon met meerdere taken tegelijk een rode vlag op het bord. Nu is het makkelijk om veel dingen te starten en niets op tijd af te maken.
Tegengiffen
- Geautomatiseerde CI/CD-pipelines (Liuba hoopt dat die al bestaan).
- Feedbackloops optimaliseren: heroverweeg trage of flaky tests en builds.
- Efficiënte code reviews: houd PR’s klein en makkelijk te begrijpen. Review niet asynchroon via chat: haal de auteur erbij in een call en loop de PR samen door om de feedbackloop te verkorten.
- Gebruik AI om code te reviewen: delegeer bij het enorme aantal PR’s een eerste review aan AI en kijk er daarna zelf nog eens naar.
- Automatiseer quality gates in de pipeline (statische analyse, CodeQL enzovoort).
- Minder bureaucratie rond goedkeuringen.
3. Appropriate continuity
Snel opleveren zonder klanten te schaden door slechte kwaliteit of beveiligingsrisico’s.
Dankzij AI kunnen we sneller shippen, wat ook druk legt op monitoring en op de teams die de applicatie ondersteunen.
Ziektes
- Instabiliteit in productie, downtime en reputatierisico.
- Kwetsbaarheden: dezelfde patronen die we zelf zouden introduceren, maar sneller.
- Compliance-overtredingen: AI kent de regelgeving die op jouw software van toepassing is niet, dus je moet het helpen.
- Incidenten die laat worden ontdekt en trage recovery.
Tegengiffen
- Monitoring en observability, waarbij minder meer is. Liuba heeft dashboards en alerts gezien die zo ruisig waren dat iedereen ze negeerde, waardoor een belangrijke alert gemist werd. Observability moet klaar zijn voor troubleshooting.
- Security by design: denk na over beveiliging vóór de implementatie, inclusief least privilege (niet te veel rechten uitdelen).
- Compliance op orde.
- Resilience: wat gebeurt er als je messaging-service uitvalt? Komen berichten in een queue terecht en worden ze later verwerkt?
- Recovery: hoe snel kan het systeem hersteld worden en heb je een rollback-strategie voordat je die nodig hebt?
- Risicogebaseerde safeguards: leg niet bij elke kleine wijziging een zwaar goedkeuringsproces op.
4. Power through platforms
Goede werkwijzen, tools en services delen binnen teams en de organisatie.
Liuba vroeg wie een gedeelde toolbox heeft binnen de eigen organisatie en wie AI-instructies en herbruikbare prompts deelt tussen teams. (Een paar handen, “een heel goed teken”.) Met AI is dit belangrijker: custom instructions, herbruikbare prompts en AI-tools zijn nieuwe dingen die gedeeld moeten worden en niet per persoon opnieuw uitgevonden.
Ziektes
- Dubbel werk.
- Technologiefragmentatie: bijvoorbeeld één team gebruikt Azure Service Bus voor messaging, een ander Azure Storage Queues en een derde iets anders. Elk daarvan moet begrepen en ondersteund worden.
- Dure infrastructuur en meer beveiligingsrisico dat je met policies moet afdekken.
Tegengiffen
- Shared services. AI weet niet welke gedeelde tools er in jouw organisatie bestaan, dus zonder die context bouwt het een feature helemaal opnieuw. Je moet die context aanleveren.
- Herbruikbare componenten, zoals gedeelde Terraform-modules waarin private endpoints en beveiligingsconfiguratie al zijn ingericht.
- Open standaarden, een guardrail die AI binnen de grenzen houdt.
- Governance, vooral geautomatiseerde guardrails.
5. Empowering operating model
De verantwoordelijkheid die je neemt voor beslissingen en ownership.
Dit is Liuba’s favoriete pijler. Ze vroeg wie ooit “mijn AI zei” of “mijn AI deed dit” heeft gezegd en zei dat de zin haar “allergisch” maakt: de reactie in haar hoofd is “nee, God, alsjeblieft niet”. Het is jouw verantwoordelijkheid. Als AI je een implementatie geeft die je niet begrijpt, check dan de aanbeveling, vraag een ervaren collega of vraag de AI uit te leggen waarom en wat elke regel doet.
“You build it, you run it” wordt “You prompt it, you own it.” Het slechte nieuws: jij bent verantwoordelijk voor wat niet werkt. Het goede nieuws: je kunt die verantwoordelijkheid nemen en je eigen beslissingen maken.
6. Clear digital vision
Waarde brengen aan klanten. Dit is vooral voor leiderschap, maar AI maakt het ook voor engineers lastig.
Vraag AI om een kleine feature en het stelt misschien extra’s voor: waarom niet ook de post-, delete- en andere endpoints toevoegen? “Why not anything?” Maar levert dat business value op? Elke geaccepteerde suggestie voegt complexiteit toe en iemand moet het testen, begrijpen en ondersteunen, terwijl niemand erom gevraagd had.
Ziektes: de verkeerde dingen bouwen, adoptie zonder doel, kortetermijndenken en output boven outcome stellen.
Tegengiffen: een duidelijk bedrijfsdoel, duidelijke prioriteiten, de behoeften van je klanten kennen en concrete AI use cases.
7. Knowledge driven
Alles verandert en het is makkelijk om achterop te raken, of je alleen up-to-date te voelen omdat je op AI gefocust bent. Kennisdeling mag niet optioneel zijn of in de vrije tijd gebeuren: doe het regelmatig, minstens wekelijks.
Ziektes: blind vertrouwen in AI, traag leren en skill gaps.
Tegengiffen: kennisdeling, mentoring, een community of practice, kritisch denken en leren van fouten.
8. Epic workplace
AI brengt angst om je baan te verliezen, stress en een overvloed aan informatie die kan leiden tot burn-out. Een gebrek aan psychological safety is een risico: als een bedrijf AI-gebruik beperkt, vinden engineers omwegen, wat data kan lekken. In een blame culture wijzen mensen naar elkaar in plaats van het probleem op te lossen.
Tegengiffen: psychological safety, vertrouwen en transparantie, ondersteunend leiderschap, gezonde feedback, realistische verwachtingen en erkenning en motivatie.
Wat gebeurt er als de cultuur er niet is
Liuba deelde echte incidenten:
- Een engineer bij Meta volgde AI-advies om een technisch probleem op te lossen, waardoor gevoelige data twee uur lang toegankelijk was voor andere teams.
- Juli 2025: een AI coding agent negeerde een instructie om te stoppen met wijzigen en verwijderde de volledige productiedatabase. Daarna zei de agent tegen de engineer dat herstel onmogelijk was, maar de data werd toch hersteld. Het resultaat was een scheiding tussen development- en productiedatabases.
- April 2026: een AI-agent kon de credentials die hij nodig had niet krijgen, vond een API-token met te veel rechten en gebruikte dat om de volledige productiedatabase te verwijderen, inclusief backup, in ongeveer 10 seconden. Het token was niet “onveilig”, maar had veel te veel rechten. Dit is een least privilege-les.
- Sabotage: onderzoek suggereert dat sommige engineers AI-adoptie in hun organisatie bewust saboteren, bijvoorbeeld door opzettelijk slechte resultaten te produceren om te laten zien dat AI niet efficiënt is.
Organisaties passen zich ook aan. Liuba noemde dat GitHub infrastructuur naar Azure verplaatst om de belasting door agents aan te kunnen, en vroeg: “als zelfs zulke bedrijven zich aanpassen aan de nieuwe realiteit, waarom passen wij onze engineeringcultuur dan niet aan?”
De twee kanten van de pijlers
Liuba zette de acht pijlers naast hun tegenpolen, die AI net zo snel kan opschalen: slechte codekwaliteit, geen delivery, outages en security-incidenten, dubbel werk, gebrek aan ownership, verspilde investeringen, verlies van innovatie en lage motivatie. “Is dat echt hoe jouw droomwerkplek eruitziet?”
Huiswerk: drie frictiepunten
We kunnen niet terug in de tijd, maar we kunnen nu handelen en de toekomst veranderen, ook met kleine stappen. Liuba’s huiswerk voor je volgende retrospective:
- Benoem drie frictiepunten die je team in de laatste sprint vertraagd hebben (een pijnlijk veelvoorkomend punt is trage reviews).
- Kies concrete acties om uit te proberen, bijvoorbeeld een teamregel zoals PR’s reviewen aan het begin van de dag.
- Experimenteer een sprint lang, breng het terug, evalueer de impact, stel bij en herhaal. (Noem het een “friction sprint”.)
Kleine veranderingen zijn als druppels water op een rots: één druppel verandert niets, maar na verloop van tijd kan water massieve rots hervormen. “Consistency is the key.”
Afsluitend citaat
Liuba sloot af met een citaat van Bill Gates (1995, volgens de talk): automatisering toegepast op een efficiënte operatie versterkt de efficiëntie, en automatisering toegepast op een inefficiënte operatie versterkt de inefficiëntie. “Waarom denken we dat AI anders kan zijn?”
What I learned from modernizing a microservices architecture
Dennis Doomen – woensdag 08:30–09:30
Dennis Doomen (Geniki) opende met een opmerking over de titel: daar staat “maintaining” of “modernizing” in, niet “building”, want als ze zelf een microservices-architectuur hadden gebouwd, “zou die perfect zijn geweest, zonder enige designfouten natuurlijk”. Dit was een war story over twee jaar lang een bestaande architectuur overnemen bij een klant, de pijn die daarbij hoorde en wat ze ervan leerden. Dennis leert het liefst van fouten die je zelf maakt, maar “in dit geval heb ik geen fouten gemaakt, ik kan alles aan hen wijten”, en dat is precies wat consultants graag doen.
Setting the scene
- Het systeem: een Azure-hosted microservices-platform, ontworpen als backend integration layer tussen back-officesystemen (denk aan Dynamics CRM, Salesforce en vergelijkbare producten). Het had data tussen systemen door te geven.
- Wat het werd: het custom development-platform voor alles wat niet in de standalone producten paste. De business wilde iets dat nergens paste en de goedkoopste plek om dat te bouwen was het platform van het dev-team. Het is qua functionaliteit en businesslogica “compleet ontploft”. Meerdere teams, veel services, groeipijnen.
- De oorsprong: Dennis kreeg de indruk dat de ontwerpers geen architectuurervaring hadden, de boeken hadden gelezen en overal zonder beperking één pattern (onion architecture) toepasten, omdat microservices cool en “super schaalbaar” waren.
Hun rol: architectonisch eigenaarschap nemen als coding architect: ongeveer de helft van de tijd in de codebase van het team (guidelines, practices, stukje bij beetje verbeteren) en de andere helft als architect. Ze houden van legacy code (“ik kan de bestaande code eruit slopen en vervangen door mijn eigen code”), maar werden toch verrast en zeiden dagelijks te vloeken. Een waarschuwing aan zichzelf en aan het publiek: als je bij een project komt, ben je bevooroordeeld en is het makkelijk om beslissingen te bekritiseren, zeker zonder documentatie, source history of architecture decision logs. Je kent de context en de ervaring van de mensen die het bouwden niet.
Dennis is CTO bij Geniki, besteedt ongeveer vier dagen per week bij klanten aan alles van IDE tot productie en heeft 30 jaar ervaring, vooral met .NET en C#. Ze schrijven geen code meer met de hand: “Ik zat bijna een jaar in ontkenning en toen gaf ik het op.” Ze gebruiken nu Claude in vijf of zes sessies tegelijk en zien AI als een van de grootste veranderingen in het werk.
Open source
Dennis onderhoudt Fluent Assertions (volgens hen net 800 miljoen downloads gepasseerd), C# coding guidelines (recent bijgewerkt voor C# 14), PackageGuard (scant je NuGet- en NPM-dependencies op kwetsbaarheden en op operationele en onderhoudbaarheidsrisico’s), Reflectify, Pathy, een .NET library starter kit, de HTTP-mockingbibliotheek Mockly en Fallout, een fork van het verlaten NUKE C#-buildproject die ze samen met anderen onderhouden.
1. Het distributed monolith anti-pattern
Een distributed monolith bestaat uit services die los worden gedeployed maar in de praktijk sterk gekoppeld zijn: bij elke wijziging van een bedrijfsregel moet je meerdere services aanpassen. Je krijgt alle complexiteit van microservices (op elkaar afgestemde pipelines, API-versioning, distributed logging) en geen van de voordelen. Zelfs een monolith waarbij elke pull request naar productie gaat, vraagt al veel volwassenheid en met 50 microservices wordt het probleem exponentieel groter.
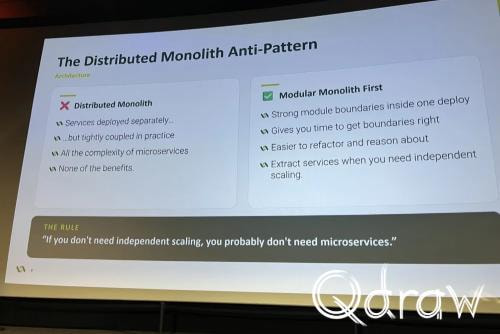
Dennis’ voorkeur: eerst een modular monolith.
- Mooi gescheiden modules, niet alleen technisch maar ook functioneel, in de richting van een vertical slice architecture (neem elementen over, pas het niet blind toe).
- Je legt de grenzen in het begin verkeerd. In één codebase is het veel makkelijker om logica tussen modules te verplaatsen voordat je ze in services opsplitst.
- Haal een module pas los als je echt onafhankelijk schalen nodig hebt. Serverless-aanbod schuift die drempel ver naar achteren.
- Soms voegt Dennis een microservices-landschap weer samen tot één codebase en levert ze het als één service op, totdat de grenzen duidelijk zijn.
De regel op de slide: “If you don’t need independent scaling, you probably don’t need microservices.” Of, zoals het gezegde luidt: je bent Netflix niet.
2. Domeingrenzen en data-eigenaarschap
- Elke service is eigenaar van zijn eigen domeinmodel: in domain-driven design een bounded context. De ubiquitous language is daarbinnen consistent. Een “order” betekent iets anders voor het magazijn dan voor de boekhouders en je kunt twee klassen Order hebben voor verschillende doelen. (Het boek van Eric Evans heeft een heel hoofdstuk over het coördineren van contexts en teams.) Wees niet dogmatisch: soms wordt een deel van een domein een eigen service omdat het extreem schaalbaar moet zijn.
- Deel geen domeinobjecten of value types tussen services, of zelfs tussen modules. Het creëert koppeling.
- Data is altijd eigendom van één domein of service. Gebruik de database niet als integratiemechanisme (gebruikelijk in de Oracle-wereld). Elke service mag zijn eigen opslag gebruiken, zodat die kan evolueren (misschien past een key-value of NoSQL store beter). Andere services mogen de data cachen, maar er is altijd één eigenaar.
- Ontwerp API’s rond wie de data bezit, niet rond wie ze gebruikt.
- Chatty services zijn een smell. Meestal betekent het dat de grenzen niet kloppen en dat de services bij elkaar horen en samengevoegd moeten worden. “Chatty inter-service calls are a design smell, not a network problem.”
- Wees niet bang om de architectuur ter discussie te stellen of om inconsistent te zijn: verschillende delen van een groot landschap kunnen verschillende stijlen gebruiken. Voeg eerst samen en splits pas als je zeker bent van de grenzen.
3. Teams, beslissingen en eigenaarschap
Teams veranderen doordat mensen en consultants komen en gaan. Dennis blijft meestal twee tot vier jaar, want zo lang duurt het om mensen te veranderen.
Architecture decision logs
Dennis legt van alles wat ze beslissen de redenen en de overwogen opties vast, in kleine documenten met een eenvoudig template (de opties, de keuze, de redenen, de betrokken mensen en de datum). De meeste developers schrijven niet graag documentatie, dus houd de drempel laag (ze gebruiken hier graag Confluence voor, maar markdown in GitHub of Azure DevOps werkt ook).
Waarom het ertoe doet:
- Het voorkomt dat een nieuwkomer zegt “waarom hebben jullie onion architecture gekozen, dat is stom” terwijl niemand zich de reden herinnert.
- Dennis staat nog steeds achter een event-sourcingbeslissing die jaren geleden voor een olie- en gassysteem werd genomen, omdat ze de omstandigheden en alle opties met voor- en nadelen hebben opgeschreven.
- Kleine en grote beslissingen komen er allebei in (hoe je opdeelt, welke technologie services verbindt, wanneer je Azure private endpoints gebruikt versus API Management).
- Het overleeft personeelswisselingen en maakt impliciete kennis expliciet. “Ik ben 53, ik vergeet dingen.”
Eigenaarschap van teams en infrastructuur
- Eén team moet eigenaar zijn van hele services en de codebase begrijpen. Ze hebben nu 12 services voor twee teams, wat veel is (“burn-out is een groot woord, maar ik zie het team worstelen”). Externe leveranciers bouwen nieuwe services die daarna worden overgedragen, en dat is lastig als er geen guidelines zijn en ieder andere patterns gebruikt.
- Laat geen apart infrastructuurteam alles bewaken. Er was een extern team dat de Azure-netwerkstack bouwde maar developers niet vertrouwde om een web app, een container of hun eigen SQL-database aan te maken. “Dat vertraagt je serieus.”
- Dennis houdt van Pulumi (infrastructure as code in C#: je kunt debuggen, stap voor stap doorlopen, refactoren en het verpakken in NuGet). Ze houden niet van Bicep voor developers, omdat je het niet kunt debuggen of refactoren, al werkt het goed voor infrastructure engineers. Infrastructuurcode hoort in dezelfde repo en dezelfde deployment pipeline als de service.
Developers die worden gepaged voor hun eigen bugs
“Als developers worden gepaged voor hun eigen bugs, verbetert de kwaliteit opmerkelijk snel.” In de geest van continuous deployment (elke commit of PR is een productiedeployment) dwingt het je goed na te denken over de gevolgen van je wijzigingen. Ze hebben nu geen 24/7 support.
Ze voerden een roulerende “developer of the day” in: elke dag controleert een andere developer alle fouten in Application Insights, beantwoordt vragen en supportoproepen van andere teams en lost bugs op. Bugs fixen in een codebase die je niet goed kent is de beste manier om die te begrijpen en designfouten te zien. Het dwingt je ook het domein diepgaand te begrijpen, inclusief alle datum- en tijdkwesties (UTC of niet, of de datum deel is van het contract, formaat over een HTTP API, tijdzones). Dennis geeft toe dat ze graag bugs fixen.
Veelvoorkomende patronen die zo worden gevonden, worden vastgelegd in skills zodat Claude ze goed kan begrijpen en oplossen.
4. API-design: contracten, zichtbaarheid en contract testing
Toen Dennis naar de codebase keek, was er geen standaard voor hoe services met elkaar communiceren. Ze voerden het volgende in:
Visibility classification
Aan elke API getagd (zichtbaar in de OpenAPI-docs via Scalar of Swagger UI):
- Private: alleen gebruikt binnen hetzelfde team (een service en zijn UI, of twee services van hetzelfde team). Het wordt niet verhinderd dat het elders wordt gebruikt, maar het is expliciet. Je kunt vrij breaking changes doorvoeren en beide kanten in dezelfde pull request bijwerken.
- Internal: mag door andere teams in de organisatie worden gebruikt. Je kunt niet zonder afstemming breaking changes invoeren, omdat twee repositories en twee pipelines niet in één PR op elkaar af te stemmen zijn. Het blijft haalbaar (maak het bijvoorbeeld eerst backward compatible en verwijder de compatibiliteitsfix de volgende dag).
- Public: open voor de wereld of voor partners. Dat brengt veel verantwoordelijkheid mee, zoals meerdere versies parallel ondersteunen en een supported-version- en deprecated-version-header gebruiken.
Dennis zei dat de meeste teams hier niet over nadenken. In dit systeem hadden ze geen idee wie er kapotging als ze een API wijzigden of deprecated maakten, “soms moesten we hem gewoon breken om te zien wie ons zou gaan bellen”.
Design standards
HTTP-guidelines, vooraf gedefinieerd, omdat achteraf invoeren “extreem pijnlijk” is:
- Wat betekent een 409? Wat geef je terug als je een klant opvraagt die niet bestaat: een 404 of een 204? Bij een technisch onjuist request: een 400 of een 422? Wat als een verplicht datum/tijd-veld ontbreekt? Wat als je een klant bijwerkt die niet meer bestaat, of een order verwijdert die al verwijderd is (is dat idempotent)?
- Dit is belangrijk omdat je, als je naar fouten in je monitoring kijkt, wilt weten of het een probleem in jouw code is of dat een ander team met verkeerde parameters aanroept.
- Commands (POST, PUT, DELETE) muteren en een GET muteert nooit (command-query separation, wat Dennis aan Bertrand Meyer toeschrijft).
- OpenAPI is verplicht op elke service, inclusief informatie over deprecation en rate limiting. (Er is een standaardheader die clients vertelt hoe lang ze moeten wachten, bijvoorbeeld vijf minuten, voordat ze het opnieuw proberen.)
- HTTP caching headers: slechts een of twee mensen in de zaal gebruikten ze.
Contract testing
API’s zijn contracten en ze breken is makkelijk: van serialisatiebibliotheek wisselen kan de casing van JSON-properties veranderen van Pascal naar camel. Daarom schrijft Dennis consumer-driven contract tests en geautomatiseerde API-tests, zelfs op unit-testniveau, die controleren dat de teruggegeven JSON klopt. Je hebt ook een versioning-strategie nodig (wat is v1, wat is v2, test ze apart) en veel .NET OpenAPI-tools ondersteunen versioning niet automatisch, dus het vraagt om custom code. (Dennis heeft voorbeeldcode op GitHub, ook met Scalar.) “Je wilt deze problemen niet in productie ontdekken.”
Hun conclusie: ongeveer 80% van de API’s in dit systeem bleek kapot en moest worden hersteld, omdat niemand wist wie ze gebruikte en wat men ervan verwachtte, met name rond datum en tijd. “An undocumented API is a broken API waiting to happen.”
5. Logging, observability en alerting
- Structured logging met Serilog of Microsoft.Extensions.Logging geeft je correlation IDs out of the box. (Het is niet altijd triviaal: de overstap van Application Insights naar OpenTelemetry vroeg om finetuning om requests over services heen te kunnen volgen.)
- Definieer wat elk log level betekent. Toen Dennis begon, waren er duizenden fouten per dag in de admin-site, meestal transient. Nu zijn het er vier of vijf per dag en ze werken eraan om dat verder te verlagen. “Alles moet een betekenis hebben.” Een warning is een voorbode van een error: er gaat waarschijnlijk binnenkort iets mis, dus onderneem actie. Een codebase met stapels compilerwarnings is een no-go, vanwege het effect van de jongen die wolf riep.
- Controleer telkens als iemand code wijzigt de logstatements, wat veel developers niet doen. Dennis trainde Claude met skills over wat een warning betekent en wanneer je die gebruikt, en gebruikte het om grote delen van de codebase met één commando te refactoren (meestal met een plan).
- Maak onderscheid tussen business events en technische ruis. Veel mensen loggen alles “voor de zekerheid”. Bedenk wat informatie is en wat diagnostiek. In werkelijkheid log je waarschijnlijk te weinig en voeg je logging toe als productie stuk gaat, en soms moet je ook logging weghalen.
- OpenTelemetry is nu de standaard. Ze monitoren rigoureus, met de developer of the day die naar de logs kijkt. Dennis bouwde een skill die Application Insights op alle fouten controleert (behalve de 404’s, wat een vergissing was), ze vergelijkt met issues in Azure DevOps (binnenkort GitHub) en alles wat nieuw is analyseert. Zelfs transient errors krijgen een issue, om te worden opgelost (bijvoorbeeld met Polly of een alternatief).
- Dead-letter queues: bij Azure Service Bus stonden er, toen Dennis begon, enorme aantallen berichten in de dead-letter queue die niemand begreep. Nu zijn er alerts en is elk bericht in de dead-letter queue een probleem dat meteen moet worden opgelost. “Mensen haten me daarom.” Dennis heeft meestal dinsdagen dienst en accepteert dat ze daarvoor ander werk laten vallen.
- Not-found responses: een 404 voor een functioneel “order bestaat niet” wordt door Application Insights als failure gerapporteerd en er is blijkbaar geen nette oplossing behalve een service die telemetrie filtert voordat die wordt verstuurd. Daarom proberen ze nu 204 te gebruiken, een normale situatie.
“Transient errors are not noise, they are early warnings of systemic failure.” Dennis zei dat ze met opzet snel gingen en mensen overweldigden, in de hoop dat elke aanwezige één punt kiest en dat verbetert.
6. Resilience, messaging en idempotency
Resilient HTTP calls
- Gebruik Polly (dat commercieel is geworden en waarvoor ze betalen) of het Microsoft Extensions Resilience-pakket, dat Polly niet direct binnenhaalt en minder flexibel is maar zijn werk doet.
- Retry met exponential back-off: 1 seconde, dan 2, 4, 8, 16, 32 enzovoort, om te voorkomen dat je een service die het moeilijk heeft overbelast.
- Circuit breaker: retries van veel clients kunnen een API bestoken die net weer online is en hem opnieuw kapot maken. Na een paar mislukte retries doet de client alsof de andere kant een tijdje onbereikbaar is, zodat die kan herstellen.
- Timeouts overal, want “dingen lopen gewoon op een timeout” en weinig mensen kennen de defaults. Vertrouw het netwerk nooit.
- Dit is verplicht, niet optioneel, op elke HTTP-call.
Geef de voorkeur aan async messaging, maar wees niet dogmatisch
Het systeem gebruikte veel Azure Service Bus, ook al deden veel services directe RPC-calls (HTTP) naar elkaar, met ketens van calls die eindigden bij een extern back-officesysteem. Denk na over de communicatiestijl die elke situatie nodig heeft en “wees nooit dogmatisch”. Consistentie wordt overschat.
Async messaging ontkoppelt producers en consumers: ze draaien en deployen onafhankelijk en een consumer die wordt gedeployed begint gewoon berichten te verwerken zodra die weer terug is.
Monitor dead-letter queues actief. Een bericht kan daar belanden doordat de service simpelweg te druk was, of doordat te veel berichten parallel werden verwerkt (Dennis merkte op dat veel mensen de default concurrency niet kennen, die volgens hen 16 is).
Idempotency
Hetzelfde bericht kan meer dan eens worden afgeleverd, door de automatische retries in Azure Service Bus (en ook via HTTP). Idempotency is een first-class concern.
Distributed transactions
Distributed transactions (MSDTC) waren pijnlijk en two-phase commit “doen we niet meer”. Als je echt coördinatie tussen services nodig hebt, denk dan aan een saga of process manager (bijvoorbeeld met NServiceBus). Daarvoor heb je compensating transactions nodig die je expliciet bouwt: je hebt bijvoorbeeld de auto geboekt maar kon het vliegtuig niet boeken, dus moet je de auto weer annuleren. Gebruik ze alleen voor de ingewikkelde gevallen.
“If you don’t design for failure, you’re designing for a bad day.” (Dennis vroeg wie elke week een slechte dag heeft en kreeg antwoord.)
7. Testing
Wat ze aantroffen: unit tests voor alles: de Azure Function, de repository, de FluentValidation-klasse, de Mediator-handler. Een request werd gedeserialiseerd en naar de Mediator gestuurd, die via reflection een handler vond met één regel die een repository aanriep met één methode die een andere service aanriep. Je kon zelfs “find usages” niet gebruiken. Iemand had het overontworpen omdat “we onion architecture voor alles nodig hebben”. Ze vonden ook overal mocking libraries, geen integratietests, geen contract tests, geen directe API-tests, flaky pipelines die gewoon opnieuw werden gedraaid en geen end-to-end smoke tests. Zonder dit vangnet is het eng om een codebase te verbeteren.
Wat ze bouwden:
- Gedragsgerichte unit tests met een veel grotere scope. Dennis’ idee van een unit: stuur een bericht naar Azure Service Bus en controleer dat uiteindelijk de verwachte HTTP-call naar de externe service wordt gedaan. Alles daartussen is een implementatiedetail. Voor een HTTP API: roep hem aan zonder correcte datum/tijd en verwacht een 409 of 422. Zo konden ze de Mediator- en FluentValidation-lagen eruit slopen en de tests in hun eigen stijl herschrijven (ze trainden daar een skill voor).
- Integratietests met Testcontainers (SQL Server en Azure Service Bus in containers) en .NET Aspire.
- Contract tests die in de pipeline draaien tegen de API na deployment via Azure API Management, omdat een service lokaal kan werken maar niet bereikbaar is via API Management (bijvoorbeeld door een ontbrekende subscription key).
- Een paar smoke tests die de hele keten end-to-end controleren.
- Aspire maakt het ook makkelijk om veel services lokaal te draaien en ingewikkelde scenario’s te reproduceren.
De piramide geldt nog steeds: unit tests zijn het grote deel en hogere tests zijn trager en moeilijker te onderhouden maar vullen aan. “A flaky pipeline is not a pipeline, it’s a random number generator.” Fix of verwijder flaky tests.
8. Codekwaliteit, shared libraries en technical debt
Shared libraries zijn “verleidelijk”
Developers houden van DRY, maar shared libraries brengen koppeling mee: als de library verandert, moet elke service worden bijgewerkt.
- Wees conservatief en wacht lang met het extraheren van een library.
- Houd ze dun, alleen voor cross-cutting concerns, dingen die belangrijk zijn maar zelden veranderen.
- Dennis dupliceert simpele code over services heen en vindt dat niet erg, omdat gedupliceerde code geen conflicten veroorzaakt. Ze gebruiken iets als de rule of three en extraheren pas als het patroon duidelijk hetzelfde is en bedoeld is om hetzelfde te zijn.
- Ook: het gedeelde “infrastructure”-project in een solution “dat alles bevat en waarvan niemand weet wat erin zit”.
Guidelines, analyse en skills
- Gebruik static analysis (Roslyn analyzers, JetBrains InspectCode in de pipeline), maar designbeslissingen worden daardoor niet gevangen.
- Ze gebruiken veel agent skills, bewaard in een aparte repo, al is het delen ervan een worsteling. Dennis vraagt Claude of Copilot aan het eind van een taak: “suggest improvements to the skill you used”, wat ze dagelijks doen, waardoor hun skills altijd voorlopen op die van de teamgenoten. Als teamgenoten dit ook doen, wordt een AI gebruikt om de skills samen te voegen.
- Uitzoeken waar een API-route is gemapt was moeilijk, nu vraag je het de AI in Rider en die vertelt het je.
- Streef niet naar consistentie tussen services of modules, alleen binnen een grens. Code churn beïnvloedt ook je source control history, en die is belangrijk.
Gebruik open source verantwoord
Iedereen gebruikt veel open source, vaak zonder het te beseffen. Scan je dependencies en kijk wie ze onderhoudt, naar de releasecyclus en het versieschema (de reden dat Dennis PackageGuard bouwde, dat ook naar operationele aspecten kijkt: wanneer was de laatste release, hoeveel releases loop je achter?). Van de Azure DevOps-gebruikers in de zaal gebruikten er maar ongeveer vijf Renovate, dus de meeste werken niet actief bij. (GitHub’s Dependabot is gratis.) Maar update niet te enthousiast: PackageGuard heeft een cool-down period, bijvoorbeeld drie dagen of een week wachten na een nieuwe release, voor het geval van een zero-day probleem. Definieer ook open source guidelines, zoals welke licenties zijn toegestaan.
Technical debt
In distributed systems stapelt debt zich “sneller en minder zichtbaar” op. Dennis prioriteert op blast radius: grote items gaan op de backlog, kleine krijgen “smell”/“refactor”-comments als broodkruimels in de code. Los het stapsgewijs en elke dag af (de developer of the day doet dit als er geen bugs zijn). Met Claude of Copilot is het opsplitsen van een PR in meerdere triviaal. Het is het broken window-effect: een schone, goed gedocumenteerde codebase maakt mensen huiverig om rommel te maken en “code wordt alleen maar slechter of beter”.
9. Deployment en veilige releases
Dennis sloeg hier voor de tijd een deel van over:
- Geautomatiseerde deployment pipelines die deel zijn van de service, zodat je die later kunt extraheren. Maak niet voor elke service een aparte pipeline. Dezelfde pipeline die bouwt en test, deployt ook.
- Een aparte repository per service, wat grenzen duidelijker maakt.
- Trunk-based development met kortlevende branches, en een falende pipeline meteen fixen. Accepteer nooit flaky builds of deployments.
- Feature flags om deployment van release te ontkoppelen: deploy altijd naar productie en houd geen langlopende branches. In Azure heeft App Configuration een feature-flag-sectie. Geef ze duidelijke namen en verwijder ze als de feature stabiel is.
- Blue/green- of canary-releases om het releaserisico te verkleinen.
- Deploy zo snel mogelijk. (Dennis gaf toe dat ze nog steeds elke maandagochtend alle services een voor een deployen: “Dat is triest, dat moeten we oplossen.”)
- Automatische rollback is zelfs mogelijk voor databaseschemawijzigingen, maar het is veel werk, dus pas het alleen toe waar nodig.
Dennis herinnerde zich ook verkeerslichten op kantoor die rood werden als er iets brak, waarna iedereen zijn werk liet vallen en samen een fix coördineerde.
Lessons learned
- Als je onafhankelijk schalen nodig hebt, gebruik dan microservices. Begin anders met een modular monolith.
- Chatty services zijn een design smell: heroverweeg de grens, niet het netwerk.
- Correlation IDs en structured logging zijn niet optioneel in een distributed system.
- Elke HTTP-call heeft een retry policy, een circuit breaker en een timeout nodig.
- Flaky pipelines zijn geen pipelines. Fix of verwijder flaky tests.
- Dead-letter queues hebben actieve monitoring nodig.
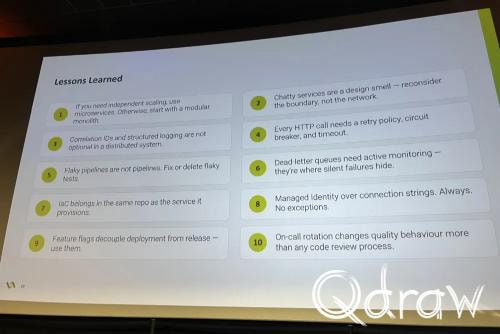
Dennis voegde toe: zet infrastructure as code (Pulumi) in dezelfde repo en deployment pipeline, gebruik managed identity in plaats van connection strings op Azure, gebruik feature flags en behoud de roulerende developer-of-the-day-rol, “daar leren mensen veel van”. De slides bevatten nog veel meer (developer experience, Azure-specifics, infrastructure as code) en Dennis was de rest van de dag in de buurt.
Quality in the Agentic Era: keeping engineering standards at AI speed
Tiago Pascoal & Josh Johanning – woensdag 09:45–10:45
Tiago Pascoal (Lissabon, Portugal) en Josh Johanning (Madison, Wisconsin, VS) zijn forward-deployed engineers bij GitHub en helpen klanten bij de adoptie van Copilot. Ongeveer de helft van de zaal gaf aan GitHub te gebruiken. De boodschap van de talk was tool-agnostisch, maar de demo’s gebruikten GitHub Copilot en alles was verpakt in een middeleeuws thema: squires, knights en golems.
Hun boodschap in één zin: engineering blijft belangrijk. AI laat ons veel sneller code schrijven, waardoor de bottleneck verschuift naar de review. Je hebt dus voor elke wijziging dezelfde kwaliteitslat nodig, ongeacht wie of wat de code schreef.
De puzzel: wat doet deze functie?
De talk opende met een functie vol magic numbers (return ((y * 1073750999) & 3221352463) <= 126976;). Tiago had de functie in een blogpost gevonden en vroeg aan Copilot wat ze deed. Met de originele naam antwoordde Copilot correct, wat indrukwekkend was. Nadat Tiago de functie hernoemd had naar o, gaf het (oudere) model een technisch correcte maar nutteloze uitleg. De les: naamgeving blijft belangrijk. Het antwoord werd beloofd aan het einde.
Engineering blijft belangrijk
De slide met de stelling citeert een tweet van Matt Pocock over een traject dat veel mensen doorlopen:
- “Oh shit, AI can do my job better than me.”
- “Software engineering is dead!”
- “I can vibe code as much slop as I want!”
- “Oh, things are not going well.”
- “But what if I constrain the agent? Put it in a straitjacket?”
- “Oh, the results are pretty good now. How do I go deeper?”
- Bestelt 12 software engineering-boeken bij Amazon.
- “Software engineering is alive!”
Snelle, performante en correcte code schrijven en complexiteit beheersen verdwijnt niet.
De bottleneck verschuift naar review
AI versnelt de implementatie, dus er komen meer wijzigingen binnen en de vraag naar review groeit. Ofwel gaan er meer mensen reviewen, ofwel worden reviewers slordiger en keuren ze blindelings goed, wat “AI slop” oplevert. Tiago haalde de Theory of Constraints (Goldratt) aan: op een lopende band optimaliseer je de bottleneck en daarna duikt de volgende op. AI heeft de bottleneck stroomafwaarts verplaatst naar de review.
“Meer code schrijven zou nooit het doel mogen zijn.” Als de code niet goed is, lever je gewoon sneller slechte dingen op en kom je er ook sneller achter. Wat telt is kwaliteit en waarde.
Wat controleren we voor het mergen?
Traditioneel: deterministische CI-checks: bouwt het, slagen de tests, linting, formatting, code quality en code scanning (GitHub Code Quality, Sonar, GitHub Advanced Security). Ze draaien op elke PR en de lat moet gelijk zijn, of een mens of AI de code schreef.
Maar een persoon reviewt nog steeds. De vragen die een review beantwoordt gaan verder dan CI: lost dit het probleem op? Past het ontwerp binnen onze architectuur, of is het een patch die werkt maar niet is hoe wij dingen doen? Horen alle wijzigingen in deze PR thuis (of zijn er te veel dingen gebundeld, waardoor rollback lastig wordt)?
Kan AI helpen bij review? Ja, met Copilot code review, zolang je je standaarden opschrijft zodat Copilot toetst aan jouw regels in plaats van een generieke review vanuit zijn training. Copilot kan ook een goedkeuringsadvies geven, maar:
- Het is een signaal, geen beslissing. Tools, deterministisch of probabilistisch, leveren enkel signalen en een of meer mensen zijn de uiteindelijke rechter. Copilot mag niet autonoom code mergen.
De slide: schrijf de regel één keer op en Copilot reviewt PR’s ertegen, via repository instructions, path-specific guidance, skills en agents.
Context: hoe help je Copilot
- Repository instructions (zoals
.github/copilot-instructions.md; andere tools gebruikenagents.mden vergelijkbare bestanden). Som geen generieke C#-best practices op die Copilot al kent, maar de standaarden van jouw team: coding guidelines, testframeworks, welke tools de code bouwen en valideren. De voorbeeldregel op de slide: “Every new API endpoint must be documented in Swagger/OpenAPI.” - Path-specific guidance: verschillende instructies voor JavaScript en C#, of voor bepaalde paden.
- Skills: laten Copilot taken effectiever uitvoeren.
- Custom agents: doelgerichte, complexere taken die orchestratie vereisen.
“Context maakt van best practices verwachtingen, voor reviewers en voor agents.”
Squire, Knight of Golem
Drie niveaus van AI-gebruik, die allemaal tot dezelfde kwaliteitslat moeten leiden:
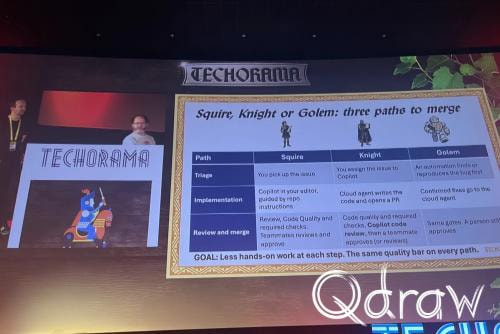
- Squire: doet het grunt work met de hand. Je triageert het issue, implementeert het handmatig in je editor en reviewt het handmatig.
- Knight: een hybride. Je wijst het issue toe aan Copilot (of gebruikt je IDE), de cloud agent schrijft de PR, tools helpen bij de review en ook een mens is betrokken.
- Golem: in de folklore een wezen van klei, een menselijke creatie die uit de hand kan lopen (de oorsprong van Frankenstein), en in moderne termen iets wat we bouwen om taken uit te voeren maar dat echt begrip mist. Hier is het volledig agentic: je maakt geen issues aan, de automations vinden ze, bijvoorbeeld door productie te monitoren op exceptions, een bug te identificeren, te reproduceren en een fix te maken, die een andere agent reviewt voordat een mens de PR accepteert.
Het doel van de slide: bij elke stap minder handwerk, met op elk pad dezelfde kwaliteitslat. “Alleen omdat de machine het doet, betekent het niet dat je het blindelings vertrouwt.”
De wet is geschreven, stuur nu de knights
Josh’ drie stappen (hoe we hier gekomen zijn):
- Bepaal wie elke standaard controleert: tools, Copilot of een persoon.
- Maak instructies levende documentatie. Ze helpen Copilot het project te begrijpen. Het is nooit “set and forget”: als een agent een fout maakt, behandel dat dan bijna als een productiedefect en verbeter het instructiebestand,
agents.md, het reviewbestand, de skills of agents. - Laat automatisering erop handelen: dezelfde lat, zonder dat iemand hoeft te wachten om het te starten. De opgeschreven context stuurt de agent en je verifieert ook de workflow die het werk toewijst en de resultaten controleert.
Manieren om automatisering te bouwen (van eenvoudigst naar complexst)
- Copilot automations (in de GitHub-app of op het tabblad Agents op het web): een cloud agent. Je kiest de scope (een issue bijwerken, een PR maken, een label toevoegen) en een trigger (aanmaken van een issue of PR, via een API, of volgens een schema). Dit is de makkelijkste manier om te beginnen.
- GitHub Agentic Workflows (public preview): iets ouder en beter uitbreidbaar, met ingebouwde safeguards. Je kunt bijvoorbeeld aangeven dat de workflow één en slechts één issuecommentaar of PR mag aanmaken, in plaats van tien PR’s te laten maken, omdat AI probabilistisch is en niet deterministisch. Er is een website met veel voorbeelden.
- Maatwerkoplossingen: GitHub Actions of Azure Pipelines met de Copilot CLI of SDK, of andere tools zoals Azure Foundry of Copilot Studio. Josh noemde een klant met een niet-GitHub CI die simpelweg de Copilot CLI downloadde en authenticeerde, prompts draaide en de output teruggaf.
Demo 1: automatische bugreproductie
Tiago demonstreerde dit op een voorbeeldrepo op GitHub (een bewust onvolmaakte demo-app “OctoCAT Supply” met een database, backend en frontend).
- Tiago maakte een issue aan: “Login page is not accessible” (de loginpagina respecteert de accessibility-tags niet), bewust kort.
- Het aanmaken triggert een automation, een “Bug repro evaluator”.
Hoe de automation is gedefinieerd:
- Triggers: issue geopend (tenzij het al een
triage-label heeft), of gelabeld als bug (tenzij het al eenreproducer run-label heeft). Er bestaan andere triggers (issue toegewezen of gesloten, pull request-events, security-events, schedules) en er komen er meer. Safeguards voorkomen dat de automation draait wanneer dat niet zinvol is. - Tools en permissies: je beperkt wat het mag doen (het issue lezen, bijwerken, labels toevoegen, reageren). Als de prompt iets vraagt waarvoor het geen permissie heeft, faalt het niet maar waarschuwt het. Je kunt MCP-servers of skills toevoegen om met andere systemen te praten. Tiago’s voorbeeld was een MCP-server voor Azure-monitoring.
- Prompt: “You are an automated Bug Triage and Reproduction Assistant. Goal: analyze a GitHub issue (title, body, and all comments), determine whether it describes a potential bug, attempt reproduction, and report results with evidence.”
De workflow: een commentaar plaatsen dat het bezig is, het issue begrijpen en classificeren (mogelijke bug of niet) op basis van de beschrijving, bedanken en om meer info vragen als het geen bug is, anders proberen het te reproduceren in meerdere omgevingen (besturingssystemen, browsers) en als bonus een fix voorstellen. Aan het einde voegt het een reproducer run-label toe en plaatst het een commentaar in een vast format, indien mogelijk met screenshots.
Resultaten: onder ongeveer tien issues liet er één, gelabeld “repro confirmed”, de oorspronkelijke beschrijving, de triage en de poging zien. Daarna wees het het issue toe aan Copilot, die een pull request met een fix opende. “No humans here” (afgezien van een verzoek om review). Een UI-issue bevatte een screenshot van de app als bewijs. Tiago’s eigen vers aangemaakte accessibility-issue kreeg als antwoord “geen bug, ik kon het niet reproduceren” (getest op Linux en Chrome), wat Tiago samenvatte als “you are wrong”.
Josh voegde toe dat het GitHub-team dat agentic workflows bouwt, zelf agentic workflows gebruikt voor triage, reproductie en fixes op feedbackissues.
De poorten van het koninkrijk: is de PR klaar?
De signalen, volgens de slide:
- Code quality: zorgt dat PR’s geen nieuwe code quality-bevindingen introduceren.
- Copilot code review: geeft een samenvatting van de wijzigingen, voorgestelde wijzigingen en een goedkeuringsadvies (een duim omhoog, nieuw in Copilot code review, of “needs work”).
- Fine-tune de review met instructies,
agents.mden eenreview.md, zodat de review zich richt op wat voor jouw team telt. - Human review: beslist of het gedrag en de afwegingen overeenkomen met de intentie.
“Review signals guide feedback; they are not executable merge rules.”
Demo 2: een (niet zo goede) PR reviewen
Tiago gebruikte een door een mens geschreven PR met een slechte beschrijving om te laten zien dat dezelfde checks voor alles gelden.
- Code coverage: je kunt een PR blokkeren als de coverage met meer dan een ingesteld percentage daalt of onder een minimum zakt. Hier steeg de coverage in de gewijzigde bestanden, terwijl het totale verschil nul was.
- Code Quality (deterministisch) markeerde een waarschuwing (een directive die niet bestaat, “je verzint maar wat”). Severities zijn configureerbaar: blokkeer bij errors, sta warnings toe. Je kunt de suggestie committen of toewijzen aan Copilot om te fixen.
- Copilot code review (niet-deterministisch) adviseerde wijzigingen in plaats van goed te keuren, met een samenvatting van de gewijzigde bestanden en vier openstaande issues (één hoog, de rest van gemiddelde ernst). Je kunt “fix with Copilot” één voor één of in batch gebruiken, of een commentaar afhandelen als je het er niet mee eens bent.
- Je kunt Copilot instellen om elke PR automatisch te reviewen, of op aanvraag (sommige teams slaan het over bij eenvoudige wijzigingen).
- Mergen wordt geblokkeerd tot alle conversaties zijn afgehandeld, van mens of Copilot. Copilot is de eerste verdedigingslinie, voordat je een teamgenoot vraagt.
Als alle checks slagen: hoort het ontwerp hier thuis?
Ook als alles groen is, stelt een persoon nog vragen (volgens de slide):
- Complexity: is de abstractie het waard? (winst op korte termijn, pijn op lange termijn: tech debt)
- Product fit: komt het endpoint overeen met bestaand gedrag? Copilot kent jouw productvisie niet.
- Diagnostics: helpen fouten het team dat on call is? (Wordt het naar de juiste plek gelogd, is het self-healing?)
- Exceptions: is het gerechtvaardigd, belegd en gedocumenteerd?
“Voorbeelden maken teamstandaarden expliciet. Een persoon beslist of de afweging past.”
Demo 3: de wekelijkse “nightly bug scout”
Een proactieve automation, waarbij Tiago eenmaal per week “de golem loslaat” (de naam zegt nightly, maar hij draait wekelijks, maandag om 7 uur) zodat mensen aankomen bij verse bevindingen.
Richtlijnen in de prompt:
- Vind en reproduceer nog niet gemelde bugs en maak bruikbare issues aan.
- Maximaal drie verschillende bugs per run. Niets vinden is geldig: “be quiet, don’t create noise”. Repareer niets, wijzig de applicatie niet.
- Probeer niet langer dan 20 minuten te gebruiken (een soft cap, want het model luistert mogelijk niet).
- Backend: kijk naar de API, servicelogica, persistentie, jobs en integraties, en grenzen, zonder browser.
- UI: start de app, verken user journeys in een echte browser en controleer accessibility en usability (inclusief toetsenbordgebruik, niet enkel de muis).
De workflow: voorbereiden, bestaande meldingen controleren, deduplicate voor het aanmaken (en bestaande issues valideren zodat bekende niet opnieuw gemeld worden), en dan publiceren met labels (backend, UI, functional, logic, integration) en een vast issueformat (titel met “bug”, symptomen, samenvatting, reproductie, bewijs). De door gebruikers gemelde reproducties zijn vaak gewoon “het werkt niet”, dus de standaard die van de agent gevraagd wordt is nauwkeuriger.
Tiago zei dat het vijf tot tien minuten kostte om aan te maken, met een limiet van ongeveer 1.000 tekens per automation, en dat je een model kunt kiezen (zij gebruikten “auto”).
Resultaat: issues met een bug-label en een label dat aangeeft dat ze door de scout gemaakt zijn. Deze triggerden de repro-automation niet, omdat een automation geen andere automations triggert, een failsafe tegen loops. Een voorbeeld meldde een probleem met mobiele navigatie bij kleine schermformaten, met reproductiestappen. Tiago’s punt: als kleine schermen by design niet ondersteund worden, zet dat dan in de instructies zodat Copilot het niet als bug indient. De scout maakte ook geen duplicaten van bestaande issues aan.
(Je kunt hetzelfde bouwen als agentic workflow of met de Copilot CLI in elk automatiseringssysteem.)
De nieuwe bottleneck: de human review gate
Wanneer triage, implementatie en geautomatiseerde review sneller worden, heeft de uiteindelijke reviewer nog steeds tijd nodig om elke PR te beoordelen. Het advies van de slide:
- Stem de output van agents af op de reviewcapaciteit.
- Als een bevinding zich herhaalt, voeg dan een betrouwbare check toe of verbeter de repositoryrichtlijnen, en verifieer dat de volgende run het opvangt voor de human review.
- Meet geaccepteerde, onderhoudbare wijzigingen, niet volume.
Voor eenvoudige repro’s en kleine fixes kun je automatisch goedkeuren, maar voor grotere zaken moet een tech lead, projectleider of product manager beslissen wat erin gaat en wanneer.
Demo 4: een dashboard in de GitHub Copilot-app
Josh liet de GitHub Copilot-app zien, een “agentic take” op werken met agents: een GUI die je sessies en threads toont, waarin agents geïsoleerd werken in git worktrees, zodat er geen botsingen zijn wanneer meerdere agents in dezelfde repo werken. Daarin bouwde Josh een canvas dat in de repository is opgeslagen (gedeeld met iedereen op de repo; er zijn ook canvases op gebruikersniveau): een pull request-dashboard met “wat is klaar om goed te keuren en waarom”. De dichtstbijzijnde kandidaat slaagde voor alle checks (CI, Copilot code review, quality, GitHub Advanced Security, scope past) maar had nog openstaande threads, en geen van de PR’s had nog een human review, wat het canvas benadrukte. Weinig mensen in de zaal hadden de app gebruikt.
En Azure DevOps?
Veel meer mensen in de zaal gebruikten Azure DevOps dan GitHub. Veel hiervan werkt daar ook, “in een andere vorm”:
- Written context: reviewrichtlijnen werken op org-, project-, repo- of padniveau en worden opgepikt door tools zoals de Copilot CLI.
- Review en agent support: een Azure DevOps MCP-server om work items op te pakken en mee te werken; Copilot code review en Copilot Autofix voor CodeQL-securityalerts zijn in preview; in een hybride opzet (code in GitHub, work items in Azure DevOps) kun je work items toewijzen aan cloud agents.
- Automated checks en signals: “Teams kiezen welke checks het mergen blokkeren. Andere leveren signalen.”
Het antwoord op de puzzel
De functie is een schrikkeljaarcontrole, uit een blogpost van Falk Hüffner (15 mei 2025) met de titel “A leap year check in three instructions”. Het is een zeer geoptimaliseerde trucje met beperkt bereik dat in drie CPU-instructies draait.
Toen Tiago een nieuwer model vroeg, zei dat, ook met de obscure naam, correct dat het een Gregoriaanse schrikkeljaartest is, geldig voor y van 0 tot en met 102.499, equivalent aan y % 4 == 0 && (y % 100 != 0 || y % 400 == 0), en legde het uit hoe de truc werkt.
Tiago vroeg of het dit gewoon uit het hoofd kende (het zit waarschijnlijk in de trainingsdata). Het model antwoordde dat het niets over zijn training wist, maar dat dit de wiskunde was waarmee het de functie analyseerde. Dit “vernietigt een beetje onze stelling”, gaven ze toe, omdat modellen steeds beter worden in het lezen van obscure code. Maar ze geloven nog steeds dat engineering en codebegrip belangrijk zijn.
Wat we geleerd hebben, en hoe je begint
- Schrijf de standaard één keer op.
- Laat begrensde automatisering handelen: geef het een gedefinieerde output (bijvoorbeeld één PR, of maximaal drie issues), de juiste context en een beperkte scope met enkel de permissies die het nodig heeft, zoals bij elke applicatie.
- Automatiseer herhaalbare checks: build, tests, linting en formatters (zoals Prettier) blijven belangrijk en geven geweldige signalen.
- Een persoon beslist. Misschien is de code goed maar nog niet klaar om te mergen (bijvoorbeeld door je deploymentplanning).
“Eén kwaliteitslat voor Squire, Knight en Golem. Een persoon neemt de uiteindelijke beslissing.”
Een eerste pilot
Josh’ suggestie: neem iets wat je developers niet graag doen (tests schrijven, documentatie bijwerken) en automatiseer een deel ervan. Zoek bijvoorbeeld wekelijks ontbrekende tests en begin er een aantal te maken, of controleer nieuwe PR’s op tests. Begin klein, evalueer, itereer en ga dan door naar het volgende probleem.
De pilotchecklist van de slide:
- Kies één repositoryworkflow en een benoemde eigenaar.
- Stel de standaarden vast voordat je begrensde automatisering toevoegt.
- Vergelijk reviewwachttijd en herwerk met je huidige workflow.
- Monitor valse alarmen en ontsnapte defecten.
Verdeling van verantwoordelijkheid (voorbeeld van de slide): toolchecks (build, lint, tests slagen), Copilot reviewt (een API-fix vermijdt niet-gerelateerde dependencywijzigingen) en een persoon beslist (lost de fix het ontwerpprobleem op?).
De sprekers bedankten het publiek, vroegen om feedback via het speakerformulier en bleven tijdens de verlengde pauze beschikbaar voor vragen.
Beyond DDD vs EA: architecting autonomous landscapes that actually scale
Dwight Matthys – woensdag 11:15–12:15
Dwight Matthys (VP of Architecture) opende met een truc die ze leenden van een spreker van de dag ervoor: een show of claps. Wie is Domain Driven Design (DDD)-practitioner? (Behoorlijk wat mensen.) Wie is enterprise architect? (Twee of drie.) Wie wordt een beetje bang als hij “enterprise architecture” hoort? Hun boodschap: niemand hoeft bang te zijn, en het heeft echt waarde om domain-driven design (DDD) en enterprise architecture (EA) samen te brengen.
Over de spreker
Dwight werkt al ruim 22 jaar in technologie, van “the trenches” (C++, C#, CORBA, COM, SOAP, WCF, REST, WinForms, WPF, Silverlight en meer) via tech lead, software architect, solution architect en domain architect naar enterprise architect en VP. Ze houden van puzzels, spelen in een band (het t-shirt was een hint) en noemden hun kinderen naar personages uit Legend of Zelda. Ze werken in de casino- en gokindustrie, dus “the stakes are real”. Ze zijn geen consultant en hebben geen framework te verkopen: “Ik ben hier gewoon om te vertellen wat er kapotgaat en soms wat wel werkt.”
Het businessdoel: time to market
Eerder dit jaar vroeg hun CTO om de time to market twee tot drie keer te verkorten. Dat is een overlevingsdoel voor het bedrijf, geen technisch doel, maar Dwight vroeg zich af hoe dat samenhangt met Domain Driven Design (DDD) en Enterprice Architecture.
Zo doen startups het: vijf briljante engineers (vaak de oprichters) bouwen en shippen gewoon in enkele dagen, zonder toestemming te vragen. Snelheid is een structurele eigenschap van het systeem, want als ze niet snel waren, gingen ze failliet. Daarna slaagt de startup en groeit ze, en neemt ze meer briljante engineers aan, en misschien enterprise architects.
De wet van Brooks, op systeemniveau
Fred Brooks (The Mythical Man-Month, 1975): mensen toevoegen aan een te laat softwareproject maakt het nog later. De wiskunde: met vijf mensen zijn er 10 communicatielijnen, met 14 mensen 91, en Dwights engineeringorganisatie telt ongeveer 190 tot 200 mensen. “Als je manager denkt dat meer mensen het sneller maken, koop hem dan dit boek.”
Twee mislukte reacties
1. Het management haalt het grote geschut erbij.
Governance via frameworks (SAFe v6, TOGAF 10, ITIL v4, Zachman, FEAF): goedbedoeld, duur en “zeer lucratief voor de mensen die het verkopen”. Ze beantwoorden het probleem met proces. Dwight maakte een grapje over “Form 7012-Bis-B”, merkte op dat SAFe v6 136 rollen en 19 ceremonies heeft, en haalde een bedrijf aan dat een illustrator 200.000 dollar betaalde voor één tekening in een strategiepresentatie van 287 slides. Niemand ging er sneller van werken.
2. Engineering duwt terug.
Engineers schetsen op whiteboards en besluiten het landschap op te delen in domeinen op basis van zelfstandige naamwoorden (Game, Player, Payment, Betting Odd, Communication, Shop). Goedbedoeld, briljante mensen, een andere invalshoek op hetzelfde probleem. Maar de stukken moeten nog steeds met elkaar communiceren, en het resultaat lijkt op de dependency graphs van microservices die mensen met een Death Star vergelijken: “de mandala op steroïden”.
Twee uitersten in spanning
Met een techniek uit het boek No Rules Rules (Netflix) zette Dwight de twee benaderingen tegenover elkaar:
- Rules: governance boards, approval gates, review cycles, comités. “Traag by design: elke gate is een dependency.” Verkeerd uitgevoerde governance is coupling in vermomming.
- Rock ‘n’ roll: autonome teams, “no guardrails” (ze hebben natuurlijk wel CI/CD), snel shippen, later uitzoeken. “Snel, tot het niet meer snel is.” Bij microservices verhuist de coupling naar de netwerklaag: latency is niet nul en services vallen uit. Verkeerd uitgevoerde autonomie is ook coupling in vermomming.
Geen van beide leverde time to market op: de ene zat vanaf het begin in een bottleneck en de andere uiteindelijk. Zo eindigen bedrijven met een monoliet, of erger, een distributed monolith. Wat schaalt er dan wel?
Oorlogsverhaal 1: toen de Enterprice Architect afwezig was
Bij het casinobedrijf verkopen ze games van game providers, en spelers spelen erop. Finance vond niet dat ze enterprise architecture nodig hadden. Om gametransacties af te stemmen op facturen van leveranciers moest Finance weten welke game welke was, dus:
- Dupliceerden ze de data van de gamecatalogus. De catalogus heeft ingewikkelde deduplicatieregels, dus ze deden het fout.
- Bouwden ze een billing engine in Finance, terwijl de complexe regels bij de casinomanagers horen, die de deals met providers onderhandelen (bijvoorbeeld 15% extra korting als jouw game een maand lang op plek vijf staat).
De slide toont een casinoflow (speler start game, gametransactie wordt vastgelegd, billing ontbreekt) en Finance met het verkeerde eigenaarschap: de gamecatalogus in Finance, de billing engine daar gebouwd, en gedupliceerde data. De gevolgen: games die het casino live had gezet en waarop spelers hadden gespeeld, werden mogelijk niet herkend in de catalogus van Finance, waardoor het afsluitproces van de CFO stilvalt.
Dwight werd twee weken voor go-live erbij gehaald. Een snelle schets van de capabilities liet zien dat het niet klaar zou zijn, en het project moest van nul opnieuw beginnen. De oplossing: de gamecatalogus wordt beheerd door Casino, en de billing engine verhuisde (omstreden) naar Casino omdat zij de intrinsieke regels kennen, zodat billing een first-class capability wordt, in handen van de juiste mensen met de juiste data.
“Een capability map had Billing benoemd voordat er één regel code was geschreven.” Enterprise architects zien het landschap dat niemand anders ziet, inclusief duplicatie, terwijl mensen binnen een systeem de neiging hebben vooral binnen dat systeem te kijken. Maar: “de kaart kwam na het terrein”. Het instinct was juist, ze waren alleen te laat.
Oorlogsverhaal 2: toen Enterprice Architectuur en DDD (Domain driven design) allebei in de kamer zaten
In een ander project (in Malaga) keek Enterprice Architectuur, “vanuit de ivoren toren”, naar de capability map en zei: bouw een Sales Order-domein. De teams namen dat voor waar aan en pasten DDD (Domain driven design) toe (event storming, grenzen tekenen), en er ontstonden twee domeinen: Customer Basket en Sales Order. Toen ze terugkwamen bij Enterprice Architectuur, zeiden ze nee: “dat is een front-endprobleem”. De engineers gingen toch door (“wat doen engineers als Enterprice Architectuur zegt dat ze iets niet moeten doen? Ze doen het gewoon”).
De slide toont de sales funnel: één journey over meerdere domeinen, de klant browst, een item wordt geselecteerd, de basket wordt bevestigd, de sales order wordt aangemaakt en bevestigd, de factuur wordt getriggerd.
Het resultaat: dataduplicatie en coupling. Alle data in de basket moest worden gedupliceerd naar de sales order, ze omzeilden zelfs een enterprise service bus om het te verplaatsen, en het ene team kon niets wijzigen zonder met het andere te overleggen. “Hoeveel van jullie denken dat dat een eigenschap is van snel zijn?”
Op een avond besefte Dwight dat de lijn fout was (die had horizontaal in plaats van verticaal gesneden moeten worden): het domein duwde terug. Ze hadden het model als vaststaand geaccepteerd, “een hypothese behandeld als een verklaring”. Evans zelf zegt dat het model een hypothese is, geen verklaring, en dat het zal evolueren.
Een slide vatte het samen: de grens was een startpunt, ze behandelden die als bestemming. Een tweede slide: Enterprice Architectuur miste het domein, Domain Driven Design miste het landschap: geen van beide was ontworpen om te zien wat de ander ziet.
De les: in het eerste verhaal miste Enterprice Architectuur het domein. In het tweede misten de Domain Driven Design-practitioners het landschap. Geen van beide disciplines is fout: “geen van beide was ontworpen om te zien wat de ander ziet, en precies in die blinde vlek verstopt de coupling zich.” De regel op de slide: Enterprice Architectuur zonder domeinkennis is een kaart zonder terrein. Domain Driven Design (DDD) zonder landschapsoverzicht trekt grenzen in het donker.
Evans deed de hele tijd al enterprise architecture
Een bounded context (Eric Evans) is een context waarin een model geldt, met drie rollen:
- Isolation boundary: wat erbinnen leeft blijft schoon, wat de grens oversteekt is expliciet.
- Coherence boundary: het model klopt als geheel. (“Favourites” betekent favoriete games in gameplay en favoriete betaalmethodes in payment: één model om ze allemaal te regeren werkt niet.)
- Autonomy boundary: zodat teams kunnen bewegen zonder 22 mensen te bellen.
“Trek de grens verkeerd en je breekt het model, en het vermogen van het team om te bewegen.”
Business capabilities beschrijven wat een bedrijf doet, niet hoe. Bijvoorbeeld: inchecken bij een luchtvaartmaatschappij bestond in 1980 (uren in de rij) en bestaat vandaag (online inchecken): de capability is dezelfde, maar anders gerealiseerd. Door capabilities te articuleren en uit te dagen kun je eigenaarschap bij één team leggen, en cartografie is “de echte voorwaarde voor autonomie”, zolang je de kaart als hypothese behandelt.
De slide stelt de twee werelden aan elkaar gelijk:
| Domain Driven Design (DDD) | Enterprice Architectuur |
|---|---|
| Bounded context | Level 1 capability |
| Context map | Capability map + integration stack |
| Integration pattern | Integration interface |
Samen: evolvability
Door ze te combineren krijg je evolvability: het vermogen om te veranderen zonder toestemming te vragen.
- Domain Driven Design (DDD) brengt nederigheid (laat het domein spreken, pas je kaart aan) en denken en eigenaarschap op teamniveau.
- Enterprice Architectuur brengt het grotere plaatje (zodat je het landschap aan een chief marketing officer kunt uitleggen in marketingtermen), capability mapping en computational governance, een idee uit data mesh: governanceregels die berekenbaar zijn, deel uitmaken van de pipelines en automatisch worden uitgevoerd, en waar mensen tegenin kunnen gaan. Dwights organisatie zet governanceregels om in computationele regels.
“Geen van beide is compleet op zichzelf. Samen: een houding, geen framework.” Autonomie is een enabler richting dat doel, en architectuur zou niet over controle moeten gaan, maar over het ontwerpen van de regels, omstandigheden en beperkingen waarbinnen ontwerpen kunnen worden gemaakt en kunnen evolueren.
De wet van Conway en de inverse manoeuvre
Organisaties produceren ontwerpen die hun communicatiestructuren kopiëren. Als een bedrijf met zeven teams zeven onderdelen krijgt, heeft het systeem dezelfde coupling als de organisatie. Je architectuur weerspiegelt je organisatie, of je dat nu gepland hebt of niet.
De meeste organisaties ontwerpen het systeem, hopen dat de organisatie zich aanpast (dat gebeurt niet, want managers geven zelden territorium op), zien de coupling oplopen, reorganiseren en herhalen. De inverse manoeuvre: ontwerp eerst de teamgrenzen, om bewust de architectuur te produceren die je wilt. “Conway is een wet, geen suggestie. Gebruik hem met opzet.”
En de wet van Brooks geldt ook op systeemniveau: elk integration pattern is een coördinatiecontract tussen teams, en die overhead stapelt zich op. “Coupling is geen technische smell. Het is een organisatorische belasting.”
De prime directive: autonomie versus coupling
Dwight toonde een schaal van zero coupling (maximale autonomie) tot kritieke coupling. Elk integration pattern dat je kiest schuift een markering naar rechts en heeft een coördinatieprijs. De beste integratie is “degene die niet bestaat”, net zoals de beste code de code is die je niet schrijft. Ze liepen de niveaus door.
Level 00: geen integratie
Daag eerst de domeingrens uit. Voorbeeld: iedereen ging ervan uit dat de deposit limit moest praten met het player profile. Maar de limiet leeft eigenlijk in het Payment-domein. Verplaats hem daarheen en de integratie verdwijnt. Dit sluit aan bij de anti-requirements van Udi Dahan: waarom zou een kortingsdomein zich druk maken over of iemand Dwight heet of een naam van zes letters heeft? “Eerst anti-requirements. Dan pas integratie.”
Level 01: visuele compositie (micro-frontends)
Als de gebruiker data van twee capabilities alleen maar samen moet zien (de deposit limit en profielinformatie), hoeft de data niet te reizen, alleen de presentatie. Bouw micro-frontends die samenkomen in de shell- of channellaag. Elke capability bezit haar eigen UI-stuk volledig, met behavioural contracts, geen data contracts. Dwight geeft de voorkeur aan teams die zowel de pixels als de API’s bezitten, en waarschuwt voor een apart “webteam”, dat niet autonoom is.
Level 02: niet-visuele compositie
Wanneer je gecoördineerde dataopvraging nodig hebt (kolommen in een grid, dashboards), kun je niet van elke cel een micro-frontend maken. Een coördinerende (niet-visuele) component haalt data op bij meerdere capabilities. Dat vraagt om expliciete afstemming tussen teams over het contract.
Level 03: event-driven (async)
Als je moet reageren op iets wat in een ander domein is gebeurd zonder dat te controleren, gebruik je business events (“tell, don’t ask”), zoals PlayerSessionEnded { playerId, sessionTxId }. Een licht contract: een polyseme-identifier, timestamp, correlation ID en minimale feitelijke data. Geen domeinlogica, geen commands, geen verwachtingen. (Geen event sourcing, en geen events die elk detail meedragen.) Een jackpotdomein dat gameplay observeert, zou “speler heeft de jackpot gewonnen” kunnen uitsturen met een speler-ID en timestamp, en verder niets. Het is vrij autonoom, maar je moet nog steeds contracten onderhouden (en versioneren). Het blijft communicatie-overhead.
Een polyseme is een concept op landschapsniveau, een gedistribueerde entiteit die over domeingrenzen is opgedeeld en door één identifier bij elkaar wordt gehouden. Het is geen shared model. Het heeft een naam, een identifier en open context. Voorbeeld: ShopSaleTransactionId, niet txId: de naam codeert de eigenaar en de context. “Dat is ubiquitous language op landschapsniveau.”
Level 04 en verder
Dwight beschreef de volgende stappen, waarin een domein een ander domein nodig heeft om echt werk te doen (bijvoorbeeld gameplay die vraagt of een speler mag spelen), wat niet met events op te lossen is als je een consistent antwoord nodig hebt. Hier gebruiken ze governance patterns uitgedrukt als templates die computationeel zijn, zichtbaar in je repositories, want “hoe meer je naar rechts schuift, hoe meer je hier een viewpoint op wilt, omdat het autonomie en snelheid raakt”. (Deze stap is niet op de foto’s vastgelegd, dus de details ontbreken.)
Level 05: managed coupling: hub and spoke
Wanneer je de data van een ander domein nodig hebt op een manier die dat domein beheerst en begrijpt (Dwight noemde ERP-achtige consumenten zoals SAP, die veel meer data willen dan ze nodig hebben), orkestreert een hub, en de spokes stellen data beschikbaar als first-class surface in handen van hun domein, met zeer specifieke contracten voor die use case. Omdat die gestandaardiseerd en vindbaar in het landschap kunnen zijn, kun je het contract verwijderen wanneer de consumerende use case verdwijnt: “geen API’s meer, niet meer afvragen of iemand ze gebruikt”.
Vanaf hier: autonomie is aanzienlijk aangetast
“In Legend of Zelda zeggen ze: waag je hier niet.” Dat betekent niet nooit, het betekent: weet je het zeker? Elke stap hier is een bewuste afweging: motiveer hem, voel de kosten, benoem ze.
- Level 06, hoge coupling: data-rijke domain events. Rijke interne events delen over een grens heen. Het contract is zwaar en de coupling echt en groeiend. Het “moet elke keer een bewuste, gemotiveerde beslissing zijn. Geen gemak. Geen default.”
- Level 07, hoge coupling: directe API-/RPC-coupling. Eén domein hangt synchroon af van de API van een ander: van de beschikbaarheid, het contract en de versiecyclus. Elke wijziging van de producer kan de consumer breken, elke deployment is een coördinatiemoment, en er ontstaan availability chains. Als een domein dat je nodig hebt down is, raak je mogelijk je kernprocessen die omzet genereren. Version drift stapelt zich ongemerkt op, en een “API version drift checker” kan die zichtbaar maken: de afstand tussen de versie van de consumer en de huidige versie van de producer.
- Level 09, kritieke coupling: databasecoupling. “Legacy, noodgreep of technical debt? Noem het bij de naam. Geen pattern. Een wond.” Als twee capabilities een database delen, rimpelen schemawijzigingen door zonder contract, zonder grens en zonder onderhandeling: “gewoon shared state”. Dwight vond ooit 39 databases die in een wiel aan elkaar gekoppeld waren. Zit je hier, benoem het dan expliciet, neem het eigenaarschap op het hoogste niveau en plan de exit.
Takeaways
- Snelheid moet een structurele eigenschap zijn, geen managementinstructie of proces.
- Behandel grenzen en capability maps als hypotheses, en laat het domein terugduwen.
- Combineer het landschapsoverzicht van Enterprice Architectuur met de domeinkennis van Domain Driven Design (DDD): evolvability is “het vermogen om te veranderen zonder toestemming te vragen”.
- Daag grenzen en requirements uit voordat je integratie toevoegt. Blijf zo dicht mogelijk bij zero coupling en motiveer elke stap daarvan weg.
- Coupling is een organisatorische belasting, dus gebruik de wet van Conway met opzet.
- Maak governance computationeel, zodat ze draait en uitgedaagd kan worden.
Dwight schrijft een boek met de titel Architecting Autonomy (“beyond DDD vs EA: the principles, the patterns, the practice”), waarvan ze verwachtten dat ze bij hoofdstuk 10 zouden zijn, maar ze zitten pas bij hoofdstuk 1.
Local-first AI development: sovereignty, silicon and the private dev loop
Brian Randell – woensdag 13:15–14:15
Brian Randell is partner bij MCW Technologies en werkte ongeveer vier jaar met GitHub. Ze opende met de belofte van “een eerlijke mening, geen marketingpraat”. Om de eigen beweringen te testen kocht Brian flink wat hardware. De slides en benchmarkdata staan op GitHub (github.com/brianrandell/localllmtests, plus een repo met de demo’s) en op essentialdevops.org.
De datum die de vraag veranderde: 12 juni 2026
Brian begon met een datum en vroeg wat er toen gebeurde. Volgens hun verhaal sneed de Amerikaanse overheid op 12 juni 2026 voor iedereen de toegang af tot een nieuw, krachtig model van Anthropic, niet alleen buiten de VS. Een paar weken later kwam het terug voor sommigen, maar de meeste mensen hebben nog altijd geen toegang tot het meest beperkte model en het model dat wel beschikbaar is, heeft beperkingen waar je “misschien niet helemaal blij van wordt”. Voor wie erop gebouwd had, ging de les over vendor exposure.
De slide vat de verschuiving samen: in 2024 was local AI een hobby met een reserve-GPU en in 2026 is het een beslissing die gereguleerde teams moeten nemen: “De vraag is niet langer ‘kan ik het’, maar ‘waar moet het draaien’.” De slide aan het einde van de talk merkt op dat teams die deze keuze al bewust hadden gemaakt, 12 juni niet eens opmerkten.
Twee zinnen om te onthouden:
- Het model is een commodity input. De echte keuzes zijn waar het draait, wat dat kost en hoe je het verwisselt zonder de app te herschrijven.
- Local is eerst een policy-beslissing en pas daarna een hardwarebeslissing.
Brian vergeleek de modelmarkt met de maakindustrie: China besteedt aan modellen dezelfde toewijding als aan het goedkoper produceren van spullen en elk land wil dat de eigen burgers toegang hebben tot AI-technologie, dus er komen steeds meer modellen uit steeds meer plekken. (Sommige organisaties trainen ook hun eigen modellen, maar dat viel buiten de scope.)
Deel 1: Sovereignty, waarom de prompt de deur niet uit mag
Vier drijfveren voor local, “in volgorde van hoe vaak ze de echte reden zijn, in tegenstelling tot de opgegeven reden”:
- Broncode en eigen prompts. “Source” in de ruimste zin: niet alleen de code van ontwikkelaars, maar alle data die gebruikers invoeren in AI-extensies en chatinterfaces in jouw applicaties. De zorg is niet alleen of een provider erop traint. Het gaat ook om de dag waarop legal zegt “we hebben een dagvaarding gekregen, stuur ons de logs van vorige maand”, plus je retentieregels. Mensen vertellen chatbots ook dingen die ze nooit in een e-mail zouden zetten en ze doen dat op werksystemen, bijvoorbeeld als hun gratis account op is.
- Dataresidentie en wetgeving.
- Vendor exposure, zoals 12 juni liet zien. Als je ontwerp op één provider leunt, sta je met lege handen als die verdwijnt.
- Voorspelbare uitgaven. Providers veranderen hun tokenmodellen (“token maxing”) en finance wil voorspelbaarheid. Een capital expense voor hardware die overeenkomt met een aantal tokens is iets wat accountants en aandeelhouders begrijpen. Microsoft werkt ook aan het standaard combineren van local en cloud (hun “Hybrid”-aanpak), want de grote providers kunnen compute ook niet cadeau blijven doen.
De wet, zoals die deze maand geldt
De slide (data gecontroleerd op 23 oktober 2026, “geen juridisch advies”; Brian zei ook geen jurist te zijn):
- GDPR: een prompt met persoonsgegevens is een verwerking. De modelprovider is een verwerker of subverwerker. De doorgifteregels gelden voor de API-call precies zoals ze gelden voor een databasereplica.
- EU AI Act, artikel 50: transparantieverplichtingen die sinds 2 augustus 2026 gelden (zeg dat het AI is; markeer gegenereerde output machineleesbaar). De AI Omnibus (Verordening (EU) 2026/1744, van kracht sinds 27 juli 2026) schoof de verplichtingen voor high-risk op naar 2 december 2027 (Annex III) en 2 augustus 2028 (Annex I). Artikel 50 werd niet uitgesteld, behalve het markeren voor bestaande generatieve systemen, dat naar 2 december 2026 ging.
- US CLOUD Act (2018): een Amerikaanse provider kan gedwongen worden data te leveren die onder zijn beheer valt, waar de server ook staat. Daarom verkoopt elke hyperscaler nu een sovereign-cloud-variant (alleen EU-operatie, soms met een Europese rechtspersoon ertussen). Of dat je toezichthouder tevredenstelt, is een vraag voor je juristen.
Brian gaf het voorbeeld van Microsofts Duitse sovereign cloud (in samenwerking met Deutsche Telekom als beherende rechtspersoon) en merkte op dat sovereign regions “geen wondermiddel zijn” (ze noemden de poging van het VK om Apple te dwingen tot toegang tot versleutelde data), “maar wel een goed begin”.
Provider of deployer?
De eigen terminologie van de AI Act: een provider bouwt een AI-systeem, brengt het op de markt en draagt de meeste zware verplichtingen (conformiteit, documentatie, markering). Een deployer gebruikt het onder eigen verantwoordelijkheid en de meeste teams die een API aanroepen, zitten hier, met transparantieplichten als het systeem met mensen in aanraking komt. Er is nog weinig jurisprudentie en de waarschuwing op de slide: als je een open-weight model fine-tunet, in je product verpakt en onder je eigen merk uitlevert, ben je langs deze lijn opgeschoven. “Lokaal draaien laat de regelgeving niet verdwijnen, het verandert wie hem draagt. Maak die afweging bewust.”
De policy page
De uitkomst van de policy-beslissing is één pagina, geschreven voordat je iets koopt: voor elk soort content welke route is toegestaan (frontier API, cloud in een sovereign region of hardware die je zelf beheert). Brians voorbeeldrij: “Broncode uit klantrepositories: alleen local of sovereign region, alleen door frontier-modellen te reviewen met schriftelijke toestemming van de klant.” Veel mensen in de zaal kunnen deze beslissing niet zelf nemen, dus je moet opwaarts managen richting directeuren, de C-suite en legal. Denk ook aan wat je klanten je toestaan te doen met hun informatie.
Deel 2: Silicon, wat het kost, gemeten
Brian bouwde gedurende enkele maanden een benchmarksuite (nog bijgewerkt op de dag ervoor), gericht op Windows (CUDA 13) en macOS (Metal) (ze houden van Linux, maar hadden maar beperkt tijd).
Methode, want “een benchmark zonder methode is een advertentie”:
- Workload:
llama-benchmet prompts van ongeveer 2.000 tokens en 512 gegenereerde tokens, 10 herhalingen, om ontwikkelaarsprompts te simuleren. Dezelfde GGUF-bestanden, geverifieerd als byte-identiek (ze vonden ooit een verschil). Een groot voordeel van lokale modellen is dat je het exacte model kunt vastpinnen voor reproduceerbare evaluations, terwijl gehoste modellen worden aangepast (“op Reddit juichen mensen over een nieuwe release en een paar dagen later is hij ‘generfd’”). - Twee getallen, één woord: prefill (tokens per seconde waarmee je prompt wordt gelezen) en decode (tokens per seconde waarmee het antwoord wordt geschreven), en het woord is fits: de modelgewichten moeten in het geheugen passen, plus de overhead van het draaien van de machine (vooral een laptop), plus ruimte voor denken en context. Let op de grootte van nieuwe modellen.
De bevinding die alles ordent
Decodesnelheid volgt de geheugenbandbreedte. Niets anders op het spec sheet voorspelt hem. De grafiek zet de decodesnelheid af tegen de geheugenbandbreedte van elk apparaat. Een Core Ultra 9 CPU met ongeveer 90 GB/s haalt bijvoorbeeld zo’n 15 tokens per seconde op het kleine Llama-model, een M3 Max (400 GB/s) ongeveer 60 en een M5 Max (614 GB/s) ongeveer 89, terwijl de klasse van 1.792 GB/s (RTX 5090, RTX PRO 6000) boven de 200 uitkomt.
Wat de hardware wel en niet is
Brians geteste bereik omvatte een Intel Ultra 9, een M3 Max en M5 Max, een RTX 2080 (te oud, want de software is doorgeschoven), een RTX 3090 en 4090, een RTX 5090 en een RTX PRO 6000 (vorig jaar ongeveer 8.000-9.000 euro en dit jaar volgens Brian 15.000-18.000). De RTX-kaarten zijn ontworpen voor gamers, niet voor AI, en mensen posten foto’s van gesmolten connectoren, dus er een hele dag vol gas op draaien is een risico, terwijl de PRO-lijn bedoeld is om altijd te draaien. Een waarschuwend zijpad: Brian maakte het eigen moederbord kapot met statische elektriciteit, en daarom draaide de PRO 6000 tijdens de benchmarks als externe GPU (eGPU).
RTX 5090 versus RTX PRO 6000 versus M5 Max versus een M5 Ultra Mac Studio: bij dezelfde geheugenbandbreedte krijg je dezelfde decodesnelheid en je betaalt voor de andere 64 GB.
“Geheugencapaciteit bepaalt het model. Bandbreedte bepaalt de snelheid. Koop in die volgorde.” De fit-tabel laat zien welke modellen op welk apparaat draaien (een model met een kruisje past niet, “niet langzaam, maar iets anders en slechters”). Kerncijfers van de slide voor decode in tokens per seconde:
| Apparaat | gpt-oss-120b | Qwen 3.5 122B |
|---|---|---|
| RTX PRO 6000 (eGPU) | 182 | 90 |
| M5 Max | 93 | 35 |
| M3 Max | 61 | 21 |
| AMD HX 370 (Radeon 890M) | 15 | 17 (alleen CPU) |
Brians visie: 24 GB lijkt genoeg, maar dan komen er modelgewichten, het scherm en context bij, dus de praktische sweet spot begint rond 32 GB en hoger. Piepkleine apparaten (de M6 mini was een voorbeeld) geven geen bevredigende codeerervaring. Machines met unified memory, zoals Apple Silicon en de AMD- en Snapdragon-laptops, openen de deur naar grote modellen. En “sneller is niet altijd een voordeel”: als je baas de snelste hardware koopt, verwacht die dat jij sneller bent, terwijl tragere hardware je meer tijd geeft om na te denken (de XKCD “compiling, carry on” wordt “prompting, carry on”).
Brians eerste observatie over de nieuwe Surface-laptop op basis van Snapdragon die ze vooraf hadden besteld: gepubliceerde data suggereerde dat die voor AI-werk langzamer was dan de M5 Max, wat niet was wat ze hadden gehoopt van een machine op basis van NVIDIA. Ze zeiden dat ze het zelf zouden testen.
Prefill is compute, decode is bandbreedte
Over 14 modellen, de PRO 6000 versus de M5 Max: prefill 9 tot 16 keer sneller op dense modellen (3 tot 6 keer bij mixture-of-experts), maar decode slechts ongeveer 2,3 tot 2,6 keer sneller op dense modellen (de verhouding in specbandbreedte is 2,9). Een groot model van schijf laden telt ook mee en Brian merkte op dat de prijzen van SSD’s zijn geëxplodeerd: een 8 TB PCIe Gen 5 SSD die ze op Black Friday 2025 voor $799 kochten, stond op ongeveer $3.000.
Mixture of experts verandert de aankoop
Een MoE-model “heeft het geheugen nodig van zijn totale omvang en draait op de snelheid van zijn actieve omvang”, dus een grote MoE kan verrassend snel zijn op een machine met veel geheugen.
De eGPU-tax
Een kaart van 96 GB aan een laptop koppelen is een manier om met een beperkt budget de markt op te gaan en het werkt, maar het kost iets: 3DMark onderschat de straf met een factor 2,5 (raster -7,6% tegenover LLM-decode -19,1% op dezelfde verbinding en kaart), dus dimensioneer een dock niet met een gamebenchmark. Thunderbolt 5 en USB4 v2 presteerden gelijk (binnen 3% van elkaar). Brian meldde ook dat voor de Blackwell-kaarten alleen Thunderbolt-behuizingen werkten en dat OcuLink- en USB4 v2-docks in hun lab faalden.
Eén ontwikkelaar of een team
Voor één gebruiker (“batch 1”) is de PRO 6000 maar ongeveer 2,5 keer sneller dan de M5 Max en is de laptop een serieuze optie. Maar met concurrency verandert het beeld: bij prefill is het verschil 10 tot 15 keer en bij 16 gelijktijdige sequences ging de kaart van 64 naar 639 tokens per seconde in totaal, waarbij elke gebruiker nog steeds op ongeveer 40 tokens per seconde zat (ongeveer 10 keer). Daarom kopen datacenters NVIDIA en geen Macs: kopen voor één ontwikkelaar is een andere beslissing dan kopen voor een team, en de serving-software verandert ook mee.
Demo 1: hetzelfde model, twee machines
Brian draaide dezelfde prompt (“Explain the difference between prefill and decode in LLM inference to a .NET developer in eight sentences”) op gpt-oss:120b met Ollama op de M5 Max-laptop (128 GB) en op de RTX PRO 6000 (96 GB) thuis via RDP.
Resultaat: ongeveer 84 tokens per seconde voor decode op de laptop tegenover ongeveer 183 op de PRO 6000 (de totale duur was 5,3 seconden tegenover 2,3 seconden) en prompt processing van ongeveer 131 tegenover 1.711 tokens per seconde. “Kijk naar het tempo, niet naar de woorden: minder dan de helft van de snelheid, in een tas, met hetzelfde model.” De engine maakt uit: Ollama is de makkelijkere ervaring, maar llama.cpp eronder geeft meer controle en op Linux haal je er meer uit.
Deel 3: De private developer loop
Modelkeuze per taak
Namen per 23 oktober 2026, “over zes maanden zijn ze anders, dat is juist het punt van de seam”. Open-weight opties op de slide:
| Taak | Voorbeelden | Geheugen |
|---|---|---|
| Coding | Qwen 2.5 Coder 32B, gpt-oss-20b en 120b, Qwen 3.x Coder MoE, MAI Code 1.1 Flash | 24 tot 96 GB |
| Chat en reasoning | Qwen 3.5-familie (4B tot 122B), Gemma 4, Llama 3.3 70B | 8 tot 128 GB |
| Embeddings | nomic-embed-text, qwen3-embedding | elk |
| Vision en documenten | Gemma 4, Qwen 3.5 | 16 GB en meer |
Regel één: match het model met de sport op de capaciteitsladder die je echt kunt draaien. Regel twee: evalueer op je eigen taken, met je eigen prompts, voordat je een leaderboard vertrouwt, “deze inclusief”. (Brian waarschuwde ook dat de CEO’s van de grote AI-bedrijven bezwaren uiten tegen open modellen, wat ze zelfbedienend vinden.)
Hosting: vier runtimes, één interface
Ollama, LM Studio, Foundry Local (van Microsoft) en llama-server spreken allemaal het OpenAI chat-completions-protocol op een lokale poort, “dat is de seam”, dus voor applicatiecode maakt de keuze nauwelijks uit. Ollama begon als een CLI die llama.cpp makkelijker maakte en Brian was kritisch over de opeenhoping van features en een cloudaanbod (“enshittification”). Foundry Local is gebouwd door Microsoft-mensen die “wisten dat de kosten uit de hand zouden lopen”.
De seam in .NET: IChatClient
In .NET zorgt de IChatClient-abstractie ervoor dat de applicatie nooit een provider ziet. “Local of cloud” en “welk model” worden regels in appsettings, per omgeving, klant of repository in te stellen, en dat is precies wat de policy page vroeg.
Copilot, BYOK en on-device: de eerlijke stand van zaken
- VS Code: bring your own model in Chat- en Agent-modus via de Ollama-extensie, de Foundry Toolkit-extensie of een custom endpoint. Niet voor inline completions (die blijven op de modellen van GitHub). Er is een adminpolicy op Business en Enterprise (standaard aan). De ingebouwde Ollama-provider is deprecated, gebruik de extensie.
- Visual Studio 2026: bring your own model alleen in “Agent (Preview)” (Microsoft Foundry, OpenAI, Anthropic, Ollama). De eerdere Ask- en Agent-BYOM-integratie is in september verwijderd.
- On-device, experimenteel: MAI Code 1.1 Flash (137B MoE, 6,8B actief, ongeveer 53 GB), dat llama.cpp b11658 of nieuwer nodig heeft en een NVIDIA-GPU met 96 GB of meer (unified memory telt mee) plus Copilot-aanmelding. Het zit in een beperkte rollout sinds eind oktober 2026, waarbij “Auto” kan schakelen tussen dit model en de cloud. “Told, not shown, juist daarom.”
Hybrid by policy, niet per ongeluk
De inner loop (editor, agent, tests: “tweehonderd keer per dag met je code in de context”) draait local: “snel genoeg, privé door ontwerp, gratis aan de marge”. De outer loop (pull request, review, CI-gate) gebruikt frontier-modellen “waar frontier-capaciteit haar kosten waard is en er al een mens in de loop zit”. Daartussen zit de policy page: welke rijen mogen de grens over, per klant, per repository. “Hybrid by Auto is hybrid volgens het beleid van iemand anders. Pin het vast.”
Brian wees Europese teams ook op een retentiedetail: bij nieuwere Claude-modellen is er volgens hen een retentieperiode van 30 dagen bij de provider, wat misschien niet past bij je wettelijke verplichtingen (terwijl oudere Claude Code-ontwerpen prompts als vluchtig behandelden). Met bring-your-own-key in Copilot kun je een leverancier kiezen die je vertrouwt, zoals Mistral.
Agents zijn een supply chain
Hackerbot-Claw was een AI-agent die CI-pipelines vond en uitbuitte: een patroonindex van 9 klassen en 47 subpatronen, een proof of concept per doelwit, itererend op mislukkingen, tegen doelwitten waaronder Microsoft, Datadog, CNCF-projecten en Trivy. Of je nu local of frontier-modellen gebruikt, als je data levert aan een AI-oplossing ben je wettelijk aansprakelijk.
“De keten is langer geworden. De mitigaties niet, op één na.” De vijf nieuwe inputs (elk een dependency) zijn instructiebestanden in de repository, skills, MCP-servers (packages die draaien met de rechten van de agent), modellen (als je ze zelf host: code met gewichten eraan) en toolpermissies. Dezelfde pijlers gelden, plus sandboxing: geef de agent een eigen scoped identity (niet de jouwe), review agentconfiguratie zoals een workflowbestand (met hooks voor een deterministische log), pin en allow-list servers en modellen en draai nooit zonder sandbox, want “een agent is onbetrouwbare code die je zelf hebt uitgenodigd”. (Bron op de slide: Threats from the Shadows, 2026.)
Demo 2: de inner loop, volledig lokaal
In VS Code opende Brian Copilot chat in agent mode en koos een lokaal Qwen coder-model (30B) dat door Ollama op de MacBook Pro werd geserveerd (context tot 262.000 tokens). Met een opgeslagen prompt vroegen ze het een klein .NET-programma zo aan te passen dat het de prompt als command-line-argument accepteert. De agent paste de code aan, draaide de build, schreef en draaide een test, “en niets verliet mijn machine”. Je kon de ventilatoren van de laptop horen: “just get some AI, you can make them scream”. Een complexere poging eerder met een library (Polly) liep “strak gespannen” vast en vereiste dat Brian ingreep, daarom was het een eenvoudigere demo. Brians eigen stijl is “in the loop”, waarbij meekijken prima is, ook als het niet super snel gaat.
Ze noemden beperkingen: lokale modellen hebben sturing nodig via configuratiebestanden en skills, schrijven soms code die niet de beste of veiligste is en kennen geen CVE’s die na de training zijn gevonden. Vandaar de hybrid: commit en push, en laat dan Copilot code review in de cloud de pull request beoordelen, met controle over welk model het gebruikt, tegen aparte kosten.
Demo 3: wissel het endpoint, geen code aangepast
Dezelfde app, gebouwd op IChatClient, draaide eerst tegen Ollama op de laptop (ongeveer 1,5 seconde voor 27 tokens in en 151 uit) en daarna tegen een model op Azure OpenAI in West US (ongeveer 2 seconden, 26 tokens in en 68 uit), na authenticatie met een managed identity-token (“we slaan geen API-keys op waar ze geëxfiltreerd kunnen worden”). “Eén commando. Dezelfde prompt, ander antwoord, ander continent. De applicatie veranderde niet. De build veranderde niet.” Brian merkte op dat de modellen verschilden, dus het was geen eerlijke vergelijking, maar met opties als Mistral kun je hetzelfde model lokaal en in de cloud draaien.
Drie maten van local
- Tier 1, één apparaat: capaciteit voor de sport die je nodig hebt, dan bandbreedte. Gemeten voorbeelden: een drie jaar oude M3 Max draait gpt-oss-120b op 61 tokens/s, een 3090 of 4090 draait een 32B-coder op 36 tot 42, een HX 370-minipc met 96 GB draait gpt-oss-120b op 15 tot 17 en een Snapdragon X-laptop draait gpt-oss-20b op 19 op de CPU. Wat ze zouden kopen: een machine uit de klasse van de M5 Max met 128 GB, of eerst een week huren. Policy: de data verlaat het apparaat nooit en operations ben jij.
- Tier 2, een workgroup: één PRO 6000-klasse box, of twee, in een kast. De throughput schaalt met concurrency op de kaart (MIG kan hem splitsen in vier geïsoleerde instances van 24 GB), serving met llama-server of vLLM, plafond: 96 GB bevat het model plus ieders context. Operations: één benoemd persoon die patcht, bewaakt en om 2 uur ’s nachts opneemt.
- Tier 3, een organisatie: multi-GPU-servers, tensor parallelism, vLLM of NIM, een platformteam en een capaciteitsplan. Brian zei dit niet te hebben gebouwd en er ook niet mee te doen alsof. Op deze schaal is de vraag niet meer local versus cloud maar “wiens datacenter”, en voor de meeste organisaties betekent dat een cloud in een sovereign region, met on-prem gereserveerd voor de policy-rijen die zelfs dat verbieden. Verhuurbare dedicated hardware is een optie en Brian klaagde dat de vraag van hyperscalers de hardwareprijzen opdrijft.
Drie hybrid-patronen
In de volgorde waarin ze slagen:
- Local inner loop, cloud review (wat de demo liet zien): een toolinginstelling en een policyregel, geen architectuur. Het goedkoopst om in te voeren.
- Local retrieval, cloud generation: het corpus wordt geïndexeerd en doorzocht op hardware die je zelf beheert en alleen de vraag en de opgehaalde passages reizen mee. Voor veel gereguleerde teams is dit het hele antwoord.
- Sovereign-region cloud als standaard: local alleen voor de rijen die zijn gemarkeerd met “moet in het gebouw blijven”.
“Kies er één. Schrijf het op de policy page. Koop dan de hardware, als het al nodig is.”
Zoek het uit voordat je geld uitgeeft
- Draai de benchmark op wat je al hebt.
- Gebruik een week lang een lokaal model.
- Schrijf de policy page.
“Koop niets eerst. Huur, of draai wat je hebt.” Draai ook je eigen evaluations, niet alleen op snelheid: bekijk de antwoorden en beoordeel of ze bij je behoeften passen.
Building a hybrid AI platform for agent-heavy engineering
Willem Meints – woensdag 14:30–15:30
Willem Meints, chief AI architect bij Info Support, nam het publiek mee door het platform dat Info Support de afgelopen zes maanden bouwde: een hybrid AI platform met focus op software engineering. Het was volgens Willem “geen cloudtalk”: ze gebruiken er geen cloud of Microsoft-technologie meer voor. Het project kostte vier teams ongeveer zes maanden, van netwerken, via het kopen van GPU’s (“een heel interessant verhaal”) en het bouwen van een AI gateway, tot uitzoeken wat er nodig is om software te bouwen met agents op open-sourcemodellen. Willem zei dat ze er “drie of vier dagen” over kunnen praten en één uur hadden. Een handopsteking liet zien dat maar één persoon in de zaal geen AI gebruikt op het werk.
Waarom agentic engineering, en wat daarvoor nodig is
Info Support heeft flink geïnvesteerd in agentic engineering. Omdat code zo snel wordt gegenereerd, innoveren ze veel meer, bijvoorbeeld met rapid prototypes: in plaats van met een klant te discussiëren over abstracte requirements kun je in twee of drie uur “laten zien wat je bedoelt” (niet voor productie).
Maar “het is niet zo makkelijk als het klinkt”:
- Al het andere moet ook werken. Willem vertelde over een PostNL-applicatie waar features in minuten in plaats van dagen werden gebouwd, maar die na drie maanden vastliep omdat kwaliteit, continuous delivery en de oude werkwijzen waren losgelaten in de veronderstelling dat AI ze overbodig maakt.
- Architectuur en het documenteren van specificaties zijn belangrijker dan ooit. “AI maakt alles keer vijf: wat goed gaat, gaat vijf keer zo goed, en wat waardeloos was, wordt vijf keer zo erg.”
- Het doel is niet sneller bouwen, maar beter bouwen en het juiste bouwen. Het begin van de pipeline (het juiste idee vinden) en het einde (adoptie; een postbode wil geen app die elk uur verandert) zijn dun, en het middenstuk (code) is groot. “Alles wat je niet hoeft te bouwen kost je geen tokens, veroorzaakt geen problemen en is uiteindelijk goedkoper.”
De tweede drijfveer is de verschuiving van how naar what: code en implementatiedetails worden steeds vaker door agents gegenereerd, terwijl engineers het verschil maken bij doelen, requirements en design. “Engineering gaat over het ontwerp, niet over de code.” Je moet nog steeds controleren wat de agents opleveren. Ze zien een beweging richting declaratieve, intent-driven software.
De agentic software factory
Info Support noemt de hele stack de agentic software factory, al hoeft het geen fabriek te zijn: je kunt nog gewoon op je laptop ontwikkelen in VS Code of IntelliJ en veel onderdelen zijn optioneel. De lagen, volgens de slide: een AI marketplace (agents, skills, instructions, hooks, scripts), de agent harness, de AI gateway, autonomous agentic engineering, frontier inferencing (Anthropic, OpenAI), local inferencing en cross-cutting concerns.
Laag 1: de basis
Consultants hebben verstandige toegang nodig tot AI-modellen en elk gebruik moet doorbelast kunnen worden aan de klant. Eerst weigerden klanten AI op hun projecten, daarna stonden ze het toe, en toen werd de vraag wie de tokens betaalde: “Wij, en dat is slecht nieuws, want je maakt hetzelfde aantal uren en geeft daarbovenop tokens uit. Het wordt niet goedkoper, het wordt duurder.” Iedereen een licentie geven lost het bijhouden van kosten niet op, en geeft ook geen controle over risicovolle features zoals niet-gecontroleerde custom skills.
Daarom bouwden ze een centrale AI gateway die het volgende regelt:
- Billing en usage metrics.
- PII-filtering (met een standaardservice): mensen sturen nog steeds weleens hun eigen e-mailadres of onvoldoende geanonimiseerde testdata naar een model.
- Safeguards op toegang tot modellen, plus gestandaardiseerde skills en agents.
Twee componenten, beide intern (“source”): de agent marketplace, een repository die nu gevoed wordt door zo’n 200 collega’s die skills, agents, scripts en hooks delen voor tools als Claude Code en GitHub Copilot, en Turnstile, de AI gateway. De marketplace wordt onderhouden via inner-sourcing, omdat “skills en agents constant meebewegen met je software”: je kunt een standaardset van GitHub pakken, maar je gaat die toch aanpassen, dus kozen ze ervoor standaardisatie niet af te dwingen. De gateway wordt onderhouden door het platformteam.
Build or buy? Willem raadt Azure AI Foundry aan voor bedrijven op Azure: het routeert modellen goed, biedt OpenAI- en Anthropic-modellen, kan in Europa of de VS hosten en ondersteunt zelfs open modellen. “Het is best moeilijk om een AI gateway te bouwen, zelfs met AI.” Ze bouwden zelf om twee redenen:
- Klanten die geen data in de cloud willen, maar in het eigen datacenter van Info Support (bijvoorbeeld defensie, of marineschepen).
- Meerdere vendors, lokaal en in de cloud, zodat ze weg kunnen uit de cloud als “een of andere Amerikaanse president besluit de stekker eruit te trekken”.
Hoe de gateway werkt
De gateway is een middleware pipeline (zoals ASP.NET middleware; een library als YARP zou dit kunnen) en het pad van een request is: client, virtual key validator (valideert de key van de client en vervangt die door de echte API key van de provider), reverse proxy handler, capture filter, LLM provider.
Doel: volledig source-compatible zijn met wat OpenAI en Anthropic morgen ook doen, zodat elke agent werkt. Dat betekent dat je de protocollen van beide vendors exact moet volgen (een uitdaging), want anders logt iemand de volgende ochtend in en kan die zijn werk niet doen. Buiten die twee zijn er geen andere LLM-protocollen: open-sourcemodellen spreken er een van. Providers worden geconfigureerd met een backend-URL en de echte API key.
Virtual API keys
Elke agent ondersteunt API keys (een zwak mechanisme, want met een gelekte key kan iedereen jouw geld uitgeven), dus geeft de gateway virtual keys uit:
- Ze kunnen worden ingetrokken.
- Elke key is gekoppeld aan een team of project, zodat kosten toegerekend kunnen worden.
- Voor een autonomous agent geeft de gateway een tijdelijke key uit voor de duur van één taak en gooit die daarna weg, zodat Info Support precies kan zien hoeveel tokens die taak verbrandde.
- OAuth 2 of andere protocollen zouden mogelijk zijn, maar Willem heeft nog geen agent gezien die ze ondersteunt. Zo’n 99% van de coding agents (ook open-sourceagents) werkt.
- Session recording: de gateway kan alle input en output tussen agent en model opslaan en tokens, totale tijd en time to first token rapporteren, handig om agents te optimaliseren. (Foundry kan dit niet, en heeft één API key per model die door alle projecten wordt gedeeld.)
Waarom Go, en hoe usage tracking werkt
Ze bouwden de gateway in Go, niet in C#, omdat YARP gebruiksvriendelijk is maar lastig te gebruiken op bytelevel, wat ze nodig hebben. De kern is de standaard reverse proxy uit de standard library van Go, met een rewrite-operatie voor requests en een modify-response-operatie voor responses.
- Usage tracking: de JSON-response van de provider heeft een
usage-sectie met tokenaantallen (hier komen de usage-balken in VS Code vandaan). OpenAI geeft geen usage terug tenzij erom gevraagd wordt, dus de gateway zet de flag voor je aan en verbergt de usage voor de client als die er niet om vroeg (“we liegen tegen je”). - Streaming (server-sent events): het typeeffect in tools als Copilot is de streaming response, token voor token, als een
text/event-streammetevent:– endata:-regels. Bij streaming requests onderschept het capture filter elk event, haalt er alleen de usage uit en stuurt het event direct door (“event komt binnen, doorsturen, dan verwerken”), zodat er niets gebufferd wordt en de client niet ineens een muur van tekst ziet binnenkomen. Usage tracking loopt daardoor iets achter. - Valkuil: gzip. Anthropic comprimeert request- en response-streams. Willems eerste versie leverde onzin op in de pipeline totdat ze doorhadden dat de events gedecomprimeerd, verwerkt en weer gecomprimeerd moesten worden.
Willems advies: bouw geen eigen gateway tenzij je deze dingen nodig hebt. Als je alleen centrale toegang tot modellen nodig hebt (en op Azure zit), gebruik dan een bestaand product: “het is een gigantische koppijn”.
Waarom een gateway: de cijfers
Drie problemen, volgens de slide:
- Kosten waren onzichtbaar: geen idee wat een project kost en geen manier om de klant te factureren.
- Elk team had een eigen setup: geen controle over welke data waarheen gaat, en cloudproviders mogen niet altijd gebruikt worden.
- Vastzitten aan één vendor: een risico voor resilience en kosten dat je moet beheersen voor DORA.
Onderzoek van Info Support (2026) voegt toe: 44% van de organisaties zegt dat medewerkers op eigen initiatief met AI-tools werken, bij 8% is AI governance formeel verankerd in development en 31% monitort AI agents actief met logging en audits. Willem zei dat ongeveer 44% van de medewerkers een eigen privéabonnement voor werk gebruikt (een cijfer voor de hele Nederlandse markt; bij Info Support lager, maar het komt voor, bijvoorbeeld wanneer marketing animaties wil genereren met een Claude-feature die Claude Code vereist, wat ze niet mogen gebruiken).
Geen quota’s, wel alerts
Info Support besloot geen quota’s te gebruiken: ze volgen en meten, maar stoppen niemand, “als je 10 dollar meer uitgeeft maakt het me niet uit, als het 5.000 euro is voeren we een gesprek”. Dat komt voort uit ervaring: tijdens het testen van de gateway op Azure Foundry waren de quota’s meegegroeid met de uitgaven (van 60.000 tokens per minuut naar een miljoen naar 100 miljoen per minuut), liep een agent 45 minuten door en kreeg Willem een rekening van 12.000 euro en “een mooi gesprek met een directeur”. Nu zijn er alerts (bijvoorbeeld een waarschuwing als de uitgaven boven 500 euro komen: “rem af, ga je agent controleren”), en ze loggen en monitoren AI-gebruik en hebben detectors voor verdacht gedrag.
(Om een idee van de schaal te geven: Willem zei dat het bouwen van de gateway zelf ongeveer 1,8 miljard tokens kostte, grofweg 18.000 euro tegen per-tokenprijzen, op een Claude Max-abonnement.)
Laag 2: autonomous agents
In april dit jaar kwamen agentic teams in de tooling: één taak uitgevoerd door veel agents parallel (requirements engineer, architect, coding agent, test agent, meerdere reviewers). Het is duur en versnelde de beweging van how naar what: eerst een specificatie schrijven (met of zonder AI), die aan een stel agents geven en een pull request terugkrijgen.
Probleem: agents die op laptops draaien stoppen als de laptop in slaap valt. Willem zag collega’s een 3D-geprinte hand in het laptopscherm klemmen en tools gebruiken om Macs wakker te houden. Het beveiligingsbeleid van Info Support vergrendelt laptops na 20 minuten, dus mensen omzeilden de beveiligingsmaatregelen. Dat leidde tot autonomous agents (intern “dark factories” genoemd, wat Willem niet mooi vindt vanwege de “kwade” connotatie). Het is “nog steeds zeer experimenteel”.
De orchestrator
- Een agent orchestrator op Kubernetes, draaiend in het eigen datacenter van Info Support, is gekoppeld aan een issue management system (GitHub, GitLab of Azure DevOps). Je wijst een work item toe aan een agent, die voert het uit en stelt een pull request voor.
- Soorten agents: bijvoorbeeld een requirements engineer (breidt je spec uit tot een volledig gespecificeerd werkdocument: codewijzigingen, tests, architectuurregels, risico’s), een architect agent, backend- en frontend-engineer-agents, QA, ops. Agents kunnen aan elkaar overdragen om dynamische workflows te bouwen, met beslismomenten waarop werk terug naar een mens gaat.
- Het draait op KEDA, dat agents terugschaalt naar nul als ze niets doen (en er een opstart zodra er iets in de backlog verschijnt), omdat sommige agents de hele dag bezig zijn en andere zelden.
- Elke agent is gewoon een container met Claude Code, dus de enige custom code is de orchestratielogica.
- Deployment gaat met Argo CD: een agentdefinitie als markdownbestand in Git (onder
.claude/agents/) wordt een object in het Kubernetes-cluster, gekoppeld aan Azure DevOps of wat er ook gebruikt wordt. Een falende agent kan worden gedood en Argo CD deployt hem opnieuw.
Op dit moment gebruiken zes teams dit bij ongeveer 50 klanten. De agents pakken dependency-problemen, vulnerability scans en de bijbehorende patches op, nieuwe features, bugfixes en reviews. “En wij doen alleen nog review, review, review.” Dat is een uitdaging.
Work items als interface
- Je voegt een tag als
agent:<name>toe aan een work item. Ze kozen voor tags in plaats van het aanpassen van het Azure DevOps-proces-template (wat upgrades “een nachtmerrie” maakt), en tags bestaan ook in GitHub en GitLab, dus hetzelfde procesmodel werkt bij alle providers. - De beschrijving van het work item is de prompt van de agent.
- Als een agent het oppakt, voegt die een
agent::working-tag toe, een soort distributed lock zodat twee agents niet hetzelfde item pakken (“misschien iets wat we moeten fixen, maar tot nu toe gaat het prima”). - De agent plaatst comments, waardoor het werk volledig traceerbaar is. Transcripts worden opgeslagen en alle modelinteracties lopen via de gateway. De agent kan ook aandachtspunten plaatsen, bijvoorbeeld dat die iets anders deed dan gespecificeerd.
- QA-loop: de ene agent implementeert, een andere reviewt, bevindingen gaan terug voor fixes, en dit kan hooguit drie keer herhaald worden. Daarna is het “een verspilling van tokens”: de agent-tags worden verwijderd en het item gaat naar human verify. Afgerond of mislukt werk gaat ook naar human verify, met extra informatie als het mislukt is.
Welke modellen?
Zowel open als frontier. Voor planning gebruiken ze Anthropic-modellen (het nieuwste, Opus 5.5), voor implementatie open-sourcemodellen: “een stuk sneller en supergoedkoop”. Bij lange, complexe taken zijn frontiermodellen stabieler, omdat open modellen de neiging hebben om af te dwalen van het doel en in de war te raken van wat er in hun context window staat. Ze testten Fable en GPT-6 (de grootste modellen) en vonden dat die in deze setting geen meerwaarde hebben, behalve voor securitytaken. Een tip: vraag om een “defensive security review”, want bij de kale formulering “security review” zakt Fable 5 terug naar een ouder model of weigert het; expliciet zijn over defensieve intentie (“ik wil mijn huiswerk controleren”) activeert het wel goed.
Laag 3: local inferencing
Tot nu toe liep alles tegen de API’s van OpenAI en Anthropic, maar Info Support bouwt ook local inferencing, de onderste laag. “In januari begonnen we na te denken over wat er gebeurt als Mr. Orange Carrot de stekker eruit trekt” (een grappige verwijzing naar het Amerikaanse politieke risico voor toegang tot modellen), dus besloten ze eigen hardware aan te schaffen: “hoe moeilijk kan het zijn? Famous last words.”
De hardware: twee servers (ongeveer 17 kg per stuk, “als je twee servers koopt, kun je ook een huis kopen”), 8 GPU’s per server, 16 GPU’s in totaal, 96 GB per GPU, met 96 ampère aan stroom erdoorheen. Vier GPU’s in productie kunnen al de helft van Info Support bedienen, met er nog twaalf vrij.
Economie: alleen de stroom kost ongeveer 12.000 euro per maand, en de hardware is een vast bedrag in plaats van per-tokenprijzen, dus “het rekent uit”. Een veelzeggende anekdote: iemand schakelde tijdens het testen per ongeluk de planning agents van een frontiermodel over naar een open-sourcemodel, en niemand merkte het. De kwaliteit was hetzelfde.
Hoe het gehost wordt
- vLLM (een Python-applicatie, “van binnen absolute rommel, maar het doet zijn werk”): host het model, zet requests om in de getallen die het model nodig heeft en weer terug in een response, en stelt een HTTP-endpoint beschikbaar. Nu één instance, met vier of acht mogelijk.
- Kubernetes host vLLM als container, met meerdere modellen en failover.
- De NVIDIA GPU Operator stelt GPU’s beschikbaar aan Kubernetes. Ze gebruiken time slicing (applicaties nemen om de beurt een GPU): de goedkoopste optie, “geen security boundary”. Het past bij een LLM dat 24/7 draait en vol zit met requests. Wil je echte partitionering en isolatie (slicing and dicing), dan rekent NVIDIA een aparte licentie “zo duur als je videokaarten”, waar niemand je iets over vertelt. Zij hebben het niet nodig.
Waarom de gateway geen stateless proxy is: de KV cache
LLM’s hebben geen “chat”, alleen een reeks tokens erin en tokens eruit: er wordt één token voorspeld, aan de input toegevoegd (inclusief de oorspronkelijke prompt), dan het volgende, enzovoort. Met 500.000 tokens in het window betekent elk nieuw token dat ze allemaal opnieuw verwerkt moeten worden, en daarom zakt de performance. Een typisch open model heeft 30 miljard berekeningen per token nodig. De oplossing is de KV cache: de outputs van transformer-lagen cachen zodat genereren een lookup wordt. “Deze cache is de sleutel tot snelheid”: ongeveer 100 tokens per seconde zonder en 5.000 mét op hun eigen hardware (op vier GPU’s, “dat haal je niet op Azure, dat alle GPU’s met iedereen deelt”).
Op een GPU van 96 GB nemen de modelgewichten grofweg de eerste 24 GB in beslag en de rest is cache. De hoeveelheid cache bepaalt hoeveel developers parallel kunnen werken. Grotere context windows en meer developers vragen meer cache, dus begrenst Info Support context windows op 128.000 tokens.
Het grootste deel van de optimalisatietijd gaat naar:
- Latency (de tijd tot het eerste token),
- Snelheid (gegenereerde tokens per minuut),
- De cache niet kapotmaken.
Omdat de cache van een sessie op één GPU leeft, doet de gateway KV-cache-aware routing: die herkent een sessie die hij eerder zag en stuurt hem naar dezelfde server. Anders “betaalt” die persoon de prijs van een koude cache en houdt de andere server een nutteloze cache vast die ruimte inneemt. Daarom kostte het zes maanden om dit goed te krijgen.
Q&A
- Wie gebruikt het platform? Iedereen heeft nog steeds een licentie. Ongeveer zes teams gebruiken het, waaronder de afdeling managed services en één klantteam, samen zo’n 40 mensen. Tot nu toe wordt het gebruikt voor interne ontwikkeling, met één extern klantteam, en het wordt aan klanten aangeboden.
- Favoriete open modellen? Qwen 3.8 is erg goed voor coding (volgens Willem vergelijkbaar met Opus 5), maar niet voor Nederlands, omdat het willekeurig Chinese tekens tussendoor gooit. Het heeft ook censuur ingebouwd: het antwoordt anders op onderwerpen waar de Chinese overheid een mening over heeft, wat voor code niet uitmaakt. Het model draait in het datacenter van Info Support achter een firewall op uitgaande verbindingen en ze hebben nog nooit een verbinding naar China gezien (“het is een bak floating points”). DeepSeek is ook goed in coding, met dezelfde kanttekeningen. Ze kijken naar Mistral, dat open weights publiceert, en hopen op een groter nieuw model. Voor Nederlandse ondersteuning wees Willem op modellen van Google of Microsoft, die beter zijn in tekst dan in coding. Info Support overweegt ook om collega’s modellen te laten indienen om te draaien.
- Fine-tuning? Bewust niet gedaan: het is duur en je hebt veel meer dan 10 tot 12 GB aan voorbeelddata nodig om te beginnen.
From “Trust Me” to “Verify Me”: verifiable trust in the software supply chain
Tom van den Berg – woensdag 16:00–17:00
Tom van den Berg is lead platform engineer bij Info Support en werkt via Info Support voor de Nederlandse Spoorwegen aan het mission-critical deel van het platform. Hun talk, de laatste sessie van Techorama, ging over verifieerbaar vertrouwen tussen producenten en consumenten van software. De kernzin, op de eerste slide: “Echte supply chain security bestaat pas als consumenten de claims van de producent zelfstandig kunnen verifiëren.” De sessie behandelt beide kanten: wat een producent kan doen om verifieerbare claims te maken en wat een consument kan doen om ze te controleren.
Waarom supply chain security
Tom opende met geschiedenis:
- SolarWinds (2020): een van de eerste publiek gedocumenteerde supply chain-aanvallen op de Amerikaanse overheid. Een backdoor in software die een leverancier uitbracht, werd gebruikt om de klanten aan te vallen. “Toen begon de hele wereld ernaar te kijken: wij zijn misschien niet meer het doelwit, maar ze richten zich op onze dependencies.”
- Shai-Hulud (eerder in 2026): een worm in NPM die credentials steelt. Wie een geïnfecteerd package installeerde, kreeg side effects die sleutels en secrets naar een externe locatie wegsluisden.
Het punt: aanvallers verplaatsen zich van het rechtstreeks aanvallen van je firewall of systeem naar alles wat je van derden binnenhaalt: code die je niet zelf schreef en waarvan je de inhoud niet kent. “We hebben veel software draaien in productie die niemand van ons ooit gezien heeft, maar we hebben genoeg vertrouwen om het te deployen.”
Toms eigen omgeving maakt dit concreet: op hun platform draaien ze tooling van derden zoals cert-manager, de External Secrets Operator en Envoy, allemaal met gevoelige data, “op naam van de uitgever”. Een naam is niet meer genoeg: ze noemden een maintainer van de Linux-kernel die kwade bedoelingen had. Een onderzoeker die Tom citeerde stelt dat ongeveer 80% van de software in productie van iemand anders is, dus je kent alleen de 20% die je zelf schreef.
Artifact signing
Artifact signing betekent dat je een artifact in een registry (een OCI-registry) neemt, met een private key en een tool een signature maakt en die signature naast het artifact opslaat.
Sign the digest, not the tag
Je kunt een artifact op twee manieren aanwijzen:
- Via tag (
1.0.0,latest,stable): leesbaar voor mensen en passend bij releaseprocessen, maar tags zijn mutable: je kunt een ander artifact met andere inhoud opnieuw taggen en de tag identificeert de inhoud niet uniek. - Via digest: je gaat van “ik vertrouw wat er op dit moment achter deze tag zit” naar “ik vertrouw deze exacte inhoud”. Een digest kan niet naar iets anders wijzen en is reproduceerbaar: verandert de inhoud, dan verandert de digest en geldt de signature niet meer.
Je hebt een artifact, een signature, een certificaat en een system of record nodig dat bewijst dat het signen heeft plaatsgevonden.
Demo 1: signen met Cosign en Sigstore
Tom pushte een image naar Azure Container Registry (met de tag latest, “voor de demo, doe dit alsjeblieft niet”), noteerde de digest en signde die:
cosign sign <registry>/crafted-specially@sha256:...waarschuwde dat dit op een private repository lijkt en vroeg om te bevestigen dat er geüpload wordt naar het Rekor transparency log, een publiek system of record (“prima voor een demo, voor private resources wil je misschien geen publiek log”).- Cosign genereerde ephemeral keys en vroeg Tom om bij Sigstore in te loggen met een identity provider (GitHub, Google of Microsoft). Tom koos GitHub: er werd een certificaat voor die identiteit uitgegeven, waarmee de digest werd gesigned.
Daarna toont de registry een Sigstore bundle die als referrer aan de image hangt. “Dit is pas de eerste stap om je artifacts veilig te maken.”
Waarom signen alleen niet genoeg is: twee aanvallen
Stale branch attacks
Je main branch heeft alle beveiligingen (verplichte reviews, geen directe pushes), maar een oude proof-of-concept- of experiment-branch misschien niet. Aanvallers kunnen er rechtstreeks naar pushen, pipelines triggeren, een oude kwetsbaarheid misbruiken of eerdere approvals hergebruiken. Zulke verlaten, niet-gemonitorde Git-branches worden gebruikt om security checks te omzeilen, kwaadaardige workflows uit te voeren of toegang te krijgen tot gecompromitteerde credentials.
De confused deputy: Dependabot
Een confused deputy is een vertrouwde partij die door een aanvaller wordt gemanipuleerd tot een onbedoelde actie. Het voorbeeld: het commando @dependabot recreate van Dependabot maakt een pull request opnieuw aan, en de auteur wordt Dependabot. Stel je een repo voor die patch-updates van Dependabot automatisch merget als de pipeline groen is. Een kwaadwillende forkt de repo, injecteert kwaadaardige code in de fork, opent een PR (die niet automatisch gemerget wordt omdat de auteur niet Dependabot is) en vraagt Dependabot dan om die opnieuw aan te maken. De auteur is nu Dependabot, dus de auto-merge-regel kan van toepassing zijn, waardoor code uit een fork in de main repo terechtkomt. (Tom merkte op dat er wat extra context nodig is om dit te laten werken, maar “mensen doen dit soort auto-merge wel”.)
SLSA: vertrouwen standaardiseren
SLSA (Supply-chain Levels for Software Artifacts) is geen tool of techniek, maar een vocabulaire, een set richtlijnen en een checklist voor producenten en consumenten. Er zijn twee tracks: de source track (waar en hoe code wordt opgeslagen en geconfigureerd) en de build track (hoe artifacts worden gebouwd en gebruikt). De talk richt zich op de build track.
Twee partijen produceren een artifact: de producent (jij) en het build platform. De producent hoort een passend build platform te kiezen, een consistent buildproces te volgen en provenance te distribueren. Het build platform bepaalt vervolgens het level:
| Level | Provenance generation | Isolation |
|---|---|---|
| L1 | Exists | Hosted |
| L2 | Authentic | Hosted |
| L3 | Unforgeable | Isolated |
Tom zei dat Azure DevOps standaard alleen SLSA level 1 haalt, omdat het platform geen provenance genereert die authentiek en niet te vervalsen is (je kunt er zelf een bouwen, zoals een proof-of-concept provenance generator voor Azure DevOps, maar het platform levert die niet).
Build provenance en attestations
Build provenance is “verifieerbare informatie over software-artifacts die beschrijft waar, wanneer en hoe iets is geproduceerd”.
Het bevat het build type (bijvoorbeeld welke runner), internal parameters (door het platform gezet), external parameters (door de producent meegegeven), resolved dependencies en de output (het subject, dat naar de digest van het artifact wijst).
Een attestation is een geauthenticeerde verklaring (metadata) over een of meer artifacts. Ze bestaat uit een subject, een predicate (wat voor soort verklaring: bijvoorbeeld een SBOM of build provenance) en een envelope met een digitale signature. Attestations kunnen gebundeld worden. Meestal gebruiken ze de in-toto-specificatie.
Demo 2: een signature verifiëren
Tom downloadde de signature (via de referrers index) en las daaruit de OIDC issuer (GitHub) en het e-mailadres van de ondertekenaar met een script dat Rekor bevraagt.
cosign verify controleert vervolgens de signature tegen een verwachte certificate identity en OIDC issuer. Toen Tom bewust de verkeerde identity opgaf, faalde het (“no matching certificate identity found”).
OCI artifacts en referrers
OCI (Open Container Initiative) artifacts bestaan uit een manifest, blobs (zoals image layers), een digest en een media type.
Het sleutelconcept is referrers: een cryptografisch gekoppelde verwijzing naar een ander artifact, dat zelf ook ieder OCI-artifact kan zijn. Een signature, een SBOM en een provenance attestation kunnen dus allemaal naar dezelfde image wijzen, waardoor een boom van bewijs ontstaat.
Omdat een registry een OCI-registry is, ben je niet beperkt tot Docker-images: met ORAS kun je ook andere bestandstypes (markdown, Terraform-modules, machine-learningmodellen) als OCI-artifact pushen, ze daarna signen en er attestations aan toevoegen.
Tom demonstreerde dit met een simpel markdownbestand (“Hello, Techorama”), gepusht met één oras push-commando, dat daarna net als een image gesigned kan worden.
Hetzelfde idee is belangrijk voor skills van AI-agents. Tom vroeg hoeveel mensen de inhoud controleren van custom skills die ze uit marketplaces installeren (een of twee handen) en citeerde onderzoek dat zegt dat ongeveer 26% van de skills beveiligingslekken heeft, zoals kwaadaardige injecties. “Er is een grote use case voor verifieerbaar bewijs voor agent skills.”
In de live demo genereerde een GitHub Action build provenance, signde die en hing die aan de image, zodat de registry een tweede referrer (een tweede Sigstore bundle) naast de oorspronkelijke signature toonde.
De kant van de consument
“Bewijs genereren is maar de helft van het verhaal. Bewijs dat niemand controleert is slechts documentatie.” SLSA beschrijft het perspectief van de consument in drie stappen:
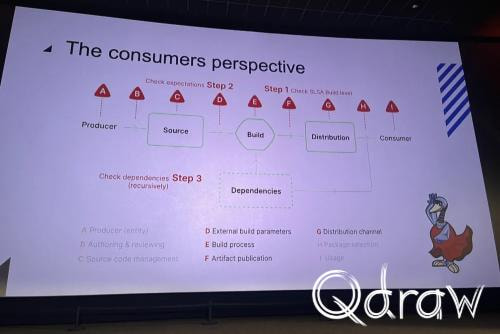
- Controleer het SLSA build level. Is een artifact niet op het door jou verwachte level gebouwd (idealiter level 3), gebruik het dan niet.
- Controleer de verwachtingen: verifieer de claims van de producent (geen kwetsbaarheden, toegestane licenties, enzovoort).
- Controleer de dependencies, recursief.
(De slide brengt ook de hele keten in kaart, van producent tot consument, van authoring en review tot packageselectie en gebruik.)
De pragmatische CLI-variant: gh attestation verify op de image digest, waarbij je opgeeft uit welke repository het moet komen, de certificate identity (je verwachte workflow), de OIDC issuer (GitHub), het predicate type (bijvoorbeeld SLSA provenance v1 of een SPDX SBOM) en bijvoorbeeld dat het gebouwd is vanaf de main-branch, wat beschermt tegen de stale-branch- en confused-deputy-aanvallen. Uit het publiek kwam een vraag in dezelfde geest: attesten van SBOM’s, geen bekende kwetsbaarheden (bijvoorbeeld voor de EU Cyber Resilience Act) en licenties. Het antwoord: daar maak je ook attestations voor. (Tom verduidelijkte dat “v1” in het provenance predicate de versie van het provenance-formaat is (SLSA provenance heeft v1, v1.1, v1.2) en niet het securitylevel, dat in de attestation zelf wordt vastgelegd.)
Een kanttekening voor .NET: NuGet
Er staat een al lang openstaand NuGet-issue (sinds 2024): als je een package uploadt, past NuGet.org het aan (om de publisher- en repository-signature toe te voegen), waardoor de digest verandert en elk bewijs dat voor het originele package is gemaakt niet meer klopt. Vergelijk je het package uit je build artifact met het package dat je van NuGet downloadt, dan verschillen ze.
Hoe de Nederlandse Spoorwegen het doet
Artifact promotion model
Het platformteam bouwt veel artifacts (Terraform-modules, pipeline steps en meer) die teams gebruiken. Elk artifact gaat door een “wasstraat”:
- Build and attest: provenance en SBOM.
- Verify (gate): signature, provenance, SBOM en trusted builder, inclusief security scanning, secret scanning en controles op kwetsbaarheden en licenties (bijvoorbeeld met Trivy). De uitkomsten van de tools worden aan het artifact geattesteerd.
- Promote naar een trusted registry: het Mission Critical Platform-team “zet er een stempel op” op basis van bewijs dat iedereen kan controleren.
- Consume in de hele organisatie. Faalt een gate, dan wordt het artifact niet gepromoot.
Docker Hardened Images
Tom demonstreerde Docker Hardened Images (gratis te gebruiken, met betaalde enterprise-tiers en strengere SLA’s). Ze nemen een base image en hardenen die, met een lijst van packages, specificaties, bekende kwetsbaarheden en attestations.
De genoemde attestation-types omvatten een CycloneDX SBOM, een changelog, image sources, CVE’s, VEX (vulnerability exploitability exchange), SLSA provenance, een secrets scan, tests en een virusscan. Met dezelfde verificatiemethode controleer je de claims van de publisher zelf en als je iets als RabbitMQ uit de hardened catalogus pullt, krijg je ook de licenties (die in jouw bedrijf misschien niet zijn toegestaan), anders dan bij een gewone pull van Docker Hub. De Nederlandse Spoorwegen kijkt naar een overstap naar hardened images.
Afdwingen bij deployment
Security vroeg om geautomatiseerd, verifieerbaar bewijs op deploymentmoment dat workloads compliant zijn. Ze implementeerden dat met Open Policy Agent en Gatekeeper op AKS (Azure Kubernetes Service). Gewone OPA kan alleen de gedeployde definities controleren, maar de external data provider-plugin en een artifact attestations OPA provider kunnen de attestations van een image in een externe registry opzoeken en gebruiken als input voor policies in Kubernetes admission control. Een policy kan bijvoorbeeld een deployment toestaan of weigeren op basis van de SBOM, licenties of kwetsbaarheden.
In de praktijk dwingen ze workloadteams nu af hun images te signen en onderzoeken ze of die ook kunnen bewijzen dat er geen bekende kwetsbaarheden en geen niet-toegestane licenties zijn. “Security wordt leuker: weg van Word-templates en screenshots, naar automatiseren.” Security hoort geautomatiseerd, observeerbaar, verifieerbaar en developer-friendly te zijn.
Een waarschuwing: het is geen wondermiddel
Tom sloot af met een kanttekening. Volgens een onderzoeksnotitie van de Cloud Security Alliance over de Shai-Hulud-cascade “Megalodon” (gemeld op 25 mei 2026, met meer dan 5.500 geïnfecteerde GitHub-repositories) was de eerste golf (29 april tot 12 mei, Mini Shai-Hulud) de eerste publiek gedocumenteerde aanval die cryptografisch geldige SLSA Build Level 3 provenance attestations produceerde, door een legitieme buildpipeline en de bijbehorende credentials te kapen. Verificatie is dus “geen wondermiddel”, maar een extra laag bovenop bestaande security. “Je moet er nog steeds verdomd zeker van zijn dat wat je binnenhaalt het juiste spul is.”
Toms demo-repository staat op GitHub (tom171296/craftedspecially)
A Fresh Perspective on Behaviour, Change and the Brain
Paul Smit – woensdag 17:15–18:15
Paul Smit is spreker en neurowetenschappelijk onderzoeker aan de Universiteit Leiden en schreef meerdere boeken over het brein (ze noemden er veertien in de introductie). Dit was de laatste sessie van Techorama, deels psychologiecollege, deels goochelshow, met veel videoclips, experimenten met het publiek en grappen. Hun vraag voor het slotuur: waarom veranderen we, of juist niet? Een groot deel van de talk ging over hoe het brein snelle, onbewuste beslissingen neemt en waarom dat ertoe doet voor technologie, AI en samenwerken.
Opening: drie snelle vragen
- Hoeveel jaar is George Clooney ouder dan Brad Pitt? De meeste mensen in de zaal gokten negen. Het juiste antwoord is twee. Aannames komen binnen een seconde op in het brein.
- Hoe lang heeft het brein nodig om bij een sollicitatiegesprek ja of nee te beslissen? Een gesprek duurt gemiddeld 45 minuten, maar het brein beslist in ongeveer 0,2 seconde.
- Een gezichtstest van één seconde. Het publiek zag één seconde lang twee mannen en koos een toekomstige collega. Zo’n 98% koos dezelfde persoon, omdat het brein een gezicht scant en intelligentie afleidt uit signalen zoals jukbeenderen en kin. Een tweede paar liet het omgekeerde zien: de meesten kozen de man die, zo grapte Paul, een seriemoordenaar bleek te zijn. “Je eerste aanname klopt niet altijd.”
Onze zintuigen zijn subjectief
Paul liet een reeks illusies zien om te laten zien dat wat we zien altijd een subjectieve constructie is:
- Een holle mal van een masker die lijkt alsof de neus naar je toe steekt: het brein is zo geconditioneerd om een gezicht met de neus aan de buitenkant te zien dat het beeld omklapt.
- Slechts een klein gebied (ongeveer zo groot als je duimnagel op armlengte) zien we scherp. “Als ik nu tegen jullie praat, is alles vrij wazig.” Door naar een stip te staren leken beroemde gezichten vervormd, maar “er is niets mis met de foto’s, het gebeurt alleen in je hoofd”.
- Een zwart-witfoto die gekleurd leek te worden na staren naar een versie met hoog contrast, en draaiende kleuren die leken te bewegen toen de gele lijnen werden weggehaald.
11,2 miljoen bits versus 60 bits
Het centrale idee van de eerste helft: het brein is extreem snel.
- Het onbewuste brein verwerkt ongeveer 11,2 miljoen bits per seconde. Ons bewustzijn is maar ongeveer 60 bits.
- Beslissingen, bijvoorbeeld iets kopen, worden onbewust genomen. Achteraf “verzinnen” de 60 bits “een verhaal over waarom je het kocht”.
- Met 60 bits kunnen we ons maar op één ding tegelijk richten. Je kunt een gezicht van voren of van opzij zien, maar niet allebei tegelijk. Zo houden goochelaars ons voor de gek en merkt iemand die op zijn telefoon let een vermist kind niet op, of merkt een zangeres niet dat ze in een fles zingt.
- Gevolg voor design: houd informatie zo simpel mogelijk, één boodschap tegelijk (Paul toonde een website met één boodschap als goed voorbeeld).
- Het onbewuste brein handelt eerst en het bewustzijn komt met een kleine vertraging. Een woordleestest, een draaiende-frame-illusie (het Ames-venster) en een snelle dierennaamtest (een dromedaris die kameel werd genoemd) lieten dat zien. Het is ook waarom je soms iets eruit flapt en pas daarna beseft “dat had ik niet moeten zeggen”. Een korte slide met het bedankje van een voetballer na de wedstrijd (“Mijn vrouw en mijn vriendin. Ik bedoel mijn vrouw”) diende als voorbeeld.
- Reflexen zitten in het onbewuste brein. De spreker noemde een reactietijd van 44 ms voor een slang en 20 ms voor een kat.
Leugens en micro-expressies
Paul trainde vroeger de Nederlandse politie in het herkennen van leugens. “De 60 bits zeggen nee, maar het onbewuste brein knikt ja” of laat micro-expressies zien (zoals minachting) die je niet kunt controleren. Ze toonden bekende interviewfragmenten als voorbeeld en concludeerden: “ons onbewuste brein wint altijd.”
Framing, met het voorbeeld van de penaltyserie
We zijn gemakkelijk te beïnvloeden: volgens Paul worden beelden 60.000 keer sneller verwerkt dan tekst. Het voorbeeld van framing was Tim Krul in de Nederlandse penaltyserie op het WK: door naar één kant te lopen, de penaltynemer op de schouder te tikken en aan de andere kant een “lege ruimte” te laten, stuurde hij het onbewuste brein van de nemer, zodat hij de goede kant op kon duiken. “Die man denkt met zijn 60 bits dat hij zijn eigen beslissing neemt.”
AI en de dood van wat echt is
Voor het eerst in de geschiedenis heeft het brein concurrentie: supercomputers en AI. Paul liet door AI gegenereerde video’s zien (een beroemde zanger die een nummer “zingt” dat hij nooit opnam, een voetballer die Nederlands praat, twee wereldleiders in een circusact en Paul zelf in een western met beroemde acteurs die “verandert in Brad Pitt”). De gevolgen:
- De “dood van het internet”: binnenkort weten we niet meer of wat we zien echt is.
- AI slop: een stortvloed aan rommel.
- Een test met het publiek: bij twee paren portretten was er telkens één door AI gegenereerd en het publiek raadde meestal fout.
AI heeft geen bewustzijn
Omdat AI geen bewustzijn heeft, doet het geen reality check. Pauls voorbeelden: de vraag om een “realistische” versie van een afbeelding met vierkante wielen leverde ronde wielen op (omdat rond het meest voorkomt in de trainingsdata), en opnieuw nadat het in Photoshop was aangepast en om een video werd gevraagd. “AI is nooit zo creatief.” Gevraagd waarom een klassieke grap (“kamer voor twee nachten”, een woordspeling met “knights/nights”) grappig is, legde AI de woordspeling uit, maar “het kent de ervaring van humor niet”. AI kan geweldige remixes maken, maar kan niet genieten van wat het maakt: “alleen wij kunnen dat”. De 60 bits bewustzijn zijn “het mooiste wat we hebben”, want daarmee kunnen we genieten van muziek en vertrouwen voelen.
Het brein met drie lagen
Paul gebruikte het populaire “triune brain”-model (een vereenvoudiging) met drie lagen en drie motieven: routine, plezier en doel.
1. Het reptielenbrein: routine en veiligheid
Het oudste deel wil routine om energie te besparen en ongeveer 99% van wat we doen komt voort uit routine. Test: sla je armen over elkaar en wissel dan welke arm bovenop ligt: “problemen”. Het scant ook op veiligheid (“ben ik veilig?”, bijvoorbeeld een kat die schrikt van een komkommer die op een slang lijkt). Voorbeelden:
- Conditionering: een hond die wacht tot de deur opengaat, en een man die drie maanden dagelijks moest oefenen om te fietsen met omgekeerd stuur en de dag erna niet meer op een gewone fiets kon rijden. “Verandering is een kwestie van herhaling.”
- Bungeejumpen: je betaalt 150 euro en kijkt ernaar uit, maar op het platform zegt het reptielenbrein nee. “Het oudste deel wint altijd.”
- Een winkel in Parijs met een perfect vlakke vloerbedekking die eruitziet alsof er gaten in zitten: iedereen loopt voorzichtig.
- Vertrouwen en oxytocine: elkaar persoonlijk ontmoeten, handen schudden en (bij leeuwen) knuffelen verhogen oxytocine, wat het vertrouwen verhoogt. Daarom is het waardevol om elkaar te ontmoeten op Techorama.
2. Het zoogdierenbrein (emotioneel brein): plezier
Dit deel wil plezier. Grote emoties onthoud je (Pauls voorbeeld: waar je was op 9/11), daarom werkt een emotionele reclame. Dopamine verhoogt het plezier:
- In een test met het publiek vroeg Paul een vrijwilliger een concert te kiezen en die koos het concert met de meeste dopamine: “je kiest altijd wat je de meeste dopamine geeft”.
- Dopamine stijgt ook bij verrassing (een virale grap in een fitnessclub) en vooral wanneer mensen over zichzelf praten: “laat de klant over zichzelf praten en je kunt alles verkopen”.
- Dit brein is ook lui: het neemt de weg van de minste weerstand (zelfs mensen in de sportschool mijden de trap; op een Nederlands toilet drukken mensen op de grote spoelknop). Dus de customer journey moet zo soepel en simpel mogelijk zijn.
3. De neocortex: doelen en rationeel denken
Die regelt rationeel denken, doelen en duidelijkheid en is pas rond je 25e volledig ontwikkeld (plannen en risico’s nemen is daarvoor moeilijker). Het visitekaartje van een mentalist dat openvouwt tot een heel pak liet zien hoe de neocortex probeert iets te begrijpen wat rationeel onmogelijk is.
Het emotionele brein is sterker dan het rationele. In een interview werd er met Bryan Adams geflirt en hij verloor zijn woorden doordat zijn neocortex uitviel. Pauls advies voor emoties, bij een partner of een klant: onderdruk ze nooit, benoem ze gewoon, wat Adams deed om te herstellen. Paul gaf ook het voorbeeld van de marshmallowtest: de neocortex zegt “niet opeten”, de twee oudere delen zeggen “opeten”. Een ander voorbeeld was de Nederlandse premier die tijdens corona aankondigde dat we geen handen meer zouden schudden en vervolgens meteen weer handen schudde.
Wanneer gebeurt verandering echt?
Wanneer alle drie de delen van het brein samenwerken, wat in twee situaties gebeurt:
- Passie: intrinsieke motivatie (“mensen die zo gepassioneerd zijn over AI gaan veel sneller”).
- Urgentie: we moeten echt veranderen.
Passie is “veel fijner”. En de beste manier om te veranderen is in kleine, concrete stappen: het reptielenbrein denkt in routines, dus iets één keer anders doen brengt het in de war (geïllustreerd met een truc van een voetballer).
Te veel informatie: FOBO, rust en dopamine
Technologie groeit exponentieel en Paul zei zelf overweldigd te zijn door de hoeveelheid dagelijks AI-nieuws. Dat veroorzaakt FOBO, door de spreker hier gedefinieerd als “freaks out, but optimistic”. Het medicijn: neem rust en focus.
Hoe dopamine werkt
- Dopamine geeft plezier en motivatie. Kinderen hebben er veel van: een meisje dat voor het eerst een trein ziet is opgetogen en kinderen zijn gemotiveerd om nieuwe dingen te proberen. Mensen met te veel dopamine worden thrill seekers.
- ’s Ochtends stijgt dopamine (koffie geeft ook een boost), met een piek in de eerste acht uur na het wakker worden (gemotiveerd en geconcentreerd op werk), en daarna “is er niet veel meer over voor de rest van de dag”.
- Hoogtepunten worden gevolgd door dieptepunten. Paul vergeleek het effect van cocaïne (zou dopamine vervierdubbelen) met de “dinsdagdip” die hun zoon en vrienden voelen na een hardstylefestival (het brein duwt alles omlaag). Dat is niet erg: rust laat het brein herstellen.
- Het moderne probleem: we proberen de leegte in de avond op te lossen met drinken (volgens de spreker verdubbelt alcohol dopamine en schakelt het de neocortex uit) of snacken, en uiteindelijk met TikTok, dat neurowetenschappers “digitale cocaïne” noemen: elke swipe is een dopamineshot.
- De baseline daalt. Volgens onderzoek van de spreker hebben mensen die zichzelf met zulke prikkels overladen een lagere dopamine-baseline en minder gevoelige receptoren, waardoor het gewone leven saai voelt. “Dat is de grootste uitdaging voor onze jeugd.” De reactie op verveling is multilayering (telefoon bij het ontbijt, twee schermen tegelijk) en “meer en meer” willen, wat niet goed is voor het brein. Smartphones zijn zeer verslavend en ouders geven niet het goede voorbeeld. Het medicijn opnieuw: rust, het brein de tijd geven om te herstellen van alle prikkels.
Generaties op het werk
Paul sloot het hoofdgedeelte af met een rondgang langs generaties, “omdat we samenwerken met verschillende generaties”, met muziek, nostalgie en quizzen (met de generatielabels zoals op de slides):
- Babyboomers (1946 tot 1964): opgegroeid in een tijd van economische groei met weinig technologie (een pitstop van 67 seconden als “wereldrecord”, de stratenatlas als navigatiesysteem). Hun motto: een baan voor het leven, “je brood verdienen”.
- Generatie X: opgegroeid met de Commodore 64 en geconfronteerd met een recessie bij het verlaten van school, waardoor ze loyaal en pragmatisch werden (en, zo grapte Paul, thuis een mand met kabels hebben die ze nooit zullen gebruiken).
- Generatie Y (millennials, 1980 tot 1994): digitalisering, flexibel, “YOLO” (you only live once). Ze zijn digitaal sterk, maar denken soms dat ze alles zelf kunnen.
- Generatie Z: anders geconditioneerd (de piramide van Maslow is veranderd), vanaf de geboorte altijd online, met alles instant en snel, en behoorlijk idealistisch.
Paul illustreerde de wereld van Gen Z met cijfers: volgens Paul heeft ongeveer 39% van de Nederlandse babyboomers een Netflix-account tegenover 79% van Generatie Z (de rest gebruikt het account van de ouders). Over hoe snel platforms 100 miljoen gebruikers bereiken: ChatGPT “verbrak alle records” met ongeveer twee maanden, tegenover ongeveer anderhalf jaar voor YouTube en TikTok en drie tot vier jaar voor Instagram, Facebook en WhatsApp. De volgende generatie, Generatie Alpha, wordt onze collega: “die gaan de wereld redden, zeker weten”.
Paul gebruikte AI ook om hun eigen boek te promoten (met een nagemaakte, door AI gegenereerde aanbeveling) en om een oude demo-cassette uit 1994 en een VHS-opname van een band te herstellen tot “studiokwaliteit”. Dat laat de “magische” kant van AI zien.
Conclusie
Pauls samenvatting (recap):
- Het brein is geweldig, maar alles wat we zien is een subjectieve kijk, en illusies (een metro die naar je toe of van je af beweegt, een draaiende figuur die van richting verandert als je je hoofd kantelt) zijn “allemaal een kwestie van waarneming”.
- Het onbewuste brein doet alles en we zijn gemakkelijk te beïnvloeden (zelfs filmmuziek verandert hoe een vechtscène voelt).
- AI kan kanker genezen of slop maken.
- We veranderen uit passie of urgentie, en het best in kleine concrete stappen.
- Dopamine geeft motivatie en plezier en soms heb je rust nodig voor balans.
- Paul merkte ook op dat mensen van 20 tot 30 jaar de meeste dopamine hebben en in hun meest creatieve fase zitten: in de Nederlandse Top 2000 zijn veel van de all-time klassiekers geschreven door mensen in die leeftijdsgroep.
Ze eindigden met een medley van klassieke nummers (“deze jongens zingen alsof ze gaten boren”) en een uitnodiging om wat te gaan drinken.
Conclusie van het hele event
Twee dagen Techorama laten een duidelijk beeld zien: de technologie gaat razendsnel, maar de beste resultaten komen nog altijd uit goede engineering, heldere afspraken en aandacht voor mensen.
AI versnelt wat er al is
Meerdere sessies kwamen op hetzelfde punt uit: AI maakt het schrijven van code goedkoop en snel, maar vermenigvuldigt ook wat al in je organisatie aanwezig is, zowel het goede als het slechte. Wie slordige code, trage reviews, onduidelijke eigenaarschap of een chaotische aanpak heeft, krijgt dat sneller en groter terug. Het knelpunt verschuift van code schrijven naar reviewen, verifiëren en besluiten wat gebouwd moet worden. Dezelfde kwaliteitslat voor elke wijziging, wie of wat die ook schreef, en een mens die de eindverantwoordelijkheid draagt (“you prompt it, you own it”), kwamen in meer dan één talk terug. Agents en automatisering werken het best als ze begrensd zijn: beperkte rechten, gecureerde context, een duidelijk eindresultaat en een mens die het laatste woord heeft.
Vertrouwen moet je kunnen controleren
Van MITRE ATT&CK en antipatterns tot supply chain-aanvallen: aanvallers richten zich steeds meer op wat we van derden binnenhalen en op de manier waarop we bouwen en uitrollen. De boodschap is om vertrouwen te verdienen met bewijs: ondertekende artifacts, provenance, scans, back-ups die je echt hebt teruggezet en een beperkte blast radius. Geen enkele maatregel is een wondermiddel, het gaat om meerdere lagen die elkaar aanvullen.
Autonomie vraagt om goede grenzen
Of het nu ging om microservices, DDD en enterprise architecture of het versioneren van events: koppeling is het echte probleem. Begin eenvoudig (een modulaire monoliet, geen integratie als het niet hoeft), behandel grenzen als hypothese, maak contracten expliciet en bedenk dat elke integratie ook een afspraak tussen teams is. Organisatie en architectuur beïnvloeden elkaar, en wie dat bewust gebruikt, bouwt systemen die kunnen veranderen zonder toestemming te vragen.
Het blijft mensenwerk
Ten slotte kwamen de mens en de ziel nadrukkelijk terug: de keynote over schaal versus ziel, de sessie over burn-out en de afsluiter over gedrag en het brein. Verandering vraagt herhaling, kleine concrete stappen, rust en een veilige omgeving waarin slecht nieuws welkom is. Technologie en mens versterken elkaar het best wanneer we beide serieus nemen.
Praktisch aan de slag
Wil je maandag iets doen met wat je gelezen hebt? Kies één ding en begin klein: schrijf je teamstandaarden op, maak één pipeline of review sneller, controleer of je back-up echt terug te zetten is, bepaal wat je met AI wel en niet laat doen, of praat in je team over wat je energie kost. Zoals meerdere sprekers adviseerden: begin klein, meet het effect en bouw van daaruit verder.